Cursor Changelog精选6060
Cursor上线与智能体的实时语音通话
Cursor推出Voice Chat,用户可与智能体进行实时语音通话,口述改动需求、询问智能体正在做什么,并听取进展更新。
推荐理由: 官方说明了语音通话在哪些端可用、如何与编码智能体分工,读者可据此判断它适合哪些协作场景。
Cursor Changelog精选6060Cursor推出Voice Chat,用户可与智能体进行实时语音通话,口述改动需求、询问智能体正在做什么,并听取进展更新。
推荐理由: 官方说明了语音通话在哪些端可用、如何与编码智能体分工,读者可据此判断它适合哪些协作场景。
 LangChain Blog精选7272
LangChain 在 Deep Agents 中推出异步子智能体,由常驻的编排智能体对接用户,子智能体在后台并行执行长任务并在完成后回报结果。
推荐理由: 原文给出异步子智能体的五个管理工具与通知机制,可据此判断长任务并行的工作流怎么搭。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
Cursor Changelog精选7878Cursor 推出 Live Apps 功能,用户描述需求后由云端智能体搭建 Web 应用、按需启动 Postgres 数据库、接入 Cursor SSO 鉴权并完成托管部署,发布后生成可分享链接。
推荐理由: Cursor 将建站、数据库、鉴权和部署纳入云端智能体,读者可据此判断内部工具的开发门槛会降到什么程度。
 Mistral AI精选7575
Mistral 发布 Mistral Large 4(代号 Le Chonk),主打编码、防御性网络安全和复杂文档推理,同时扩展企业平台 Mistral Studio,新增托管智能体、应用、工作流能力以及企业上下文、智能体可观测性和评估功能。
推荐理由: 原文给出托管智能体、工作流、应用三类能力与部署选项,读者可据此判断企业智能体落地方式。
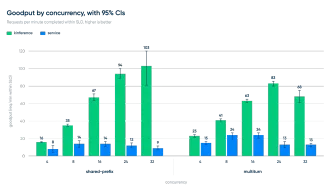
vLLM Blog精选7171Buoyant 发布开源项目 Kinference,作为 vLLM 与 Kubernetes 之上的推理控制平面,提供 token 限流、租户用量与成本追踪、KV cache 感知的负载均衡和推理策略。
推荐理由: 原文给出 KV 缓存感知负载均衡的基准对比和 YAML 策略示例,可据此判断推理平台的路由层如何设计。
 Databricks Blog精选6060
Apache Spark 4.3 发布并在 Databricks Runtime 19 中可用,Real-Time Mode 新增有状态处理,支持流式聚合、dropDuplicates 和 transformWithState。
推荐理由: 原文给出实时模式有状态处理的三项基准延迟数据和季度发布节奏变化,读者可据此判断流处理架构的取舍。
 AWS Machine Learning Blog精选6060
AWS 团队以开源多智能体数据分析方案 Deep Insight 为参考实现,把生产级 AI 智能体的上下文工程拆成四层:多智能体架构隔离上下文、用提示词限制输出、把重内容外置到文件系统、用验证智能体与兜底机制把关。
推荐理由: AWS 团队把上下文工程拆成四层,并给出开源参考实现中的具体代码与 token 节省数据,可直接对照改造自家 Agent。
vLLM Blog精选7575vLLM 宣布在 NVIDIA、AMD、Google TPU 和阿里平头哥真武 PPU 上 Day-0 支持月之暗面开源的 Kimi K3.1 Pro,该模型为 2.8T 参数(104B 激活)多模态 MoE,上下文 1M token。
推荐理由: vLLM 团队详述为 Kimi K3.1 Pro 做 Day-0 适配的工程取舍,含稀疏注意力、KV 缓存打包与 DCP 的具体数字。
 Together AI Blog精选7575
Together AI 发布了 Together Compiler(TKCC),利用高吞吐智能体持续为推理引擎生成优化方案,在 24 小时内于 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等前沿开源模型上实现 1.3-3x 的 TPS 提升。
推荐理由: 原文给出了持续编译在多个前沿模型上的吞吐提升和引擎启动耗时对比,可据此判断推理优化流程的变化。
 OpenHands Blog精选7171
OpenHands与Snowflake AI Research合作,让开发者用现有的OpenHands Agent harness直接进行强化学习后训练,无需在训练框架中重建harness。
推荐理由: 原文给出了用现有 Agent harness 直接做 RL 后训练的具体配置方式和代码定位实验,读者可据此判断训练与部署能否共用一套 harness。
 MarkTechPost精选7272
Vercel Labs 发布开源 CLI 工具 agent-desktop,让 AI 智能体在 macOS、Windows 和 Linux 上通过操作系统无障碍树读取并操作原生应用,而非依赖截图。
推荐理由: 原文对比了基于无障碍树的 agent-desktop 与截图式 computer use 在 token 消耗和光标占用上的差异,并给出自报数据。
MarkTechPost精选7171Microsoft Research 与 UC Berkeley 的研究团队发布开源成本控制器 TokenEconomizer,可在不改动模型权重和智能体代码的前提下降低编码智能体开销。
推荐理由: 原文给出插件在 277 个 SWE-Bench 任务上的成本降幅与 Pass@1 变化,可据此判断它对编码智能体工作流的影响。
 量子位精选7878
面壁智能的算子生成系统 ForgeKernel 在英伟达 B200 上从零生成 DeepSeek-V4.1 的 FlashMLA Prefill 算子,最终耗时 472 微秒,比 FlashMLA 的 518 微秒快 9.8%,全程 22.5 小时、42 轮迭代、32 个版本,使用 1 张 B200 和 22 个 GPU 小时。
推荐理由: 原文给出直播全程的迭代数据与昇腾三榜成绩,可据此判断算子生成从人工调优转向智能体自进化的路径。
 Factory News精选7878
Factory 发布 Droid 1.0,这是其智能体 harness 的大版本更新,默认启用程序化工具调用(Script 模式),模型可写 JavaScript 在沙箱中一次请求内执行数百次工具调用。
推荐理由: 原文给出 Droid 1.0 在 Terminal-Bench 4 上对比 Codex、Claude Code 等 harness 的成本与耗时数据,可用于判断 agent harness 的选型。
LangChain Blog精选6767LangChain 为 Managed Deep Agents 加入浏览器能力,开发者通过 define_browser 导出浏览器配置,即可让托管智能体读取页面渲染结果并点击操作。
推荐理由: 原文给出浏览器工具的接入方式、handoff 机制与 WebVoyager 实测数据,可据此判断托管智能体如何覆盖无 API 的网页任务。
LangChain Blog精选6767LangChain 发布 Managed Deep Agents v0.10,新增浏览器使用能力,让智能体操作没有 API 的网站,并支持异步子智能体在后台运行长任务。
推荐理由: 原文给出浏览器接管与异步子智能体两项能力的具体配置方式和交接流程,可据此判断智能体处理无 API 网站与长任务时的分工。
 Meta Engineering精选6666
Meta公布Catching JiTTests已在内部投入生产,用LLM为待合入的diff自动生成可执行测试,在代码落地前暴露行为差异
推荐理由: Meta 公开了 JiTTests 的生产部署细节与量化结果,可供评估 LLM 生成测试在超大规模代码库中的落地方式。
 Hugging Face Blog精选8585
Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Mistral AI精选8282Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。
推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。