REINFORCE Zero:对齐 kernel 让异步 RL 在 lag 64 下稳定训练
Zero Mismatch, Simple Async RL: REINFORCE Zero, DeepSeek-V4.1 and Kimi K3.1
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
简而言之
- 异步强化学习更快,但它使用由旧权重生成的样本进行训练。
- 从策略到学习者的差距有两个部分。权重滞后平稳变化,未裁剪的重要性采样(IS)控制它。核不匹配,即滚动和训练对相同权重计算不同的数值,会波动并持续存在,尽管有IS。
- 对齐核,未裁剪的IS纠正剩余的权重滞后,无需样本拒绝门。 REINFORCE Zero (NVIDIA Research and Inferact) 稳定地训练 20,000 次更新,学习在 策略滞后 64,达到 2.40× 具有对齐核的同步训练的训练步吞吐量。
- 零不匹配现在涵盖 DeepSeek-V4.1-Flash (DAPO 滚动步骤在快速基线的 10% 以内),Kimi K3.1 在第 0 天,以及 DeepSeek-V4-Flash 和 Kimi K3.1 在 AMD MI355X。
- 一切都在 Inferact/zero-mismatch-rl。
1. 从同步到异步
上个月,我们展示了 滚动和训练可以完全一致。在 DeepSeek-V4-Flash 上,vLLM 和训练器在快速核上对每个采样的标记产生了相同的 logprob,逐位逐字节,减少了 8.7% 的滚动吞吐量。现在代理技能为每个新模型执行对齐。
那篇文章是关于同步强化学习的,它没有权重滞后,所以零不匹配消除了滚动和学习之间的唯一差距。这篇文章是关于异步强化学习的,它更快但设计上是离策略的。零不匹配在那里仍然重要吗?
我们通过 NVIDIA Research and Inferact 的新论文回答这个问题 (Jian Hu 等人): REINFORCE Zero: Kernel Alignment Unlocks Stable Asynchronous RL with Importance Sampling。第 2 到 4 节中的所有数字都来自它。
2. 异步强化学习:更快,但离策略
在同步强化学习中,滚动和训练轮流进行,每个都等待另一个。异步强化学习同时运行它们:滚动持续生成,而学习者更新。
代价是 权重滞后。使用版本 v 的权重生成的样本在版本 k > v 时进行训练。差距 k − v 并不大:REINFORCE Zero 在数学推理上以滞后 2 和 8 运行,在代理工具使用上以滞后 64 运行。
因此,学习者总是在训练来自旧策略的样本。标准的校正方法是重要性采样 (IS):通过 π / μ 重新加权每个标记,即学习者对它的概率除以滚动在采样它时记录的概率。问题是这种校正是否覆盖了整个差距。
3. 两个表现不同的差距
学习者和滚动之间的 logprob 差距分为两个项:
log π_θk − log μ_v  =  (log π_θk − log π_θv)  +  (log π_θv − log μ_v)
                        weight lag                kernel mismatch
π 是学习者的计算,μ 是滚动引擎的计算。第二个项在相同权重 θv 处比较两者。
权重滞后平稳变化。它在最近的更新上望远镜,当每个更新很小时,它遵循一个平稳变化的策略轨迹。这是 IS 设计用来纠正的差距。
核不匹配波动。它取决于批次组成和数值执行,因此即使在滚动和学习者使用相同权重时,它也会引入波动。
图 1:重要性权重偏差 D3 的峰值到中位数比率,对数刻度,在 DeepSeek-R1-Distill-Qwen-1.5B 上的两个异步运行:具有对齐核的 REINFORCE Zero 和具有标准核的 IS。来源:REINFORCE Zero,表 2。
REINFORCE Zero 论文使用 D3 来衡量这一点,D3 是 w − 1 − log w 在 token 上的每更新平均,其中 w 是重要性权重。每个 token 的项在 w = 1 时为 0,并且随着 w 远离 1 而增长。对于对齐的核,D3 在其中值的 1.50× 处达到峰值:未裁剪的 IS 保持了剩余的权重滞后不匹配平滑和控制。对于标准核,它达到 442.54×:尽管 IS,大的重要性权重波动仍然持续。
所以首先移除核项。 然后剩下的是权重滞后,普通的未裁剪 IS 可以纠正它,没有截断,也没有拒绝门。
4. REINFORCE Zero
REINFORCE Zero 是第 3 节中遵循的配方。它有三个部分。
配方
- 对齐核。 展开和学习者对于相同的权重和 token 计算相同的 logprob,就像我们上次的帖子一样。核项正好为 0,所以任何剩余的差距都是权重滞后。
- 使用 token 级别的未裁剪 IS 纠正权重滞后。 展开已经记录了它采样的每个 token 的 logprob。学习者将其自己的概率除以记录的那个,并使用该比率:没有截断,没有过滤。
- 优化普通的 REINFORCE。 每个响应的优势是其奖励减去其组的平均奖励。token 在响应内被平均。没有价值模型,没有拒绝门。
对于 B 个响应的一批,A_i 是响应 i 的优势:
L(θ) = − (1/B) Σ_i (1/T_i) Σ_t A_i · π_θ(a_it | h_it) / μ_i(a_it | h_it)
这就是整个算法。
为什么使用未裁剪 IS
在固定历史中,通过精确比率 w = π / μ 对每个采样的 token 进行加权,使得预期更新等于当前策略下的更新。裁剪权重通常会引入偏差。
正确的平均梯度不足以稳定训练。在一个高斯模型中,论文推导出精确的更新误差,并表明不匹配会放大更新方差并缩小稳定步长范围,即使在无偏差的 IS 下也是如此:相同的步长在没有不匹配时学习,而在有不匹配时失去奖励。实验表明核不匹配是导致大波动(图 1)的来源,所以移除它允许未裁剪 IS 保持稳定。
没有对齐会发生什么
论文使用标准核运行相同的异步 IS:
- 第一个和最后一个 1,000 次更新之间,展开到学习者的中位数 KL 上升 83.33×,在线 AIME24 pass@1 从 34.27% 下降到 13.96%。对于对齐的核,它保持平稳。
- 裁剪前的最大梯度范数达到 38.27,而对于对齐的核是 0.0555。
- 添加一个序列门稳定训练,但在最后的 1,000 次更新中它拒绝 24.48% 的序列。REINFORCE Zero 拒绝没有。
在滞后 64 时学习
论文将滞后推到 64。使用 Qwen3-4B、Python 工具和 16K 上下文,REINFORCE Zero 在策略滞后 64 时训练:一个样本可以来自比学习者旧多达 64 个版本的权重。它通过 5,000 次更新保持学习:平均奖励从第一个 100 次更新中的 0.287 上升到大约 0.78,并且 AIME24/25/26 pass@1 在相同的运行中有所改进。
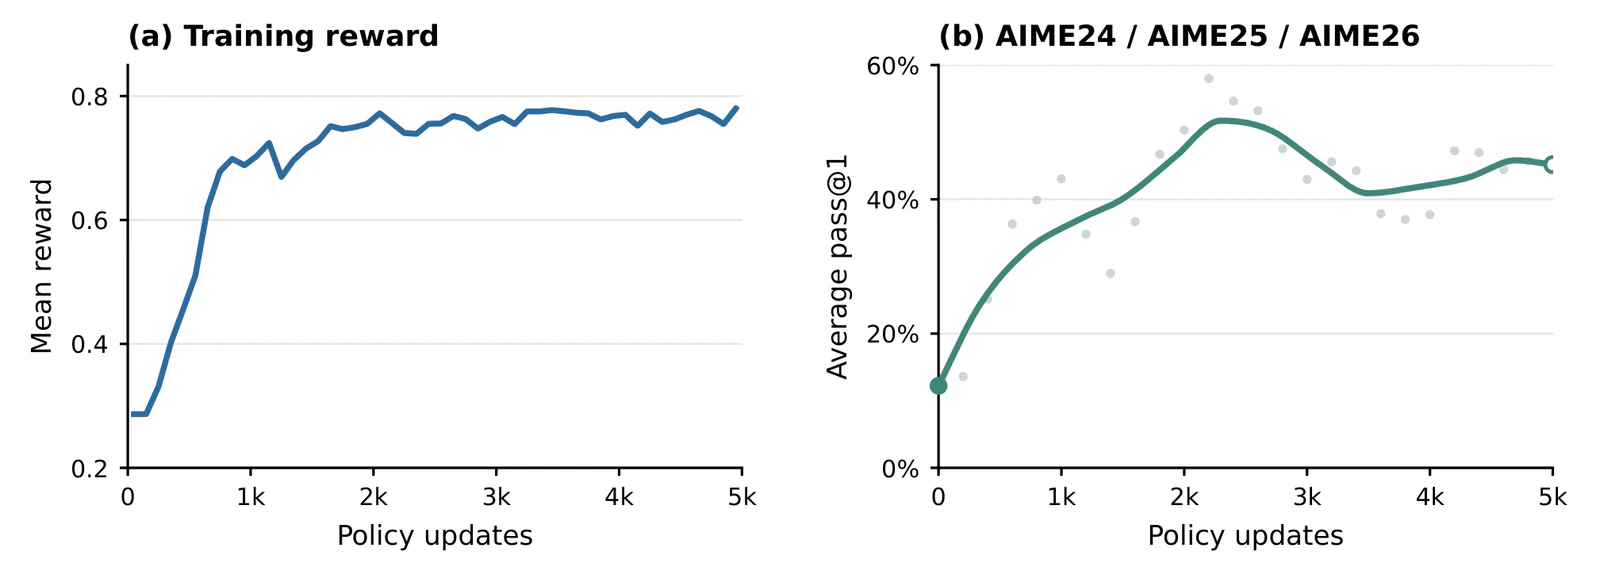
图 2 (REINFORCE Zero, 图 6):使用 Qwen3-4B 和 Python 工具在滞后 64 时通过 5,000 次更新学习。左:训练奖励,100 次更新的平均值。右:在 200 次更新的检查点处等权重 AIME24/25/26 pass@1(点)和平滑趋势(曲线)。
结果
| 设置 | 结果 |
|---|---|
| 吞吐量,16 个 GPU,12K 更新 | 2.40× 对齐内核的同步训练训练步吞吐量(68.55 小时 vs 164.77 小时),质量相当 |
| 20K 更新推理,DeepSeek-R1-Distill-Qwen-1.5B | 在滞后 2 和 8 时稳定; rollout-to-learner KL 保持平稳 |
| 高滞后,Qwen3-4B + Python 工具 | 通过 5,000 次更新在 滞后 64 处学习;平均奖励 0.287 → 约 0.78 |
| 带工具的 MoE,Qwen3-30B-A3B | 宏 pass@1 从 31.29% 提升至 3,000 次更新后的 71.55% |
| 计算机使用,Nemotron-3-Nano-Omni-30B 在 OSWorld 上 | pass@1 从 50.97% 提升至 428 次更新后的 56.16% |
在 6,000 次更新时的 1.5B 推理任务上,变体按分析预测的顺序排列:
| Recipe | 对齐内核 | 异步 | 宏 pass@1 |
|---|---|---|---|
| 基础模型 | — | — | 40.29% |
| 同步 | ✓ | 48.91% | |
| IS | ✓ | 45.32% | |
| IS + 序列门 | ✓ | 46.79% | |
| IS + 令牌门 | ✓ | 44.59% | |
| Score Centering,无 IS | ✓ | ✓ | 47.50% |
| REINFORCE Zero,滞后 2 | ✓ | ✓ | 48.80% |
| REINFORCE Zero,滞后 8 | ✓ | ✓ | 48.53% |
异步 REINFORCE Zero 与同步训练匹配。每个标准内核变体都落后,无论它使用哪种校正;使用对齐内核时,无 IS 的 Score Centering 处于两者之间。
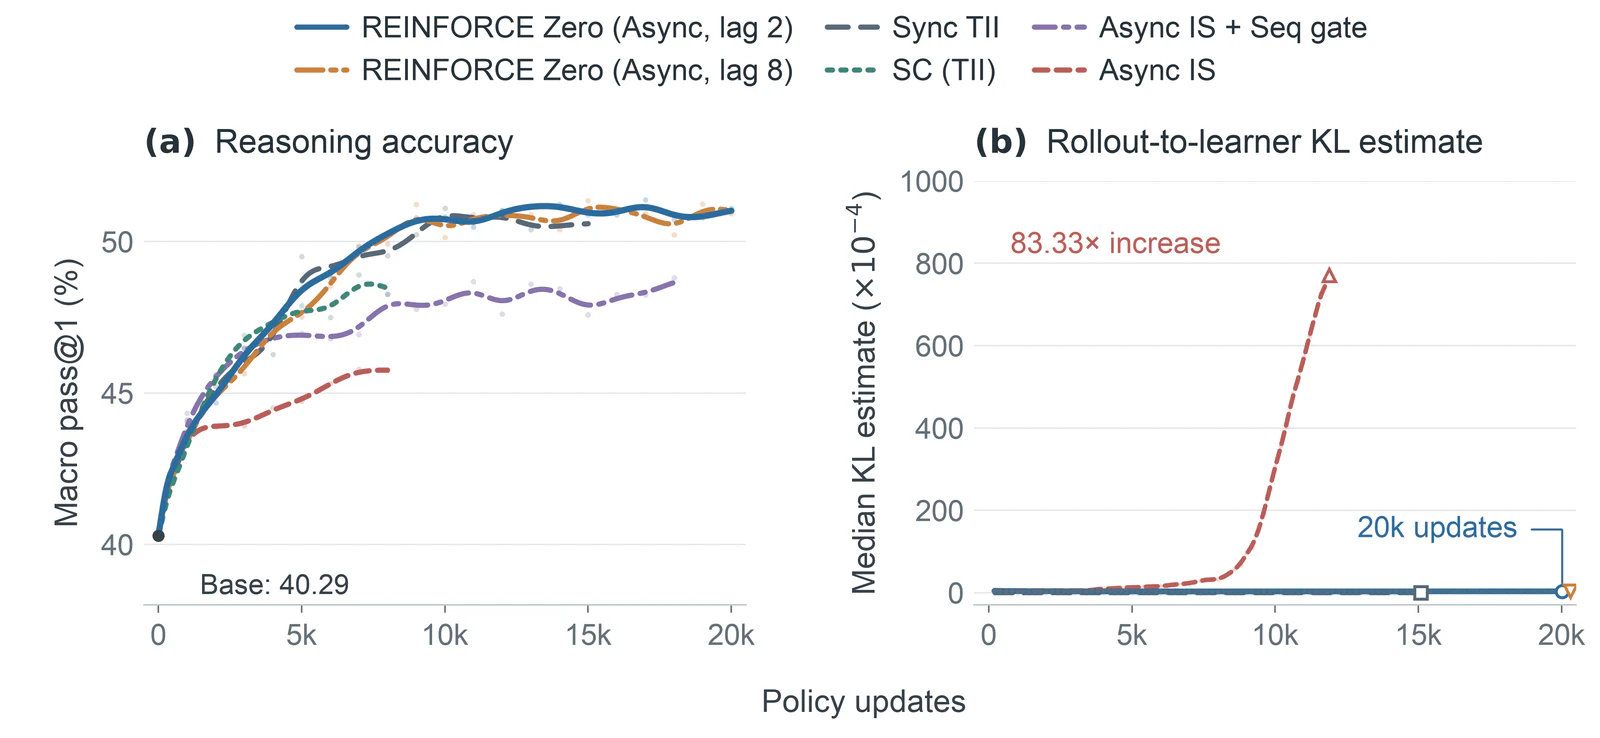
图 3 (REINFORCE Zero,图 1)。左:宏 pass@1。右:rollout-to-learner KL。标准内核 IS 向上漂移;REINFORCE Zero 在 20,000 次更新期间保持平稳。
这里的对齐成本是什么
对齐内核比最快的标准内核慢。在 OSWorld 上,REINFORCE Zero 的平均步长耗时 944.25 秒,而标准内核 IS 使用序列门耗时 884.17 秒,慢 6.8%。论文中的模型与我们上次帖子中的代理技能对齐;训练代码在 NVIDIA-NeMo/labs-molt 中。
5. 旗舰模型:DeepSeek-V4.1 和 Kimi K3.1
REINFORCE Zero 从对齐内核开始,每个新模型都带来新的对齐算子。自上次帖子以来,有两个旗舰版本达到了零不匹配:DeepSeek-V4.1-Flash,以及 Kimi K3.1 在发布当天。下面的运行验证了这些模型上的对齐;接下来将进行这些模型上的长时间异步运行。
整个过程中,diff 0 意味着 rollout 和训练器为每个采样的令牌计算相同的 logprob,逐位计算。
DeepSeek-V4.1-Flash,发布精度
一致路径始终保持端到端的发布精度:FP8 和 MXFP4 权重,MegaMoE,带滑动窗口的稀疏注意力,以及 DSpark 推测解码,使用 CUDA 图。Megatron-LM 训练器(mLite,由 NVIDIA DevTech 的 Yan Bai 开发)以相同的顺序调用 rollout 的内核。关键算子是带前缀缓存的滑动窗口:代理 RL 需要开启前缀缓存,并且缓存命中必须与缓存未命中给出相同的 logprobs。
在 16 个节点 × 4 GB200 上,SWE-bench Pro 代理 RL 在 128K 上下文中每一步都保持在 diff 0。对于 DAPO 数学 rollout,每个节点 128 条轨迹,响应最多 8K 令牌,一致 rollout 步长保持在快速基线的 10% 以内。
Kimi K3.1,发布日
Kimi K3.1 发布时带有 发布日 vLLM 支持,包含零不匹配的 RL。难点是 KDA 线性注意力:prefill 按块逐个令牌计算,解码和预填充的两次计算方式不同。现在解码重复预填充对同一块行的算术运算,因此预填充、解码和训练器就基模型和每个模块上的 LoRA 适配器达成一致。在 4 个节点 × 4 GB300 上,100 个 DAPO 步长使用 LoRA 保持 diff 0,AIME 24/25/26 平均@8 从 0.451 上升到 0.664。性能优化正在进行中。
6. 超越 NVIDIA:AMD MI355X
零不匹配是核的特性,而非某个供应商的特性。在 MI355X 上,正如在 NVIDIA 上一样,训练器的正向调用 vLLM 自己的模块和核,VLLM_BATCH_INVARIANT 在一致版本和快速版本之间切换。
DeepSeek-V4-Flash 在 4 个节点 × 8 个 MI355X 上保持了差值 0 共 36 个 GRPO 步,包括在恢复过程中。仅批量不变模式最初没有任何改变:二分法找到了十个批量差异的来源。一半是按形状选择核的库(hipBLASLt、AITER/CK、Triton、TileLang);其余的包括索引器的 top-k、使用与预填充不同的核进行解码,以及一个按到达顺序求和排名的专家并行组合。位保留优化将服务吞吐量损失从 62–66% 减少到 7.4–10.1%。配方和图片:verl#8505。
Kimi K3.1 在 2 个节点 × 8 个 MI355X 上运行 GB300 设置(每层包括专家的 LoRA r32,冻结的 MXFP4 基础)在每一步都保持差值 0,逐个检查标记。它需要两个修复:将训练器的 bmm 和索引器线性地远离 hipBLASLt,后者在 4,096 行和 4,097 行选择不同的瓦片;以及在唤醒后消除 KDA 状态槽写入的重复,其中驱逐和重用可以在一步中写入同一个槽。位保留的 MoE 路径将 RL 步从大约 2,300 秒减少到 1,350 秒;与快速基线的成本仍在测量中。配方和补丁:草稿 verl#8574。
7. 开源
REINFORCE Zero:论文和代码在 hijkzzz/REINFORCE-Zero,训练代码在 NVIDIA-NeMo/labs-molt。
Zero mismatch:Inferact/zero-mismatch-rl 持有代理技能,以及本文中每个模型的配方、出问题的地方、如何修复以及代码。
下文:在这些大型模型上的长时间异步运行,以及 Kimi K3.1 的性能优化。
致谢
感谢(按组织字母顺序):
- Verda,为 SWE-bench Pro 代理 RL 运行背后的沙盒
- The verl 团队
来源: vLLM Blog · vllm.ai