MarkTechPost6262
斯坦福研究开源 Memorilla,为冻结 LLM 开发潜在记忆模块
斯坦福研究人员开源了Memorilla,一个为冻结LLM设计的潜在记忆系统,它将整个文档集合转换为16个向量供冻结LLM使用。在FactKG上,冻结的Qwen3-8B配合Memorilla达到84.33%的准确率,比使用所有文档上下文高3.9%,但只需16个记忆token,文档token数量减少108倍。
MarkTechPost6262斯坦福研究人员开源了Memorilla,一个为冻结LLM设计的潜在记忆系统,它将整个文档集合转换为16个向量供冻结LLM使用。在FactKG上,冻结的Qwen3-8B配合Memorilla达到84.33%的准确率,比使用所有文档上下文高3.9%,但只需16个记忆token,文档token数量减少108倍。
MarkTechPost5858Vercel Labs 发布了 UI SDK,一个开源的 UI 行为库,专为 AI 编码智能体设计。该 SDK 提供 50 多种行为,支持 React、Vue、Svelte、Solid 和 Web Components,在 Vercel 测试中使智能体在设置任务上减少 69% 的工具调用,任务时间从 41 秒降至 16 秒,成本降低 56%。
 Liquid AI Blog3838
LiquidCodec 是 Liquid AI 开发的音频标记化技术,用于其最新的 LFM3-Audio-2B 和 LFM3-Omni-2B 多模态设备端智能模型,在 74M 参数规模下实现高保真音频重建与 1.1 kbps 压缩率,同时比同等规模模型在语音生成和 token-to-waveform 解码速度上分别提升 3.5 倍和 8 倍。
MarkTechPost精选同一件事 · 4 家8080Google 发布 Gemini 4 Hydrogen,一款面向编码与智能体任务的闭源模型,官方称其完成任务比 Gemini 3.8 Flash 快 2.5 倍。
 Hugging Face Daily Papers6565
决策模型即使作为行动者表现不佳,通过评判完整行动轨迹也能有效教授强化学习策略,在 ALFWorld 和 WebShop 上提升成功率。
Google 在 Antigravity 中上线 Gemini 4 Hydrogen,并新增 Orchestrator 模型选项,把 Hydrogen 与 Gemini 4 Carbon 等更强模型组合用于长周期任务。
 Ars Technica · AI精选同一件事 · 4 家8282
Google 发布 Gemini 4 Hydrogen,并已在自家产品中取代 Gemini 3.8 Flash,访问限制比此前 Argon、Carbon 更宽松,发布即可使用
 IT之家 · AI精选同一件事 · 4 家8787
谷歌正式推出 Gemini 4 Hydrogen 模型,面向日常编码和智能体工作流,输入每百万 Tokens 1.50 美元、输出 7.50 美元,覆盖 100 万 Token 上下文窗口且无阶梯计价。
 Codex releases00
GitHub Copilot 发布 0.170.0-alpha.3 版本,提供代码审查、安全漏洞检测和密钥扫描等功能。该版本适用于企业级用户,包含高级 AI 功能和 24/7 支持。
Hugging Face Daily PapersSteerDistill 通过闭环教师引导量化 LLM 智能体,在 W4A16 下平均分比最强量化基线高 1.67-2.18 分,在 τ^2-Bench 上成功率达 1.84 百分点,训练 GPU 小时减少 67%。
Hugging Face Daily PapersEmbodied First Exam 发布,包含 35 套、47 个机器人上的 1,156 个任务,评估编码智能体在物理世界约束下的控制能力,GPT-6 Astra in Codex 在标准设置下 456 个核心任务中成功率 34%。
Hugging Face Daily Papers6565MACaQ 是一种 MXFP4 W4A4 的后训练量化方法,通过在线激活变换和 Hessian 感知细化独立量化每个线性层,在语言和扩散模型中减少成本同时保持准确性。MACaQ 在 Qwen3-32B 上 vLLM 实现仅增加 2.3% 的端到端开销,比 DuQuant++ 和 MR-GPTQ 的困惑度更低,并在 11 倍更短的量化时间内达到 Llama-3-8B 的最佳困惑度。
 The Decoder精选同一件事 · 2 家8585
谷歌 DeepMind 发布 AlphaProof Code,一款符合安全规范的 AI 数学证明软件,并在四周内完成了通常需要数年才能在 Signal 加密协议上完成的验证工作。
推荐理由: AlphaProof Code 将形式化验证从理论设计推进到实际运行代码,四周完成通常需数年的工作,并给出人工复核比例。
 Claude · YouTube同一件事 · 5 家4242
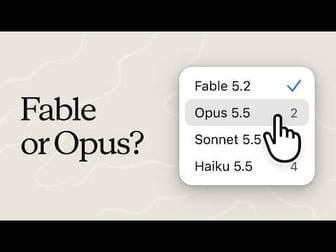
Claude Code 发布 Fable 5.2,用户需根据任务类型选择 Opus 5.5、Fable 5.2、Sonnet 5.5 或 Haiku 5.5,或跨模型分配任务;各模型可用性及使用限制因订阅计划而异。指南建议在复杂编码与知识工作、开放性技术任务、低成本限定工作等场景下分别选用对应模型。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Hugging Face Blog3838
Hugging Face 博客介绍了多向量嵌入模型的 Token Pooling 感知训练方法,通过 HierarchicalTokenPooling 将相似 token 嵌入合并以压缩存储。
Hugging Face Daily PapersTree-Ising 通过解决 BF16 参数上的稀疏 Ising/QUBO 问题修复大语言模型推理循环,以更少的权重编辑提升数学基准准确率且无需梯度或 LLM-token 成本。
 量子位
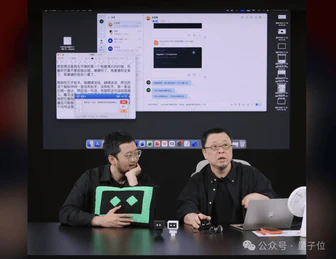
罗永浩在双11直播间展示全链路AI开发平台TRAE,用9.9元体验价生成短剧调研报告、PPT和语音输入法软件,引发大众对AI编程工具的关注。TRAE具备多文件感知和环境自动配置能力,能将抽象意图转化为代码和界面,降低开发门槛,已获全球1000万注册用户。
Hugging Face Daily PapersWorld In-Context Learning (WICL) 方法通过冻结模型,在模拟器中演练任务并将反馈写入上下文而非权重,使机器人能从单一演示中学习操作技能。RoboScript 实现了 WICL,在 RoboTwin 2.0 的 50 项任务上,单次演示无梯度更新即可达到 83.4% 成功率,超越最强训练策略 20 余点,并支持跨视觉分布泛化、通过反思改进、基础模型扩展及跨平台记忆迁移。
Hugging Face Daily Papers6565DexForesight 框架通过将动态感知的世界表示注入灵巧策略的潜在空间来隐式学习空间预见性,在 11 个 DexJoCo 模拟任务上使基础策略成功率从 49.4% 提升至 60.5%,在 3 个真实机器人灵巧操作任务上达到 58.3% 成功率。
 Latent Space6565
OpenAI 在 AI 工程师代码峰会上介绍了 Codex 的新工作方式,包括云功能改进、语音交互和智能体协作。Codex Cloud 2.0 允许用户在隔离实例中运行多个任务,但仍存在云功能易用性问题。语音模式作为控制平面可管理代码库,个人智能体 dots 可作为安全网、委托节点和无处不在的存在。
 AWS Machine Learning Blog
Moonshot AI 的 Kimi K3.1 Pro Highspeed 已在 Amazon Bedrock 上发布,该模型为 Kimi K3 的后训练版本。
Hugging Face Daily Papers删除调优方法通过将预训练大语言模型(LLM)中不到 0.05% 的权重置零,无需其他修改,即可在强化学习、监督微调和策略蒸馏三种后训练场景中达到与全量微调(FFT)相当的效果。
Latent SpaceNaive-N0.5-Flash 是 NaiveAI 开发的开源编码模型,通过改进 Xiaomi 的 MiMo-V2.5 并结合 NaiveRT 引擎实现每秒 2,100 个 token 的高吞吐量。
Codex releases00GitHub Copilot 发布了 0.169.0-alpha.9 版本,未提及具体更新内容。
 Factory News
安全工厂通过连接信号、分类和修复三个阶段,帮助工程团队将安全发现转化为测试修复。它整合了现有工具和上下文信息,自动协调调查任务,生成基于验证的风险优先级修复列表,简化了从发现到修复的整个过程。
 Google DeepMind精选同一件事 · 5 家8787
Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
MarkTechPost精选同一件事 · 5 家8282Anthropic发布Claude Fable 5.2和Claude Mythos 5.2,两者基于同一个底层模型,Fable 5.2增加了分类器拦截高风险网络安全任务和大部分生物学研究任务,Mythos 5.2去掉了这些限制,需要通过Cyber Verification Program和Life Sciences Verification Program访问。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Google DeepMind同一件事 · 2 家Google DeepMind 开源 AlphaProof Code 框架,用多 LLM 智能体首次实现广泛部署的 Signal 协议代码深层形式化验证,生成超 600 万行 Lean 证明,仅 1% 代码需人工复核,将专家团队数年工作压缩至四周,并成功识别出两处已知漏洞。
Hugging Face Daily PapersFrontier3DBench 统一评估了 145 项任务中代码智能体在对象、场景和交互式 3D 世界创建上的能力,GPT-6.1-sol 在对象和场景层表现最佳,总得分 66.02/100,但所有配置在对象和场景任务中参考重建得分均低于文本驱动生成。生成世界在局部机制上平均 83.08/100,但在运动清除和状态化工作流上仅分别为 20.82 和 30.26,显示协调活动完成仍是核心瓶颈。
Meta 推出 Muse Ember,其最小且最高效的模型,专为复杂推理执行设计,在智能与成本比上优于 Claude Haiku 5.5 和 GPT-6 Luna,每百万输入 token 成本 0.10 美元,每百万输出 token 成本 0.50 美元,支持 1M 上下文窗口和 512K 输出 token。
Hugging Face Daily Papers一种精确的瓦片注意力算法将加性相对位置项集成到类似 FlashAttention 的计算中,减少内存和计算开销,加速长上下文相对位置 Transformer。该方法(1)使用偏移感知瓦片避免冗余索引和内存访问,(2)仅计算必要的键/查询关系产品并在前向和反向传递中重用它们,以及(3)使用基于偏移的梯度分片和聚合,消除原子竞争。
Hugging Face Daily PapersOneTrans-GSR 通过单一自回归 Transformer 统一生成推荐排序列表,提升业务指标并减少重排序和混合排序延迟。在工业推荐系统中部署后,GMV/u 提升 2.63%,广告商价值提升 2.06%,回购率提升 2.03%,同时将端到端延迟降低 13%。
e-means 在 25 轮训练内达到低于 Lloyd 算法的测试损失,仅需 1.2 至 3 轮。与最先进的 Flash-KMeans 相比,GPU 端端速度提升 10-45 倍,CPU 端端速度提升 8-15 倍。e-means 通过指数移动平均更新、自动超参数调整、改进初始化和死簇复活策略,实现了速度和损失的双重优化。
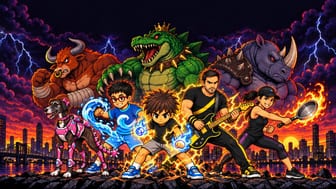
Claude Fable 5.2 可以一键从侄子的一组画作中生成完整游戏,包含 175 张图像和 140 个音频片段。生成的动作游戏包含 18 个角色、12 个关卡及剧情,支持 4 人联机,通过 Claude Code 和 Opus 4.8 实现。
IT之家 · AI同一件事 · 5 家Anthropic 发布了 Claude Fable 5.2 模型,编程能力在 FrontierCode 2.0 测试中达到 49.1%,超过 GPT-6 Astra 的 42.8%;在 Humanity's Last Exam 测试中得 74.2%,领先 GPT-6 Astra 的 57.2%。该模型输出速度最高提升 30%,成本下降 20%,API 调用费降至 $3/百万 tokens。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Hugging Face Daily PapersA2-MEAS 框架通过学习校正码和具身视觉语言行动模型提升机器人控制与故障恢复,在 50 任务 BEHAVIOR 2026 公开子集上达到 0.5755 Q-score 并实现 45.40% 任务成功率,12 项真实机器人任务平均成功率 57.92%。该框架采用动作预训练和任务专业化,训练吞吐量达 427.1 样本/秒,系统将开源模型、训练脚本及基础设施。
Codex releases00GitHub Copilot rust-v0.169.0-alpha.8 发布,该版本包含最新功能改进和修复。
Hugging Face Daily PapersPCBRouteAgent 在 247 块合成和真实 PCB 上实现 100%、94.9%、100% 和 40% 的 D2、D3-A、D3-B、D3-C 清洁通过率,在三个真实世界子集上分别比最佳基线高 13.9、36 和 10 个百分点。
AWS Machine Learning Blog同一件事 · 5 家Anthropic 在 AWS 上推出 Claude Fable 5.2 和 Claude Mythos 5.2,Fable 5.2 是其最强大的通用模型,适用于编码和科学领域,支持长达数天的无监督运行;Mythos 5.2 通过验证计划提供,在网络安全和生命科学领域表现更可靠。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
The DecoderMeta 发布 Muse Ember,其迄今为止最小且最高效的 AI 模型,专为处理 AI 代理日常的重复性任务设计,如调用工具、处理小规模编码任务、路由请求、提取数据和处理长文档。