量子位精选7272
天数智芯发布天垓300与彤央TY1200,现场实测对标英伟达H200和Thor T5000
天数智芯发布基于天枢架构的云端通用GPU天垓300和端侧产品彤央TY1200,并在现场随机出题与英伟达H200、Jetson Thor T5000对比。
推荐理由: 现场随机出题、云端与端侧双线对比英伟达,并给出可复现的实测数字与软件栈落地方式。
量子位精选7272天数智芯发布基于天枢架构的云端通用GPU天垓300和端侧产品彤央TY1200,并在现场随机出题与英伟达H200、Jetson Thor T5000对比。
推荐理由: 现场随机出题、云端与端侧双线对比英伟达,并给出可复现的实测数字与软件栈落地方式。
量子位精选7272Genspark 发布视频 Agent 工作台 Media Studio,接入 20 多家厂商的 70 多个模型版本,由大语言模型担任导演负责写剧本和调度视频、图像、音频模型。
推荐理由: 作者完整实测了从短剧到知识讲解片的全流程,读者可据此判断多模型编排在真实创作中的完成度与短板。
 The Decoder精选8080
Google 在 Android Dev Summit 上发布 Android Studio Rabbit 2,通过开源 Agent Client Protocol 支持在 IDE 内运行 40 多个编码智能体,包括 Claude、Codex 和 Google Antigravity。
推荐理由: Android Studio 开放第三方智能体接入,并给出 CLI 与 MCP 层面的配套改动,可据此判断移动开发工作流的变化。
 Artificial Analysis Articles精选7272
Artificial Analysis 在 Coding Agent Index v2.0 中实测 GitHub Copilot CLI 的 Copilot Fusion 最高档设置,其单任务成本为 5.59 美元,而 Claude Code 配合 Opus 5.5(max)为 11.42 美元,综合得分仅低 2 分。
推荐理由: Artificial Analysis 使用 Coding Agent Index 实测 Copilot Fusion,给出与 Claude Code 同等性能下的成本与 token 对比。
 IT之家 · AI精选7272
天数智芯在 10 月 28 日上海媒体开放日首次公开展示天垓 300 通用 GPU 实机运行,称其为国内首个实测性能达到英伟达 H200 水平的通用 GPU,第三方实测折算单卡整体吞吐为 H200 的 1.05 倍,但具体测试方法、模型负载和工作负载条件尚未公布。
推荐理由: 天数智芯首次公开天垓 300 实机运行,并给出与 H200 的吞吐对比及超节点成本测算,可据此观察国产 GPU 的落地进展。
 LangChain Blog精选7171
LangChain 介绍了其内部设计智能体 Content Studio 的搭建过程,该智能体在 Slack 中接收一句提示词即可产出视频、社交图、UI 图和幻灯片,所有素材均以代码生成。
推荐理由: LangChain 公开了设计智能体 Content Studio 的完整搭建过程,包括技能、wiki、检查门与异步子智能体的分工方式,可作为构建垂直 Agent 的参考。
 Google Developers Blog精选6666
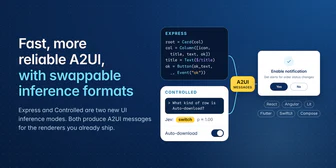
Google 为生成式 UI 协议 A2UI 推出可替换推理格式,并新增默认格式 A2UI Express,官方称相比 Direct JSON 延迟最多降低 3 倍、生成同等 UI 所需 token 最多减少 3 倍。
推荐理由: 官方给出可替换推理格式的接入方式与延迟、token 对比,便于判断生成式 UI 的工程取舍。
The Decoder精选7171Anthropic 表示,单个按需加载上下文的智能体在质量、成本和延迟上常优于多子智能体架构,并发布迁移工具包帮助团队评估是否合并子智能体。Anthropic 称从 Opus 4.5 起的新模型可在单一循环中直接管理复杂计划,一次对比中单智能体架构运行速度约为多智能体方案的两倍。
推荐理由: Anthropic 基于企业部署经验给出单智能体优于多子智能体的判断,并列出适用边界与迁移路径。
 MarkTechPost精选8080
Microsoft Research 开源了 Agensh,一个去掉中心编排器的多智能体框架,每个 worker 自行认领子任务、共享发现并合并代码到同一个 Git 仓库。
推荐理由: 原文给出无中心编排器的多智能体框架在 ProgramBench 上从 1 到 1024 个智能体的扩展数据,可对照现有编排式方案。
IT之家 · AI精选7575GitHub 用户 Zagitta 开发的开源项目 GPU Unlock 可解除安培架构消费级显卡在 FP16/BF16 张量核心运算中的指令发射速率限制,无需修改驱动或刷写 VBIOS。
推荐理由: 原文给出多张 RTX 30 显卡在 GEMM 与图像生成负载下的实测提升数据,也标明了显存带宽等限制。
 vLLM Blog精选6060
vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。
推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。
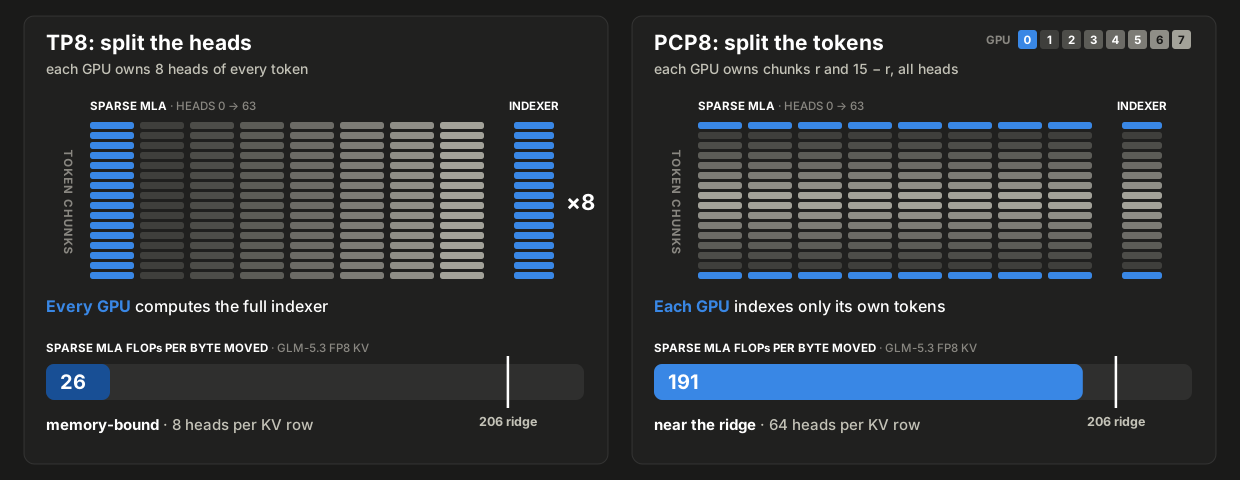
vLLM Blog精选6262vLLM 团队发布 GLM-5.3 优化第二部分,在 16 张 H200 上以 1 个预填节点加 1 个解码节点部署,用 PCP 按 token 切分预填、DCP 按 token 切分 KV cache,使 1M 上下文可放入预填节点
推荐理由: vLLM 团队拆解了 PCP、DCP 与 Hybrid HiSparse 如何在 16 张 H200 上组合,读者可据此理解长上下文部署的内存与预填瓶颈。
 Google Research精选6262
Google Research 在 IDWeek 2026 上介绍了其结核病筛查 AI 从研究走向临床的路径:2019 年在 Radiology 发布基准,2024 年在 NEJM AI 完成多站点前瞻验证,随后由 Nexus AI 转化为通过 CE MDR Class IIb 认证的临床工具。
推荐理由: Google Research 梳理了从影像基准到 CE 认证工具、再到开源 MedGemma 的完整路径,读者可据此了解医疗 AI 从论文走向临床要跨过哪些环节。
MarkTechPost精选7171Google Cloud 在 AGNTCon + MCPCon 上发布 Agent Compute Engine,为每个 AI 智能体会话分配一个硬件隔离的 microVM,沙箱内不存放任何凭证,客户预览计划在未来几个月开放。
推荐理由: 原文拆解了每个智能体独占 microVM、沙箱内零凭证的设计,并给出与 AWS、Azure、E2B 的隔离与空闲处理对比。
 Databricks Blog精选6060
Databricks 高管 Patrick 复盘公司全面采用 AI 编码智能体后成本指数级上升、再通过控制层把单位成本最多降低 90% 的过程。他提到把流量迁到更便宜的新模型贡献了 50% 以上降幅,Smart Router 在接近最贵模型质量下把平均任务成本降低 30% 以上。这套内部方案后来产品化为 Unity Gateway,目前已有数千家客户使用。
推荐理由: Databricks 高管复盘自家 AI 编码成本从失控到单位成本降九成的过程,给出网关、路由与自建评测的可迁移做法。
 NVIDIA Newsroom精选7676
NVIDIA 发布 OpenShell 参考架构,基于 OpenShell 安全运行时软件,整合 Vera Rubin 推理基础设施、Vera CPU 运行智能体框架、BlueField-4 DPU 上的 Sentry 安全框架,并可通过 RTX Spark、DGX Spark 和 DGX Station 延伸到边缘。
推荐理由: 原文给出了面向企业智能体安全运行的全栈架构组成与首批合作方,读者可据此判断企业级智能体治理的落地形态。
 OpenAI News精选6262
OpenAI与Google Cloud合作,将OpenAI前沿模型和Codex工作流接入Gemini的模型花园,并通过Google Cloud Marketplace提供
推荐理由: OpenAI 前沿模型与 Codex 工作流进入 Google Cloud 的 Model Garden,读者可据此了解跨云分发的新入口。
 NVIDIA Blog精选7272
Google Cloud 与 NVIDIA 宣布基于 NVIDIA Vera Rubin 的 A5X 实例正式可用,下月开放并计划扩展至欧洲。
推荐理由: 原文给出 A5X 实例的可用时间、客户实测与机密计算配套,读者可据此判断大规模强化学习基础设施的落地节奏。
NVIDIA Blog精选6767NVIDIA CEO 黄仁勋在 GTC Berlin 2026 主旨演讲中宣布多项更新,包括以模块化集装箱交付的 Vera Rubin AI 工厂参考设计 DSX POD,现场部署时间可从六个月缩短到 14 天。
推荐理由: 黄仁勋在 GTC Berlin 的主旨演讲集中披露了 AI 工厂、智能体安全运行时与开源模型三条产品线的最新进展,读者可据此了解 NVIDIA 在欧洲的布局重点。
 腾讯混元 · Hugging Face 新模型精选7878
腾讯混元在 Hugging Face 发布视频世界生成模型 Hy-Nomas,支持通过文本指令和相机控制进行自由形式的多轮交互,逐段生成视频并延续同一世界。模型采用分段自回归 DiT 架构,结合 Qwen2.5-VL-7B 文本编码器、相机条件模块和 PixelUMM 解码器,蒸馏推理配置为 8 步去噪、720×1280 分辨率、24 FPS。
推荐理由: 腾讯混元开源可多轮交互的世界生成模型,给出架构细节与单卡 4090 部署配置,便于评估落地成本。