Buoyant 开源 Kinference:面向 vLLM 与 Kubernetes 的推理控制平面
Introducing Kinference: An Open Source Inference Control Plane for vLLM and Kubernetes
Buoyant 发布开源项目 Kinference,作为 vLLM 与 Kubernetes 之上的推理控制平面,提供 token 限流、租户用量与成本追踪、KV cache 感知的负载均衡和推理策略。
原文给出 KV 缓存感知负载均衡的基准对比和 YAML 策略示例,可据此判断推理平台的路由层如何设计。
同一件事另外 1 家也报道了
各家口径不同:vLLM博客提到token限流、租户用量与成本追踪,而MarkTechPost明确指出token速率限制和按租户的指标。
- vLLM Blog··首发·当前阅读
Buoyant 开源 Kinference:面向 vLLM 与 Kubernetes 的推理控制平面
- MarkTechPost··+3 天
Buoyant 发布 Kinference:一个开源的 Kubernetes 和 vLLM 推理控制平面
新增信息:中位数TTFT从6.88秒降至0.31秒
按发布时间排列 · 事件后续出现时自动追加 · 由模型根据各家标题与摘要比对
我们很高兴宣布 Kinference [kay-inference],一个用于构建可扩展推理平台的新开源项目,使用 vLLM。
我们在 Buoyant 创建了 Kinference,因为我们看到我们的客户在他们的环境中运行开放重量模型时遇到了困难。我们设计了 Kinference 作为您需要构建的平台的管理平面层。它使用 vLLM 进行底层推理,并提供构建实际推理平台所需的功能集。这包括令牌速率限制、租户使用和成本跟踪、智能负载均衡和推理策略。
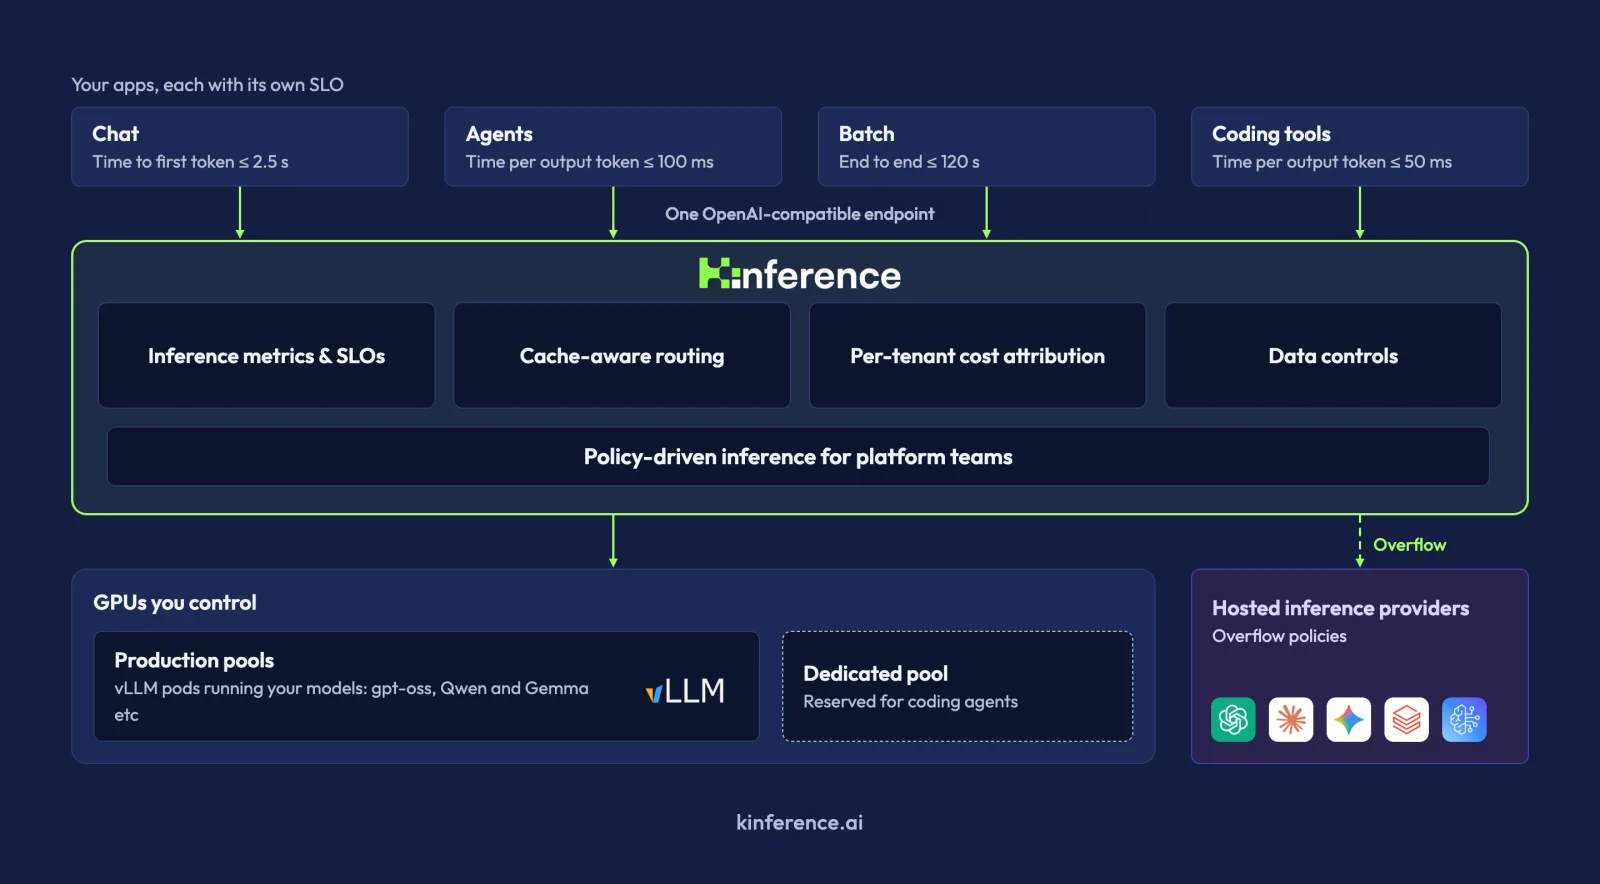
Kinference 可以与您现有的堆栈配合使用。使用 Kinference 只不过是将推理客户端指向其 HTTP 端点并发送 OpenAI 或 Anthropic 兼容的推理流量。
Kinference 为一组异构、不断发展的模型提供服务,这些模型运行在一组异构、不断发展的 GPU 池上,为异构、不断发展的客户端提供服务。
推理负载均衡和性能
除了策略和路由层之外,Kinference 还提供推理特定的负载均衡,它考虑了 GPU 队列大小、历史性能以及 GPU 上的 KV 缓存内容等信号。特别是这种 KV 缓存感知能力,允许 Kinference 将请求发送到 vLLM 工作节点,该节点将为该特定请求做最少的工作。
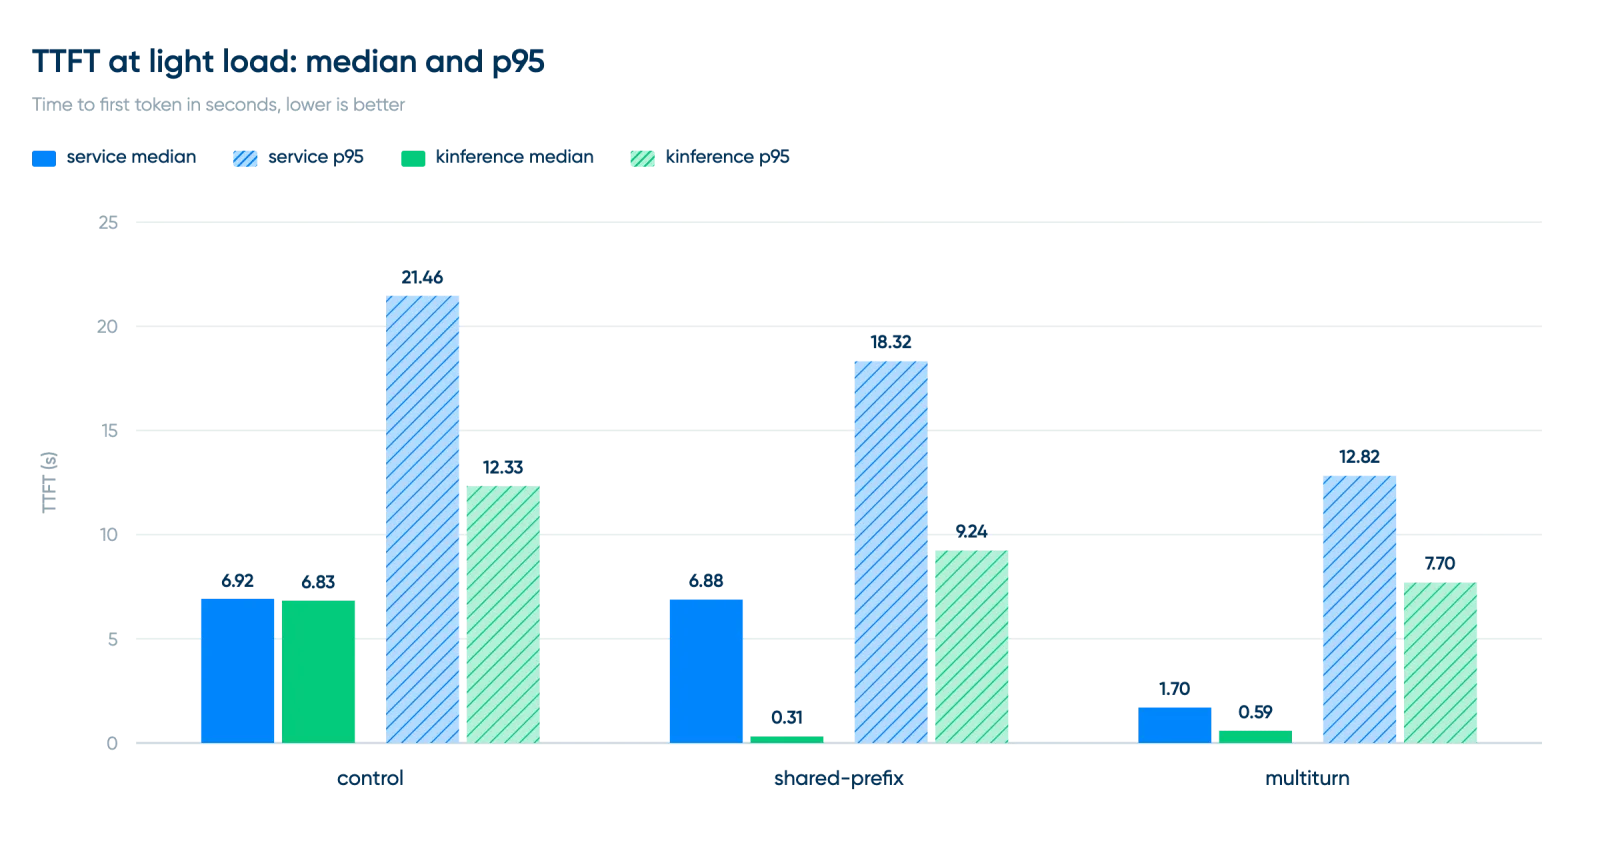
对 GPU 的 KV 缓存内容进行建模可以为分布式推理带来显著的性能提升。例如,在我们的 公开 Kinference 基准测试 中,我们表明,与标准的 Kubernetes 负载均衡(在下方标记为“service”)相比,Kinference(标记为“kinference”)能够将一种工作负载类型的请求的中位数首次令牌时间(TTFT)减少 95%,并将中位数端到端延迟减少 45%。
通过将缓存感知纳入策略,平台所有者可以创建策略,将简单请求发送到较便宜模型——但前提是,这比首先将它们发送到昂贵模型的工作量更小。
在我们的上述 空闲延迟 基准测试中,我们试图单独测量 Kinference 的 KV 缓存感知负载均衡的效果。在我们的 容量 基准测试中,我们测量了每个端点在延迟 SLO 内每分钟可以服务的请求数。
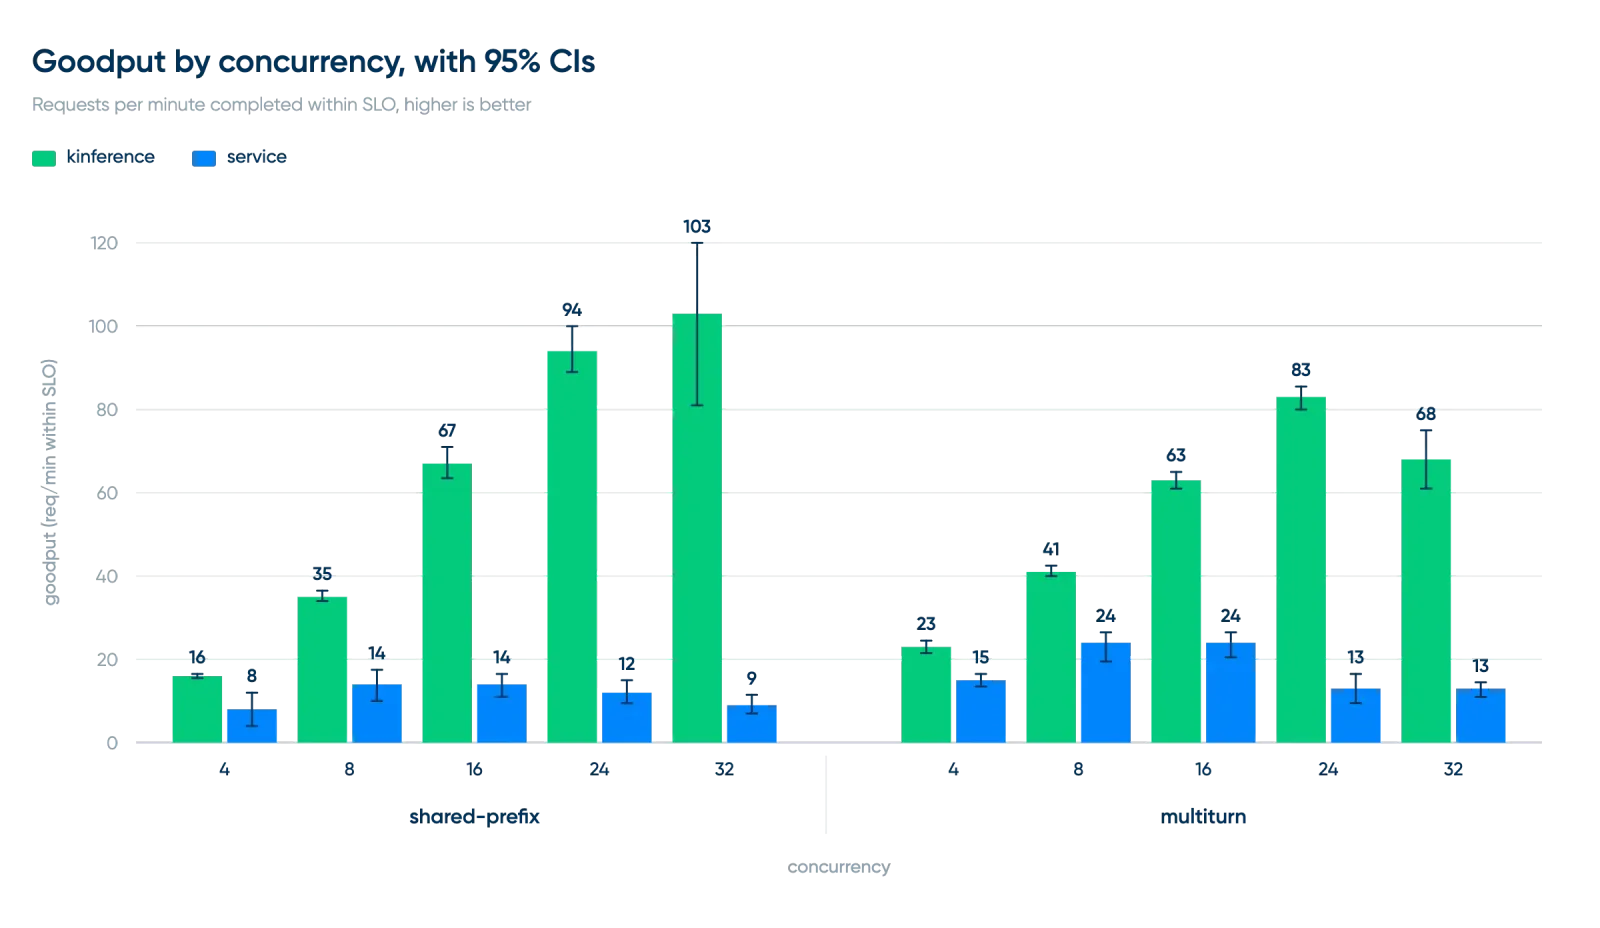
在容量基准测试中,Kinference 在共享前缀上服务了 7.4 倍的并发吞吐量,在多轮对话上服务了约 3.5 倍的并发吞吐量。它能够在并发 32(最高测量值)的共享前缀工作负载上达到我们选择的 SLO,在多轮对话工作负载上为并发 8,而 kube-proxy 方法在任何并发级别上都未能达到 SLO。
有关我们的基准测试设置、流程和发现的更多详细信息,请 此处 阅读。
基于策略的方法
Kinference 的核心是 推理策略 的概念。
推理策略允许平台所有者平衡使用、性能和优先级的权衡。我们观察到我们的客户处理了诸如以下问题:
- 我们如何允许用户不仅请求特定模型检查点(“Qwen 3.8,带有 27B 参数和 FP8 量化,请”)而且请求更广泛的模型类别,例如“任何 Qwen 3.8 模型”或“无论什么对编程都好”?
- 如何将“简单”的推理请求重定向到更便宜的模型,即使用户请求了一个昂贵的模型?我们又如何在不将整个提示历史发送到冷 GPU 并导致巨大延迟的情况下做到这一点?
我们不是构建一组一次性功能,而是在 Kinference 中构建了一个策略层,它可以表达所有这些功能——以及许多其他功能。
例如,这里是如何定义一个 YAML 策略,让 Kinference 根据复杂程度对提示进行语义分类,并将更简单的提示路由到更便宜的模型——除非,考虑到缓存使用情况,将其发送到昂贵的模型会更快。
apiVersion: kinference.buoyant.io/v1alpha1
kind: InferencePolicy
metadata:
  name: smart-semantic-routing
  namespace: inference
spec:
  rules:
  - name: low-complexity-consider-qwen
    matches:
    - model: glm-5.3
      tag: complexity-low
    route:
      consider:
      - models: { names: [ qwen-3.6-27b, glm-5.3 ] }
      select: [ { minimize: PredictedTTFT } ]
这里还有一个使用 Kinference 将多余的请求突发到云提供商端点(如 OpenAI、Anthropic、Databricks 等)的例子(当队列深度或缓存压力指示 GPU 已饱和时)。
apiVersion: kinference.buoyant.io/v1alpha1
kind: InferencePolicy
metadata:
  name: burst-policy
  namespace: inference
spec:
  rules:
  - name: burst-to-cloud
    route:
      exclude:
      - name: drop-overloaded-workers
        drop:
          backend:       { type: Local }
          queuedPrompts: { greaterThan: 2 }

      select:
      - { type: Local,
          minimize: PredictedTTFT }
      - { type: Provider,
          order: [bedrock, databricks] }
最后,这是一个策略的例子,它根据提示是否包含 PII 进行语义分类,如果 GPU 池饱和,则将请求突发到第三方提供者。
apiVersion: kinference.buoyant.io/v1alpha1
kind: InferencePolicy
metadata:
  name: pii-stays-local
  namespace: inference
spec:
  rules:
  - name: serve
    route:
      exclude:
      - name: pii-never-leaves-cluster
        if:   { tag: pii-detected }
        drop: { backend: { type: Provider } }
      select:
      - { type: Provider,
          order: [ databricks ] }
      - { type: Local,
          minimize: PredictedTTFT }
      onEmpty: Reject   # fail closed
有了推理策略,平台所有者可以根据租户、请求的模型、底层 GPU 池的状态、提示的语义分类以及许多其他因素,为推理请求创建明确的路由(或拒绝)规则。这些策略可以通过人工或代理进行审查;可以提交到 git;可以进行代码检查和验证;并且可以独立地应用或回滚。
我们认为这个策略引擎对于提供真正的推理平台至关重要。请参阅我们的 Kinference 策略文档 获取更多信息。
推理指标和 SLO
最后,平台所有者有一套全面的推理相关指标可供监控、发出警报并围绕它们构建 SLO。Kinference 报告系统上的活动情况,包括其自身的健康状况,以及:
- 输入和输出的令牌速率,以及输入和输出令牌大小的直方图
- TTFT、ITL 和 E2E 延迟直方图
- 未缓存与缓存的提示令牌,用于成本估算
- 模型使用情况、GPU 饱和度等
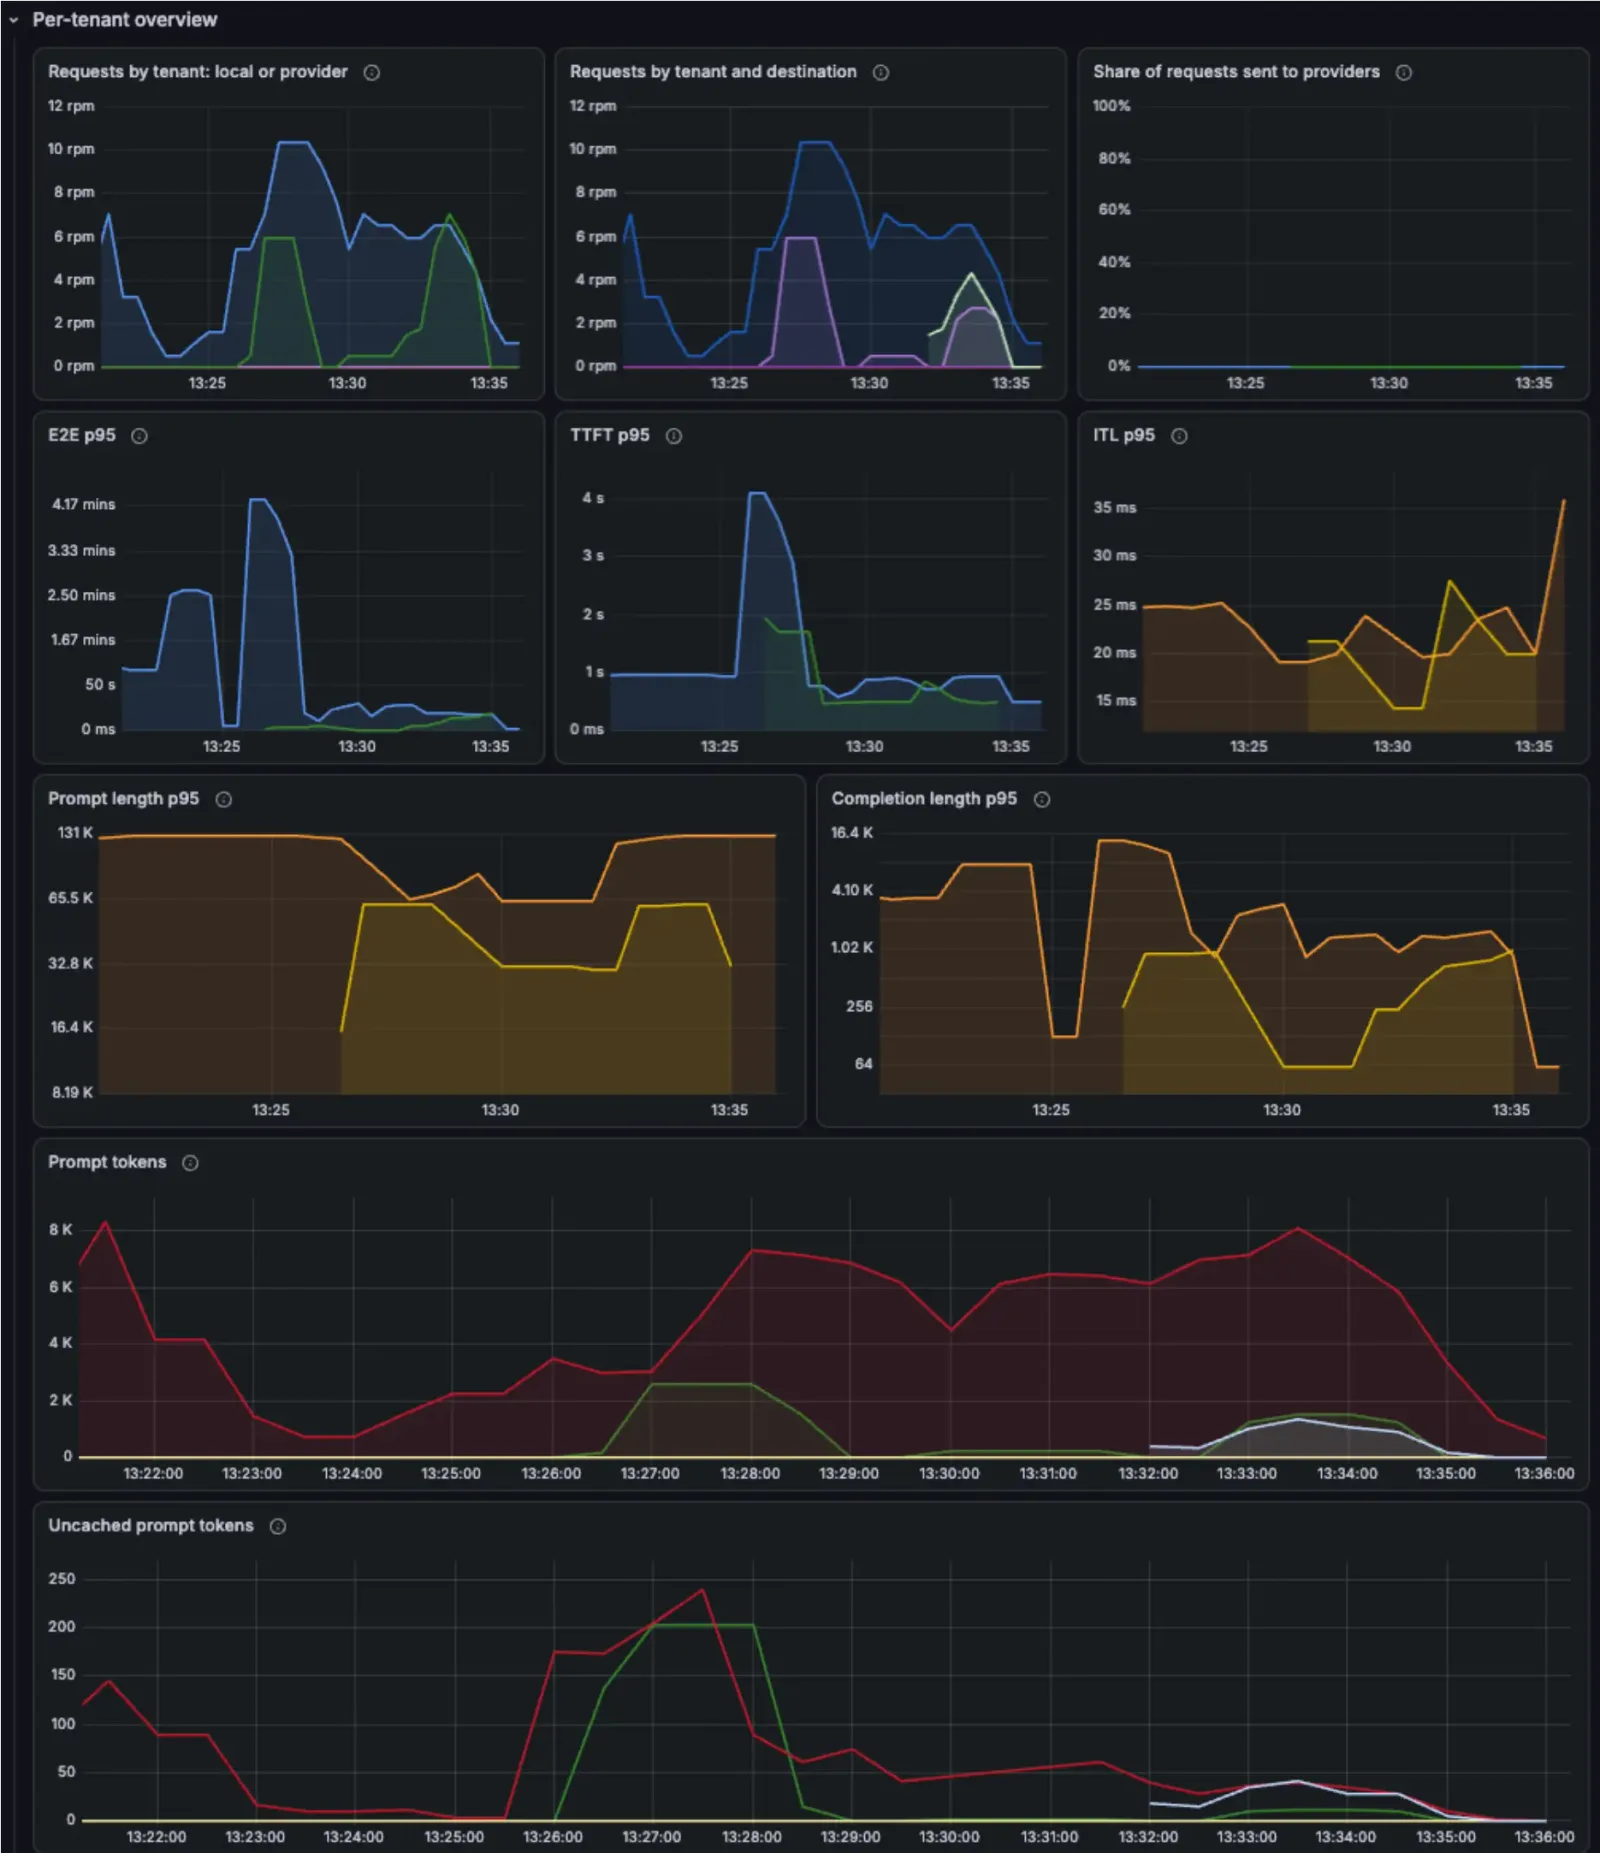
几乎每个指标都可以按租户划分,因此您可以跟踪租户使用情况,针对特定租户的性能构建特定的 SLO,以及您可能需要确保您正在构建的平台满足其要求的一切。
今天就开始使用
入门很简单:
01 安装 Gateway API CRDs
注意:此指南将 Kinference 安装到 default 命名空间中。要安装到不同的命名空间,请覆盖以下 helm 命令中的命名空间。
第一步是安装 Gateway API CRDs,它们提供了处理流量的标准机制。
GWAPI_VERSION=1.5.1
kubectl apply --server-side --force-conflicts -f https://github.com/kubernetes-sigs/gateway-api/releases/download/v$GWAPI_VERSION/standard-install.yaml
02 安装 Kinference 网关
Kinference 有两个基本组件:一个流量网关和一个推理处理器。每个组件都是独立发布的,并将其 CRDs 作为单独的图表发布,在组件本身安装之前安装。
安装网关 CRDs 和组件:
helm upgrade -i gateway-crds \
  oci://ghcr.io/buoyantio/charts/gateway-crds \
  --devel

helm upgrade -i gateway \
  oci://ghcr.io/buoyantio/charts/gateway \
  --devel --wait
03 安装 Kinference
现在,安装 Kinference 和 Kinference CRDs:
helm upgrade -i kinference-crds \
  oci://cr.kinference.ai/kinference-ai/charts/kinference-crds \
  --devel

helm upgrade -i kinference \
  oci://cr.kinference.ai/kinference-ai/charts/kinference \
  --set extension.enabled=true \
  --devel --wait
04 确保它正在运行
kubectl get pods验证进程是否正在运行:
NAME                           READY   STATUS    RESTARTS   AGE
gateway-cp-566cddc46d-jsqlq    1/1     Running   0          8s
kinference-7bb854cfc5-pp4t7    1/1     Running   0          8s
请始终参考最新的文档 http://kinference.ai/docs/,因为这些步骤将随着时间的推移而演变。
Kinference 是在 Apache v2 下完全开源的。它今天可以在 GitHub 上获得。非常欢迎来自其他部署的反馈、问题和基准报告。
来源: vLLM Blog · vllm.ai