The Decoder
Anthropic建议Claude Opus 5.5用户摒弃过时的提示词习惯
Anthropic建议使用Claude Opus 5.5的用户摒弃过时提示词习惯,如“think hard”,因该模型已能自适应推理深度,这些词语无实际作用且影响响应速度。Anthropic推荐从“Medium”努力级别开始,其内部测试显示该级别性能与Opus 5的“High”级别相当,且更高设置未必带来更好结果。
The DecoderAnthropic建议使用Claude Opus 5.5的用户摒弃过时提示词习惯,如“think hard”,因该模型已能自适应推理深度,这些词语无实际作用且影响响应速度。Anthropic推荐从“Medium”努力级别开始,其内部测试显示该级别性能与Opus 5的“High”级别相当,且更高设置未必带来更好结果。
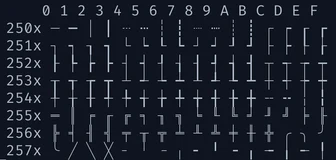
终端协议通过在单元格边缘绘制细线替代传统边界字符,实现不占用额外行列空间的边界绘制,其演示应用在 Ratatui 中支持多种场景,包括面板、菜单、图表等,且边界可自定义样式与连接方式。
 IT之家 · AI
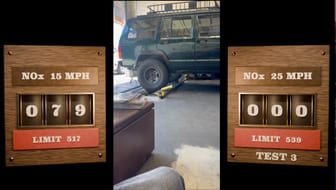
穆罕默德·祖拉利借助 Claude 和 Arduino Nano 开发板,成功让一辆1994款Jeep切诺基通过加州尾气检测,该车因特定车速下氮氧化物排放超标多次未通过。Claude 负责指导,Codex 负责写代码,最终通过调整发动机参数解决排放问题。整个过程只需一块3美元的Arduino开发板和不超过15美元的电子元件,项目已开源。
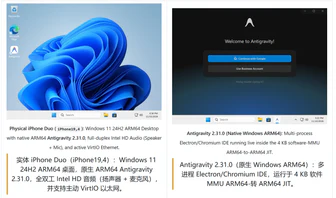
IT之家 · AI谷歌 AI Studio 产品与设计负责人雷希用 Gemini 4 Carbon 模型开发 WindowsiOS 项目,通过虚拟机在 iPhone Duo 上运行 Windows 11 on Arm 24H2 系统镜像,支持触控操作。项目开源,需 Mac、开发工具及 Windows ARM 镜像部署,可尝试运行部分传统 Windows 应用但兼容性未保证。
 AWS Machine Learning Blog
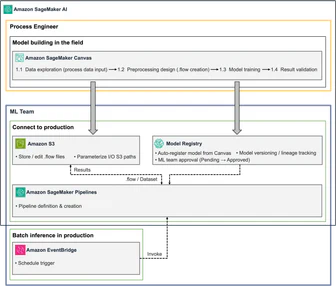
GS Caltex 通过 Amazon SageMaker Canvas 让流程工程师无代码构建和验证模型,再用 Amazon SageMaker Pipelines 配置部署和定时推理,ML 工程师将 SageMaker Canvas 资产转移至 Pipelines 只需几小时,部署模型版本和执行历史由 Pipelines 管理,实现每 30 分钟批处理推理并降低推理成本。
 NVIDIA Technical Blog5555
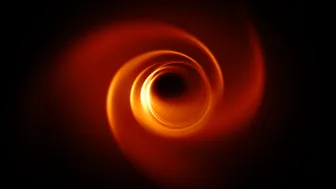
使用 NVIDIA cuPhoton 可实现黑洞干涉测量,M87* 的观测环仅 42 微弧秒。黑洞本身不发光,望远镜捕捉到事件视界外炽热气体的射电发射,黑洞的强引力弯曲光路形成亮环,NVIDIA cuPhoton 通过 GPU 加速相关计算。
NVIDIA Technical Blog6565NVIDIA Jetson AGX Orin 通过 cuDLA 可在 Python 中运行原生 DLA 推理,支持在 DLA 硬件上执行特定神经网络操作以卸载 GPU 推理任务,提升边缘端应用的能效。
AWS Machine Learning BlogAssemblyAI 通过混合使用 AWS 的 EC2 On-Demand 和 Spot 实例,并利用 Amazon ECS、SQS 和 EventBridge 构建弹性架构,以 3.5 倍的速度提升 GPU 实例利用率,在欧洲 AWS 区域内实现成本降低并满足服务等级协议(SLA),其推理平台部署在 g4dn、g5、g6 三种 GPU 实例家族上。
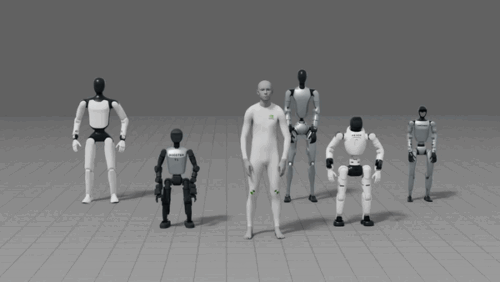
NVIDIA Technical Blog6565NVIDIA SOMA Retargeter 可通过人类动作演示为机器人教学提供协调和时序参考,但需适配机器人不同的关节结构和活动范围。该工具能自动调整人类动作以匹配机器人特性,帮助开发人形机器人。
IceWM 4.1.0(2026-08-06发布)是一个注重速度、简洁且不干扰用户的X Window系统窗口管理器,支持任务栏、全局及窗口级快捷键、动态菜单,可通过键盘鼠标管理窗口,提供多种可选焦点模型和主题,适用于Debian、Ubuntu等主流Linux发行版及BSD系统。
IT之家 · AI6565开发者借助AI和模拟器技术让尘封15年的iOS 4卡片式多任务切换界面重见天日,该界面此前仅在2011年的iPhone 4原型机上被发现。开发者通过提取原型机根文件系统并利用ChatGPT辅助QEMU模拟器启动,展示了以卡片形式排列的应用九宫格布局及连按两次Home键切换应用的交互方式。
 量子位
openJiuwen推出RSI原生AgentOS,通过扩展包实现Agent自我改进与功能迭代,支持界面、网关、服务端及Agent行为的定制化修改,WorkSwarm应用可动态加载系统插件以增强功能。
IT之家 · AI网友使用已停产的英特尔傲腾持久内存,在不配备显卡的情况下成功运行 2.8 万亿参数的 Kimi K3 模型,初始生成速度约为每秒 0.85 词元,关闭 DAX 功能后提升至每秒 1.50 词元。3 比特量化测试仅达每秒 0.75 词元,生成 5 万词元需 18.5 小时。
smolmaxxing 项目通过定制内核、优化内存使用和从闪存流式传输权重,使大语言模型能在小米电视盒子、iPad Air 等老旧设备上运行。在小米电视盒子上,Qwen3.5-2B 模型每秒处理 7.7 个 token,Ling-mini-2.0 模型每秒处理 5.1 个 token。更多设备支持即将推出。
 OpenAI News
Amplitude 的产品智能体 Wave 主要基于 OpenAI 模型,能主动识别开发方向,协助团队通过编码智能体快速部署变更,并评估影响效果。
 GitHub Blog · AI & ML5858
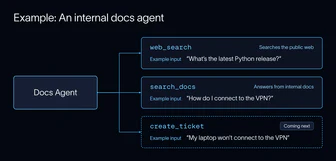
Agent技能允许捕获可重复指令供用户和智能体复用,通过以SKILL.md文件为中心的版本化目录定义任务执行时机与方式。Proof Agent使用独立验证器对抗性验证AI生成内容,Data Forge则通过多个协同技能构建支持台指标管线,各技能共享通过manifest定义的上下文而非独立重发现。
AWS Machine Learning Blog亚马逊 Bedrock 推理的请求级选择仍会改变服务处理的 token 数量和应用税率。缓存持续时间、服务层级、推理努力和 maxTokens 可在不改变模型或提示的情况下影响成本。每个选择取决于模型和工作负载,可通过响应元数据、日志和账单数据验证其效果。
 vLLM Blog精选6060
vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。
推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。
 36氪 · AI6565
SYNAPUFF 完成数百万元种子轮融资,开发面向 AI Native 终端的交互智能基座,让智能体具备理解情境、判断互动边界和动态调整行为的能力。公司提出“P Framework”,通过“试探—接收反应—决策”的交互闭环,结合互动动态模型、人格策略和非文本语言动作生成模型,形成独立适配不同终端的交互决策框架。
 Claude · YouTube3535
旅野森玛丽ko 用 Claude 编写代码创作了计算机生成动画,并以此呈现为新的视频装置作品《所有闪耀的光芒》,该作品于 2026 年 10 月 31 日至 2027 年 3 月 28 日在 Mori Art Museum 的回顾展 Mariko Mori: All That Shines 中展出。
 OpenRouter Blog
自托管 LLM 仅在 GPU 负载足够高时才比 API 便宜。以 2026 年 10 月 8 日价格为例,27B 模型在租用 RTX 3090 上需 6-12% 负载才与 API 平衡,而 DeepSeek V4.1 Flash 在四台 H200 上永无平衡点。
OpenRouter BlogOpenRouter Agent SDK 通过启用 doom-loop 检测,在测试的六种模型中,当收到第三次相同的工具调用时阻止无限循环;结合 stepCountIs(40) 和 maxCost(x) 可限制运行步数和成本;API 密钥的信用额度可控制总支出,这些措施有效减少了工具调用次数(从 314 次降至 64 次)和费用(从 $0.29 降至 $0.05)。
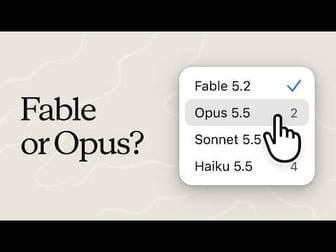
Claude · YouTube4242Claude Code 发布 Fable 5.2,用户需根据任务类型选择 Opus 5.5、Fable 5.2、Sonnet 5.5 或 Haiku 5.5,或跨模型分配任务;各模型可用性及使用限制因订阅计划而异。指南建议在复杂编码与知识工作、开放性技术任务、低成本限定工作等场景下分别选用对应模型。
 Amazon Science
亚马逊网络服务使用其自动化推理工具Tiros验证网络隔离,通过将网络配置转换为逻辑命题并分析模型中的可能路径,检查隔离是否符合声明策略,替代了传统的动态采样方法。
AWS Machine Learning Blog精选6060AWS 发布开源框架 UAEF,用适配器将 LangGraph、LangChain、Strands Agents、Amazon Bedrock AgentCore 和 Langfuse 的执行轨迹统一为 AgentTrace,再用 7 个维度 36 项内置指标打分。
推荐理由: 原文给出跨框架统一评测的适配器与指标设计,读者可据此判断多框架智能体版本对比的落地方式。
 TechCrunch · AI
Plurai 公司通过模拟企业数字系统生成的合成数据,提升 AI 智能体处理复杂任务的可靠性,其平台与 Claude Code、Codex 等工具配合,并利用收集的数据对小型开放权重模型进行后训练,在合作测试中成本低于中端前沿模型。
36氪 · AI2525WISE大会将举办华硕天选60min极速黑客松,招募3支队伍共6人参与限时创作挑战,使用华硕天选电脑在60分钟内开发AI作品并现场展示,获胜团队将获得天选Air 2026笔记本电脑。报名需提交作品链接、说明及简历,通过初筛和面试的队伍将参与11月27日的现场活动。
IT之家 · AI同一件事 · 2 家6565开发者 Simon Willison 借助 Claude Code 开发声音定位系统 Beep Locator,可将声源锁定至约 40 厘米范围;系统通过比较声音抵达不同设备的时间差定位,并利用快速傅里叶变换识别目标提示音;项目代码已开源。
 NVIDIA Blog
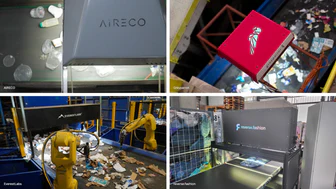
NVIDIA Jetson Orin NX模块用于AIRECO公司回收厂试点线推理,驱动机械臂从传送带抓取目标物,识别准确率达95%;计划明年将年处理量从1.8万吨提升至4.8万吨,运营成本降低85%。
OpenRouter Blog精选7070OpenRouter 发布了教程,讲解如何读取 429 响应头并按 limit_source 判断限流来源,给出了重试、模型回退、供应商故障转移三种修复方式。
推荐理由: 作者用同一批 60 条请求实测三种 429 处理方式,给出耗时与成本对比,可直接迁移到自己的重试逻辑。
 Sierra Blog3535
Sierra 设计师使用 AI 在两周内完成 Mossy 项目,该项目旨在设计一个可见的语音助手。
OpenRouter BlogOpenRouter测试了三种从LLM获取结构化输出的方法,在九个支持结构化输出的模型和仅支持工具的GLM 5.3 FlashX上验证,其中209/216的回复匹配严格JSON Schema。
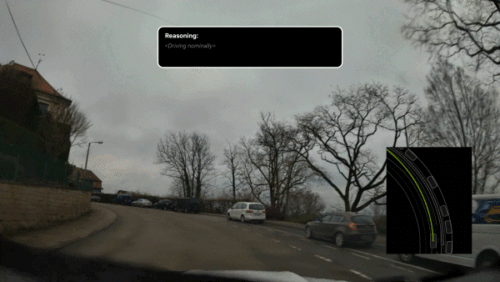
NVIDIA Technical Blog6565NVIDIA Alpamayo 2 Edge 边缘推理模型可在车载计算与延迟限制内运行。该模型在 MMLU 基准上达到 70.5 分,支持 8k 上下文窗口,速度提升 3.5 倍,价格为 $3/百万 tokens,闭源部署。
 LangChain Blog
LangChain通过评估驱动开发(EDD)改进AI智能体,定义智能体行为标准后构建评估,调整代码并对比结果。EDD借鉴测试驱动开发(TDD)理念,针对非确定性输出的智能体,通过评估指标衡量性能并指导开发。具体步骤包括:定义智能体行为规范、构建包含输入和参考输出的测试数据集、编写代码或LLM评估器检验行为是否符合预期。
OpenAI News5050OpenAI Academy 将为美国五大城市的照护者提供免费 ChatGPT 实战工作坊,帮助他们掌握日常生活中的实用 AI 技能。
用户开发了一个浏览器端工具,输入地点即可查询过去 7 天内所有经过该地的卫星及其拍摄的真实影像(Sentinel-2/Landsat/NASA),通过 GPU 渲染约 1.7 万在轨物体并实时计算开普勒方程实现高精度定位。该工具仅展示真实卫星拍摄数据且不存储用户位置。
 Simon Willison同一件事 · 2 家6565
Claude Code 构建了 Beep Locator 软件,通过多设备三角定位法探测房间内间歇性响声的来源,设备间通过播放声音互相定位,最终将响声定位在约 40cm 范围内,帮助用户找到响声源头。该系统运行 Python Web 应用服务器,利用 WebSockets 协议连接设备,设备通过麦克风录制 60 秒音频并检测响声,通过播放特定声音进行时间差测量实现定位。
 Browser Use
1Password 通过服务账户与 Browser Use 连接,可自动填充密码和 TOTP 代码完成网页任务。创建专用密码库并配置服务账户的只读权限,使用 Browser Use 令牌连接后,运行登录任务可验证认证页面。集成需为每个项目配置一个活跃的 1Password 连接,并区分服务账户令牌、库 ID 和 Browser Use API 密钥。
 Meta Engineering3838
LLDB 通过 lldb-server 的中立加速器插件架构支持跨 CPU 和 GPU 的应用调试,将通用调试基础设施与硬件特定设备控制分离,将 CPU 和 GPU 呈现为独立的调试进程,在单一调试会话中协同工作。该架构通过插件将硬件特定调试 API 转换为 LLDB 理解的概念,支持不同架构、寄存器、内存空间和执行模型的 CPU 与 GPU 协同调试,同时保持客户端的中立性。
IT之家 · AI6565工程师 IainKay 开发开源脚本 Ram-Altman,通过 Linux 系统监控电脑内存使用,当可用内存超过总容量的 10% 时,每天自动向 OpenAI CEO Sam Altman 发送邮件汇报闲置 RAM 量,并准备了多种邮件主题、正文和署名。该项目已上传至 GitHub 供免费使用,但开发者提醒用户避免大规模发送邮件骚扰 Altman。