Apache Spark 4.3 发布,Databricks Runtime 19 已可用
Introducing Apache Spark® 4.3 - Now available in Databricks Runtime 19
Apache Spark 4.3 发布并在 Databricks Runtime 19 中可用,Real-Time Mode 新增有状态处理,支持流式聚合、dropDuplicates 和 transformWithState。
原文给出实时模式有状态处理的三项基准延迟数据和季度发布节奏变化,读者可据此判断流处理架构的取舍。
介绍
Apache Spark 4.3 将状态处理带到实时模式,在三个有代表性的状态处理基准测试中实现了小于 150 毫秒的 P99 端到端延迟。流式聚合、去重和自定义状态处理现在可以在 Structured Streaming 的低延迟执行模式下运行,扩展到需要跨事件保留上下文的应用。
影响超出了更快的管道。对于支持的工作负载,您不再需要一个单独的流式引擎来实现毫秒级延迟。从欺诈检测到持续更新的用户活动和设备监控,开发者可以在他们用于批处理、分析和 AI 的同一个开放引擎中,使用熟悉的 Structured Streaming API 构建状态应用程序。
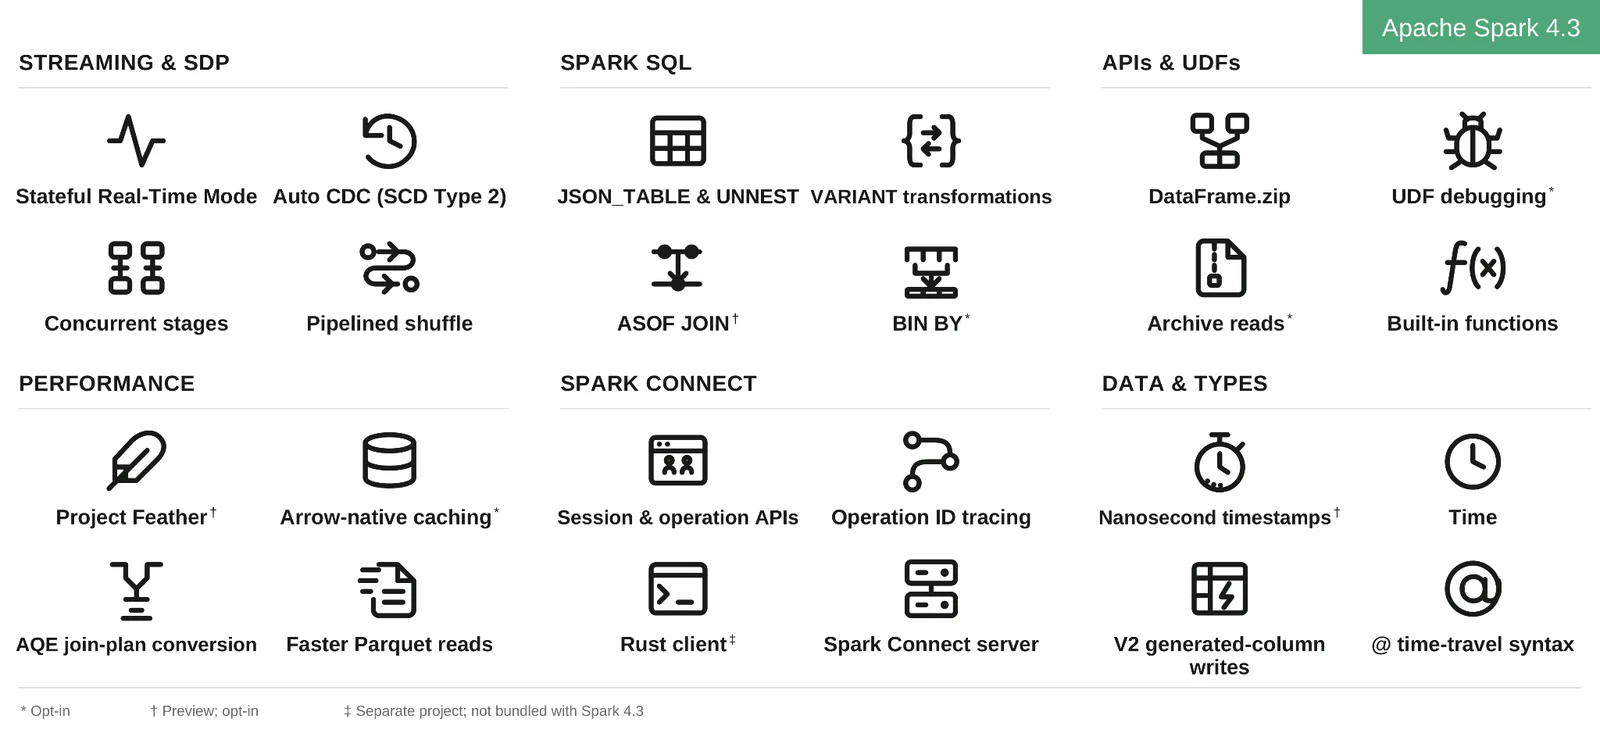
状态实时流是 Spark 4.3 的头条新闻,但改进贯穿整个引擎。该版本提供了五个关键优势:
- 构建状态实时应用程序:使用实时模式下的流式聚合、去重和
transformWithState来在事件到达时保持上下文。 - 使用 SCD Type 2 Auto CDC 保留历史记录:使用 Python、SQL 和 Spark Connect 跟踪记录随时间的变化,减少自定义变更处理逻辑。
- 在小数据集上更快地迭代: Project Feather 针对不必要的执行开销,而 Arrow 本地缓存支持更高效的数据重用。
- 让更多应用程序连接到 Spark:Spark Connect 可观察性、JDBC 集成和 Python 的改进使远程执行更容易开发和操作。
- 直接在 SQL 中表达更丰富的分析: VARIANT 转换、JSON_TABLE、时间连接和纳秒时间戳预览扩展了对嵌套和时间导向数据的原生处理。
所有这些更改帮助开发者使用一个开放引擎来探索数据、维护变化的上下文,并支持分析和 AI 应用。
Spark 4.3 也标志着 季度功能发布节奏 的开始,从每六个月发布一次变为每三个月发布一次。这个更短的周期将完成的改进更快地交付给用户,并给社区提供更频繁的反馈和塑造未来的机会。
实时流:具有毫秒级延迟的状态应用程序
从处理事件到维护上下文
欺诈信号不仅取决于最新的交易,还取决于之前的活动。个性化需要反映用户的最近行为。设备监控需要在新的读数到达时更新计数器和聚合。这些应用程序需要低延迟和状态。
Spark 4.3 将实时模式扩展到这些状态处理模式,使其成为一个完整的流式引擎。它添加了对流式聚合、dropDuplicates 和 Scala/Java transformWithState 的支持 (SPARK-58635, SPARK-57228)。开发者可以使用 Structured Streaming 现有的编程模型来维护键状态并更新结果,而不是仅仅为了低延迟而采用另一个引擎。
三个状态基准测试中 P99 延迟小于 150 毫秒
在 SPARK-58884中报告的基准测试中,所有三个有代表性的状态工作负载都实现了 P99 端到端延迟低于 150 毫秒:
| 状态工作负载 | P99 端到端延迟 |
|---|---|
| dropDuplicates | 136 毫秒 |
| 窗口聚合 | 139 毫秒 |
| transformWithState | 141 毫秒 |
这些结果表明,在去重、窗口聚合和自定义有状态处理方面具有低延迟执行。它们是三个测试工作负载的测量值,而不是对每个管道的延迟保证。
熟悉的 API,低延迟执行
实时模式基于 Structured Streaming,而不是引入一个单独的编程模型。有状态操作符继续使用 Spark 的现有状态存储和检查点机制以实现持久性和恢复。
示例:为每个设备维护一个运行计数。给定一个基于 Kafka 的流式 DataFrame events,其中有一个 device_id 列:
如果为设备 A、A 和 B 到达事件,Spark 维护状态并更新计数到 A=2 和 B=1。当另一个 A 事件到达时,其状态更新为 A=3。
为持续数据流构建的执行引擎
支持有状态的实时模式需要对 Spark 的调度和阶段连接方式进行了根本性的改变。在传统的阻塞混洗中,生产阶段必须完成,其下游阶段才能开始。这种模型无法支持长时间运行的流式任务之间的持续数据流。
Spark 4.3 引入了原生并发阶段调度和管道化混洗,允许生产者和消费者阶段同时运行 (SPARK-54699, SPARK-58076, SPARK-56664)。流式混洗为实时模式实现了这种功能,将记录增量地传输到负责每个键的下游任务,而不是等待整个生产阶段完成。
从概念上讲,执行方式从:
生产阶段 → materialize 混洗 → 消费阶段
变为:
生产阶段 ⇄ 流式混洗 ⇄ 消费阶段
Spark 4.3 添加了 PipelinedShuffleDependency,一种新的混洗依赖类型,允许消费者在生产者仍在运行时开始读取 (SPARK-58185)。调度器将具有这些依赖关系连接的阶段视为一个管道组,一个协调的调度单元。其阶段一起调度,一个阶段的失败会导致整个组失败 (SPARK-58263, SPARK-58398)。简而言之,它们一起运行,一起失败。
由于管道组中的所有阶段都并发运行,Spark 只有在为该组的所有任务都有足够的任务槽位时才接受该组。否则,它会快速失败,而不是挂起。
Spark 根据其依赖类型将每个混洗路由到混洗管理器:
- 常规
ShuffleDependency使用阻塞混洗管理器,它在下游阶段读取之前会 materialize 所有混洗输出。SortShuffleManager是内置实现。 -
PipelinedShuffleDependency使用管道化混洗管理器,它使输出在产生时即可用。StreamingShuffleManager是内置实现 (SPARK-57141)。
依赖类型定义了执行契约;混洗管理器提供数据传输机制。调度器协调管道化阶段,而无需知道是哪个工作负载创建了它们。
该基础功能超越了实时模式。并发阶段调度、流水线数据交换和协调执行是 Spark 引擎的通用功能,而不是一次性流式基础设施。在 Spark 4.3 中,它们支持低延迟的带状态处理。从长远来看,它们为需要超越传统一次一个阶段执行模型的其他工作负载提供了基础。
有关实时模式的设计和应用场景的背景信息,请参阅实时模式介绍。该文章描述了 Databricks 的实现;此处讨论的 Spark 4.3 功能范围和基准测试结果如上所述。
Feather 项目:在小数据集上实现更快的迭代
使用大型语言模型辅助开发通常遵循一个短反馈循环:生成转换、在样本上运行、检查结果并优化代码。每次迭代可能只处理一个小文件或几行,但任务调度和洗牌的成本可能超过计算本身。
Feather 项目针对固定的执行开销,使 Spark 在探索和验证小数据集上的 SQL 和 DataFrame 代码时更加响应。开发人员可以使用相同的 API,无论是在从样本迁移到更大的工作负载时,还是自己编写代码或与 AI 助手合作。
Spark 4.3 引入了针对符合条件的、无洗牌的单任务执行,适用于小的、单分区的查询片段 (SPARK-57851)。当符合资格的扫描报告其输出已经在单个分区中时,支持的下流操作可以避免不必要的洗牌。
示例:运行并检查一个小型聚合。使用存储为单个文件的小型 Parquet 数据集,其中包含一个分类列:
六种情况:
category, Exchange, SPARK_LOCAL_CONNECT_REUSE=1, zip, counter_diff and jaro_winkler_similarity.
结果是每个分类的一个计数。对于符合条件的查询,物理计划可以省略 `Exchange`,否则它将引入洗牌。这支持相同的运行和检查工作流,无论转换是由开发人员编写还是由编码助手建议。
在默认的资格限制下,符合条件的文件扫描读取一个非空的小文件,该文件适合单个分区,而符合条件的本地内存关系包含最多 1,000 行。支持的查询形状包括选择扫描、聚合、唯一操作、窗口、排序和限制。
Feather 还添加了可选的 Arrow 本地数据集缓存 (SPARK-57268),以 Arrow 格式存储缓存的批次,并进行压缩和列统计。Arrow 支持的输入可以避免不必要的转换,支持重复探索相同数据的工作流。单任务优化和 Arrow 缓存都是可选的。要启用它,请在启动新的 Spark 应用程序时设置静态配置 spark.sql.cache.serializer=org.apache.spark.sql.execution.columnar.ArrowCachedBatchSerializer。更广泛的进程内本地重分区是针对下一个版本的目标工作 (SPARK-57399)。
这些改进只是开始。Spark 社区将在未来的版本中继续投资于小数据性能,减少执行开销,缩短交互式探索和 LLM 辅助开发的反馈循环。
开源自动 CDC 中的 SCD 类型 2:在数据变化时保留历史记录
当前状态表可以告诉你客户今天住在哪里,但无法知道他们在订单下单时属于哪个地区。报告、审计和历史分析通常需要这两种信息。Spark 4.3 为 Auto CDC 添加了端到端缓慢变化维度(SCD)类型 2 支持 (SPARK-56249),因此管道可以跟踪每条记录的历史,而不是用每个变更的最新值覆盖旧值。此功能通过 Python、SQL 和 Spark Connect (SPARK-58321, SPARK-58247, SPARK-58261) 提供,并允许用户自动应用变更,而不是手动合并操作。
示例:跟踪客户状态和地区随时间变化。给定一个 customer_changes 管道源,其中包含客户 ID、事件时间、状态和地区:
或者,这也可以用 SQL 表示:
在一个 SCD-2 输出表中,每个唯一键都由一系列记录表示,每条记录使用两个额外的元数据列 __START_AT 和 __END_AT 标记其有效性的开始和结束。例如,当变更记录指示具有 ID 17 的客户从地区 West 移动到 East 时,管道保留具有先前地区 West 的记录并将其结束标记为变更记录的事件时间;它插入一个具有地区 East 和记录的事件时间作为其开始的新记录。然后,分析可以使用在事件时间序列中相关点应用的地区。
在底层,Auto CDC 将声明式流程定义与目标模式推导和专用的 SCD 类型 2 流处理连接起来 (SPARK-58319, SPARK-57395, SPARK-58321)。键标识实体,序列确定变更的顺序,历史跟踪列指定哪些属性变更创建历史版本。引擎还验证保留列、序列类型和历史跟踪配置 (SPARK-57251, SPARK-58313, SPARK-58391),并将较窄的微批处理与演进的目标模式协调一致 (SPARK-58418)。
Auto CDC 使用 MERGE 将每个微批处理应用于目标,因此目标表必须位于其连接器实现数据源 V2 行级操作的目录中。Spark 的内置文件格式,包括 Parquet,不符合要求。因此,一个常见的选择是 Iceberg。
Spark Connect:更易于开发、观察和操作
应用程序和 AI 代理需要从它们自己的进程中调用 Spark、管理会话并将失败的请求连接到服务器上运行的作业。Spark 4.3 通过会话和操作可见性、请求归因以及更广泛的客户端支持,加强了 Spark Connect 以支持这些工作流。
Spark Connect 将 DataFrame 操作作为逻辑计划通过 gRPC 发送,通过服务器的 Spark 引擎执行,并以 Arrow 批次的形式将结果流回。Spark 4.3 添加了用于列出和检查 Connect 会话和操作的 REST 端点,以及用于跨客户端和服务器跟踪执行的作业 ID (SPARK-57941, SPARK-58547)。对于 POSIX 系统上的本地 PySpark 开发,实验性选项 `SPARK_LOCAL_CONNECT_REUSE=1` 跨运行重用持久 Connect 服务器,避免了重复启动的开销 (SPARK-57787)。PySpark 的 SQLContext 兼容性包装器也适用于 Spark Connect (SPARK-57021).
Spark Connect JDBC 驱动添加了对 ARRAY、MAP 和 STRUCT 结果的支持,以及更丰富的结果集处理 (SPARK-57380, SPARK-57274),SQL 类型的元数据和更兼容的模式内省 (SPARK-57627),以及改进的异常处理 (SPARK-57933, SPARK-58619)。API 覆盖范围通过 DataFrame.zip、SCD 类型 2 自动 CDC,以及纳秒时间戳类型和字面量 (SPARK-57247, SPARK-58247, SPARK-57160, SPARK-57161) 扩展。
此外,社区工作包括 Spark Connect Gateway (SPARK-58455) 用于会话感知路由和多租户操作,Rust 和 Rust 支持的 Python 客户端 (SPARK-58960) 用于另一种客户端实现路径,以及一个能力发现提案 (SPARK-56398) 用于在提交查询之前识别支持的服务器操作。这些工作有单独的开发时间线,并不捆绑在 4.3 功能中。
PySpark:更丰富的 API 和更好的 Python 执行
Python 工作流通常在不同的步骤中构建派生列,组合结果,并在 pandas、Arrow 和 Spark 之间移动数据。Spark 4.3 通过 DataFrame API 提供了更多此类工作,同时改进了它们底层的执行路径。 DataFrame.zip 添加了一种在不降级到 RDD API 的情况下组合兼容列投影的方法,包括在使用 Spark Connect 时 (SPARK-55886, SPARK-57247)。
示例:将标识符与派生值组合。从相同的输入创建两个投影并将它们的列组合在一起:
结果对 id=1 与 doubled=20 和 id=2 与 doubled=40 组合。`zip` 组合具有相同底层计划的投影仅转换;在那些投影下面的过滤、排序、连接或聚合必须在两侧都相同以保留行对齐。
更广泛的执行工作针对数据传输、批处理和原生计算。基于 Pickle 的 UDF 输入批处理可以按字节而不是仅按行数限制,当行大小不同时提供更好的控制 (SPARK-57593)。批处理的 pandas-on-Spark 投影和额外的原生 NumPy 实现减少了可避免的工作 (SPARK-58230, SPARK-58234),而 pandas 到 Spark 的转换添加了对 PyArrow ChunkedArray 列的支持 (SPARK-46776)。
该版本还添加了对现有向量函数的 Python 和 Scala 绑定 (SPARK-57284),分组协方差和描述性统计 (SPARK-40336, SPARK-40337),滚动和扩展中位数和标准误差操作 (SPARK-40341, SPARK-40340),以及 show_versions 诊断 (SPARK-40373)。Traceback 局部是可选的,因为它们可能包含敏感数据 (SPARK-57271)。
Spark SQL:为分析和 AI 准备更好的上下文
事件有效负载作为嵌套文档到达,紧密相邻的事件可能需要比微秒更高的精度。准备这些输入不应需要对每个转换都使用单独的自定义处理层。Spark 4.3 扩展了用于半结构化数据和时序分析的本地 SQL,包括文档操作、时序匹配,以及可选的纳秒时间戳预览 (SPARK-56822).
示例:在同一微秒内区分两个事件。启用预览(功能尚未稳定,可能发生破坏性变更)并比较相差一纳秒的时间戳 (SPARK-56969, SPARK-56965, SPARK-57211):
比较结果为 true:保留最后一位数字而不是丢弃。预览支持 TIMESTAMP_NTZ(p) 和 TIMESTAMP_LTZ(p),精度从 7 到 9。
这需要不仅仅是接受一个新的 SQL 类型名称。纳秒级支持贯穿解析、内部值表示、类型转换、表达式、Spark Connect、缓存和数据源集成 (SPARK-56822)。新的 timestamp_nanos 和 unix_nanos 函数处理数值转换 (SPARK-57526, SPARK-57527)。存储和连接器的支持仍然特定于每个数据路径,因此预览必须端到端评估。
将变化的 JSON 有效负载转换为可用数据
应用程序事件、文档导出和模型响应通常以嵌套 JSON 的形式到达。Spark 4.3 的 JSON_TABLE (SPARK-58366) 结合了数组扩展和类型字段提取,而 VARIANT 转换允许管道在不使用自定义文档处理 UDF 的情况下更新或删除字段 (SPARK-57804, SPARK-57417)。它们共同简化了为分析、增强和检索管道准备内容。
示例:提取相关的文档部分。
这会产生一个类型化的行,管道可以在其他下游操作之前用源元数据对其进行增强。JSON_TABLE 通过对每一行项进行共享遍历来解析其列路径,避免了为每一列进行单独的解析。另外,Spark 将 VARIANT 字段提取下推扩展到支持聚合、排序或连接的查询。 (SPARK-58089).
后续的 SQL/JSON 工作 (SPARK-58686) 在这个方向上扩展了 JSON_VALUE、JSON_EXISTS 和 JSON_QUERY,用于标量提取、存在性检查和片段检索 (SPARK-58685, SPARK-58687, SPARK-58723)。显式的缺失值和错误处理将帮助应用程序更可预测地处理变化的模式。这些是后续开发,而不是额外的 4.3 功能。
将事件与当时可用的信息匹配
历史分析和模型评估需要事件发生时的上下文,而不是后来添加的信息。Spark 4.3 的 SQL ASOF JOIN 表达(功能在预览中,可能发生破坏性变更)这种时间匹配,直接替换了手写的范围连接后跟排名 (SPARK-58092).
示例:重建用于预测的功能。在这里, available_at 记录了功能版本何时可用 (SPARK-58122, SPARK-58123):
10:03 的预测与 10:00 可用的功能版本匹配,而不是 10:05。专用的排序合并执行路径使这种匹配成为引擎操作,而不是特定于应用程序的查询逻辑。结果是更简单的点时增强,用于训练数据、评估和事件分析,前提是可用时间戳准确反映了当时已知的内容。
值得注意的改进和致谢
Spark 4.3 还引入了新的 API 和日常数据处理性能改进。SQL 获得了 ANSI UNNEST 用于将数组扩展为行,以及 `counter_diff` 窗口函数用于将累积计数器转换为增量,以及 `jaro_winkler_similarity` 用于字符串相似性比较。支持的文件源添加了对读取 tar、zip 和 7z 存档的 opt-in 支持,消除了单独的提取步骤。引擎改进了聚合执行,并通过默认为符合条件的 UNION 操作启用全阶段代码生成。opt-in 优化在符合条件的外连接和反连接中跨 shuffle 分区分布 null 连接键。嵌套数据处理在 struct 数组内的未使用字段中获得了更多的剪枝,并为更多的数组高阶函数提供了代码生成。向量化 Parquet 读取改进了类型转换和字典解码。
Spark 4.3 反映了 Apache Spark 社区的力量,超过 200 名贡献者帮助解决了超过 1,100 个 Jira 工单。我们感谢所有为使此次发布成为可能的代码贡献、审查、测试、文档和反馈做出贡献的人。
开始使用 Spark 4.3
访问 Apache Spark 下载页面 获取发布下载和文档,并在升级前查看迁移指南。有关 Databricks 的可用性,请咨询 Databricks 运行时发布说明。
来源: Databricks Blog · databricks.com