Meta 将 JiTTesting 投入生产:用 LLM 生成测试在代码合入前抓 Bug
Catching Bugs Before They Land: JiTTesting’s Human-on-the-Loop Approach at Full Scale
Meta公布Catching JiTTests已在内部投入生产,用LLM为待合入的diff自动生成可执行测试,在代码落地前暴露行为差异
Meta 公开了 JiTTests 的生产部署细节与量化结果,可供评估 LLM 生成测试在超大规模代码库中的落地方式。
- 在过去的一年里,我们一直在分享我们利用大型语言模型来实时捕捉错误的工作成果 — 我们称之为 Catching Just-in-Time Tests (JiTTests) 的一种新方法。
- 现在,我们正在分享 Catching JiTTests 部署到生产环境后的结果和积极影响。Catching JiTTests 部署到生产环境后的结果和积极影响。
- 我们的论文《Meta 的即时捕捉测试生成》,详细介绍了我们使用 Catching JiTTests 的初始部署和测试。
每次代码更改都会改进我们的平台,但它也引入了新的复杂性。在 Meta,数以亿计的代码行不断演变,传统的测试无法跟上步伐。Catching 风险,在代码部署之前,使我们能够更早地识别风险,更有效地做出响应,并在大规模上提供可靠体验。
在过去的一年里,我们分享了我们关于 将大型语言模型 (LLMs) 应用于生成软件测试 的研究。更具体地说,我们分享了我们关于 即时测试 (JiTTests) 的工作,这是一种新的测试方法,我们利用 LLMs 来实时捕捉错误,即使传统的测试可能无法捕捉到这些错误。
在我们首次公布这项工作的五个月里,我们已经将 Catching JiTTests 方法部署到生产环境,以确定其可扩展性和对更广泛行业的适用性。今天,Catching JiTTests 不再是一个研究原型;它们是 Meta 基础设施的一部分,并且正在帮助我们的工程师以更小的负载和更小的误报概率捕捉更多的错误。
Catching JiTTests 的优势
大多数用于防止代码中的错误的 AI 方法使用 LLMs 和/或代理 AI 来审查代码,并根据先前的经验检测错误。它们通过人类审查员会经历的相同审查过程,只是更快。Catching JiTTests 是一种 根本不同的方法(表 1):它生成可执行的测试,以展示更改引入的具体行为差异。虽然它需要更多的计算步骤,但它可以捕捉到 LLM 或代理代码审查可能无法捕捉到的错误类别。
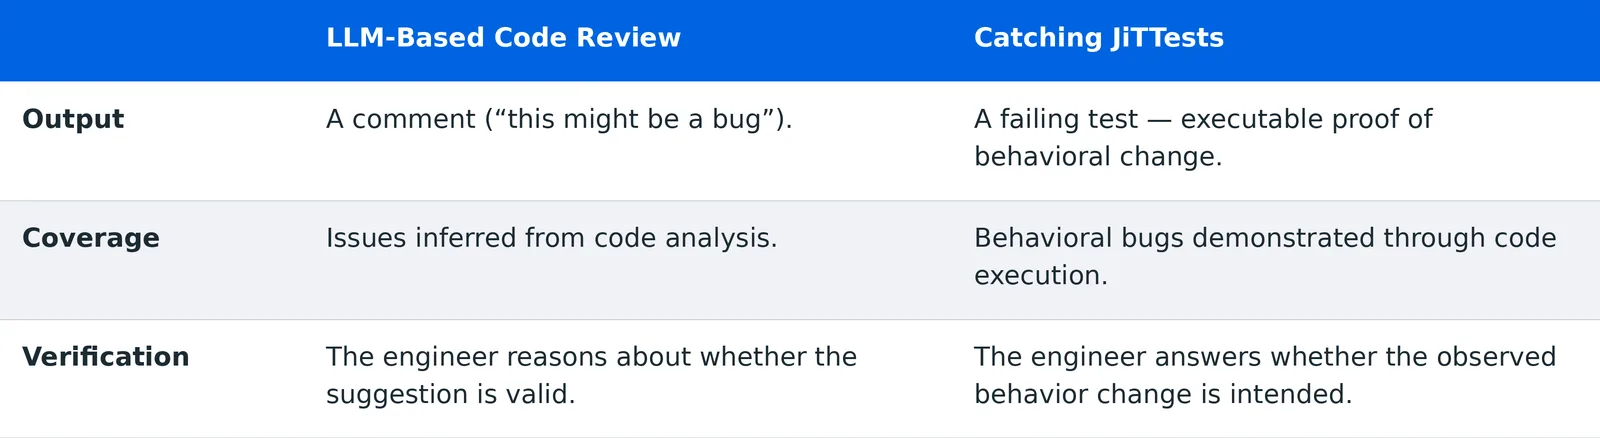
我们在 Meta 实施 Catching JiTTests 的方法
JiTTests 是自动生成的,旨在失败,在代码更改(diffs)部署到生产环境之前暴露错误。当它们应用于像 Meta 这样庞大的代码库时,一个挑战是将强捕捉(即,揭示真实错误的真阳性失败)与弱捕捉(即,可能是误报的测试)区分开来。
这归结为一个具体的问题:对于每个建议的 diff,我们如何自动生成在它们引起严重问题之前找到最严重错误的测试,并且以高真阳性率和不阻碍我们工程师的速度来完成呢?
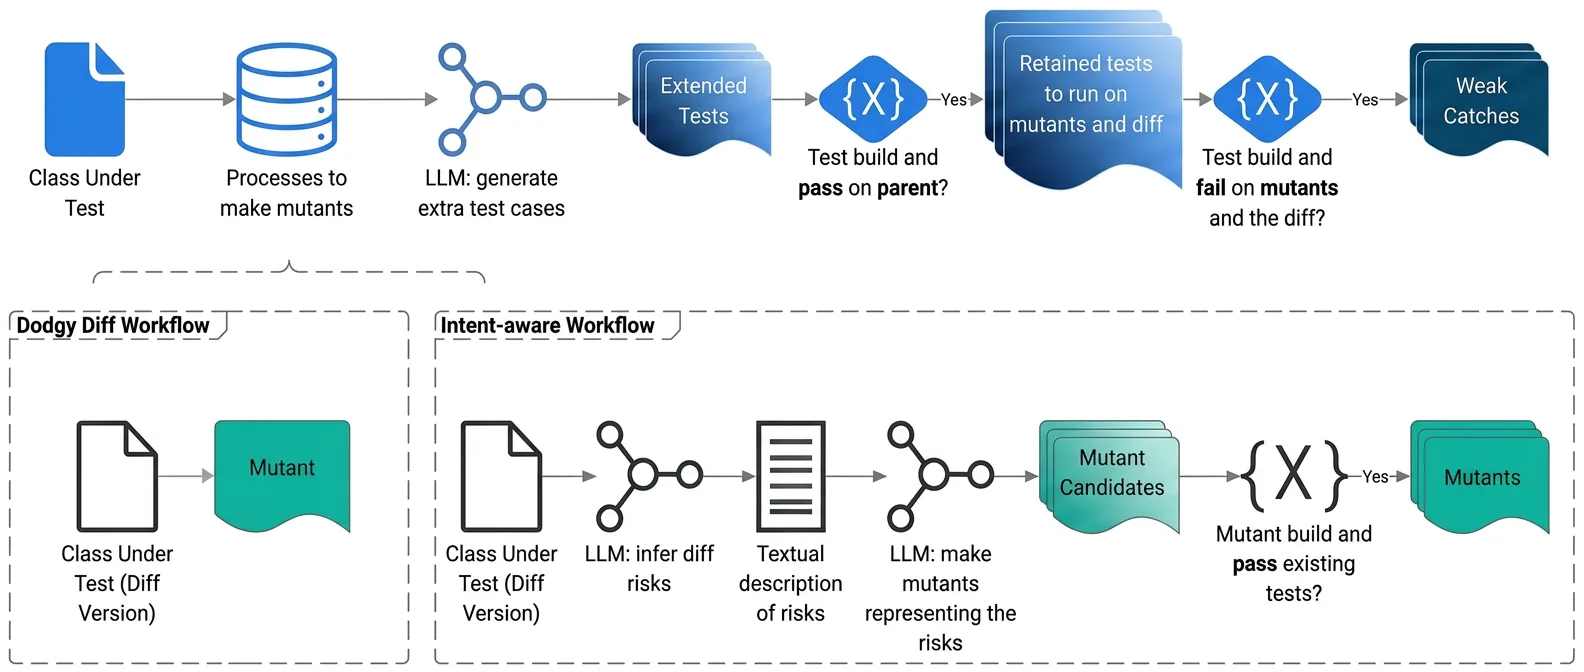
为此,我们开发了两个串联的工作流程:
- 一个“意图感知”工作流程,它推断代码更改的意图和风险,并将测试生成目标指向可能的失败点。
- 一个 “可疑 diff”工作流程,它将每个代码更改都视为一个突变体/错误,并生成测试以暴露其行为差异,而无需推理意图。它隐含地断定一个 diff 是有问题的(因此有“可疑”这个词)。
为了过滤误报,我们采用了一种传统的基于规则的方法,并结合了我们称为“LLM作为法官”的集成方法,该方法汇集了几个最先进(SOTA)LLM的判断,所有这些LLM都被用于将弱捕获分类为可能是真实的或误报。
我们还保留了人工审核,目的是减少审核工作量。我们的目标是保持人工标记的一致性,但减少工程师被叫来审核弱捕获的可能性。
工作原理
整个系统工作流分为五个阶段:
阶段1:目标定位和触发
系统在备用容量上运行一夜,并针对前一天提交的被认为是“有风险”的差异,使用类似于差异风险评分(DRS)的机制,并在先前的代码更改上进行训练。这有助于确保测试生成集中在最有可能包含严重回归的差异上。
阶段2:两个感知差异的测试生成工作流
The dodgy diff workflow 将每个差异 视为如果它是突变体并使用 基于突变引导的LLM测试生成来生成可以区分差异行为与其父级的测试。这里的目的是最大化弱捕获的池,并借此提高在其中找到强捕获的机会。
与此同时,the intent-aware workflow 使用一个LLM来 推断差异的意图,使用代码更改、差异标题和摘要。然后,LLM描述了 “风险”— 尝试实现意图时可能产生错误的方式。然后,它使用这些风险描述来 构建突变体 — 每个代表在实现推断的意图时可能引入的bug。
生成测试以 杀死每个突变体(即,区分突变体行为与其父级)。
然后,在真实的差异上运行这些测试。任何失败的都被收集作为弱捕获。
阶段3:LLM作为法官集成(自动评估)
一旦生成弱捕获,系统必须确定每个是否是误报或实际上是强捕获(真阳性)。
LLM作为法官集成由一组LLM组成,它们审核:
- T弱捕获测试用例代码。
- T测试执行结果(失败代码、消息、执行跟踪)。
- 父级和子级之间的代码更改(差异)。
- 推断的差异意图。
阶段4:基于规则的评估器(RubFake)
我们用一种更传统、基于规则的方法补充LLM作为法官,称为基于规则的误报消除环境(RubFake)。
LLM作为法官具有丰富的语义,但它的判断是非确定性的,并且难以验证。相比之下,RubFake提供 经过验证的确定性判断。RubFake和LLM作为法官一起工作,产生弱捕获候选人的整体排名,排名足够高的值得进一步考虑。
阶段5:人工监控(工程师联系)
根据 LLM-as-Judge 和 RubFake 的排名,系统随后决定是否联系人类工程师。
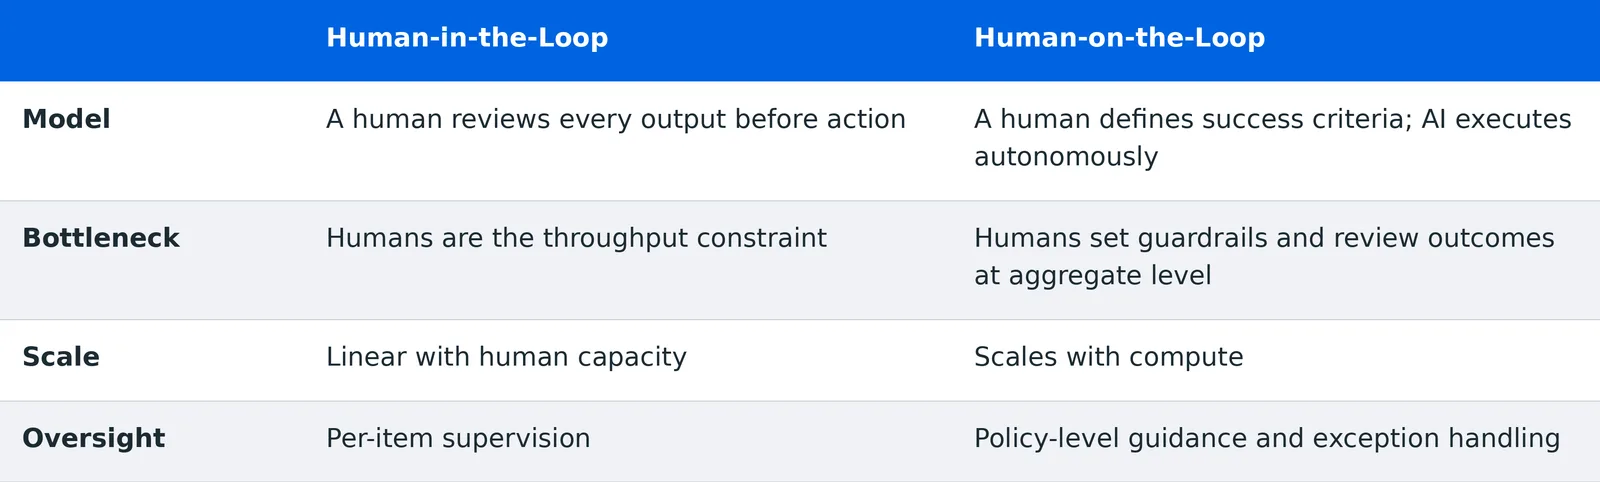
我们不是采用人类参与式方法,即人类工程师审查每个输出,而是通过人类-在环式方法减少摩擦,人类工程师设定标准并在汇总层面审查结果,而不是监督每个输出。
捕获 JiTTests 在 Meta 的影响
有了测试系统,我们的目标是让工程师参与其结果。
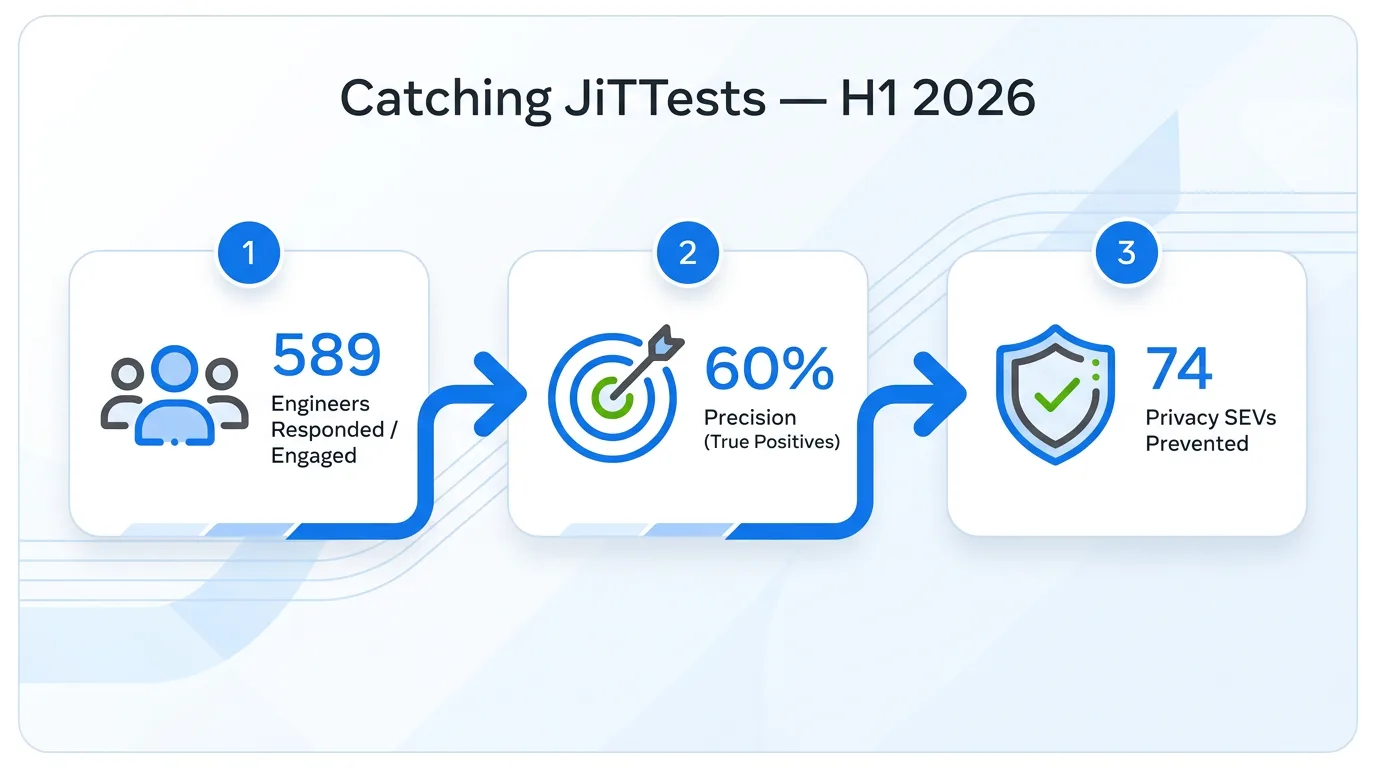
截至本文写作时,Meta 的 589 名工程师(占我们联系人数的 64%)已经参与了捕获 JiTTests。这些工程师报告说,捕获 JiTTests 揭示了真正可操作的发现,真阳性率为 60%。
在 2026 年上半年,捕获 JiTTests 在 diff 阶段捕获了 74 个严重(SEV)隐私错误,在它们进入生产之前,并在该时间段内将整体隐私 SEV 发生率降低了 20%。
为什么这很重要
代理软件开发正在帮助整个行业的工程师和开发人员以前所未有的速度编写、审查和发布代码。但更快的部署也意味着需要更快的测试。在错误到达生产之前捕获的每个错误都是最终用户无需处理的错误。我们已经证明,LLM 可以提供额外的安全层,能够捕获传统测试可能遗漏的内容,证明 AI 生成的测试可以扩展到足以降低组织风险。
捕获 JiTTests 是一个可扩展的解决方案,无论是在技术上还是在社会上。将这些测试与人类在环式方法相结合,有助于确保工程师很少需要阅读测试代码,并且只需要确认观察到的行为变化是否为预期。
这种方法是通用的:工程师在早期定义成功标准,让 AI 执行测试,在汇总层面监控结果,并在政策层面而不是逐项干预。
阅读论文
我们的论文“Meta 的即时捕获测试生成”,在 FSE 2026 上发表,并在 Product@Scale 上重点介绍,详细介绍了我们在 Meta 基础设施中部署和测试捕获 JiTTests 的初始情况。
文章 在它们落地之前捕获错误:JiTTesting 的人类在环式方法全面实施 首次出现在 Meta 工程.
来源: Meta Engineering · engineering.fb.com