OpenHands 与 Snowflake 推出用自有 Agent harness 后训练模型的工作流
Post-Train a Model for Your Own Agent Harness with OpenHands and Snowflake
OpenHands与Snowflake AI Research合作,让开发者用现有的OpenHands Agent harness直接进行强化学习后训练,无需在训练框架中重建harness。
原文给出了用现有 Agent harness 直接做 RL 后训练的具体配置方式和代码定位实验,读者可据此判断训练与部署能否共用一套 harness。
OpenHands × Snowflake AI Research
AI 编码代理正越来越多地针对特定的开发工作流程进行定制。开发者配置系统提示、工具、技能、执行环境,并调整预算以帮助代理在其仓库和工程流程中有效工作。
但存在一个脱节:虽然代理框架针对您的工作流程进行了定制,但为其提供动力的模型通常没有。
大多数模型使用与最终部署环境不同的通用代理配置进行后训练。结果可能是熟悉的问题:错误的工具调用、忽略的技能、不必要的步骤,或代理在完成任务之前就耗尽了其回合预算。
开发者可以继续调整提示和工具来解决这些问题,但还有一个选择:在后训练模型以在代理框架本身中表现更好。
强化学习 (RL) 提供了一种做到这一点的方法。模型在代理环境中尝试任务,根据结果接收反馈,并更新其权重以提高性能。
挑战在于传统的 RL 框架通常会引入自己的代理循环、工具格式和任务结构。开发者必须在训练框架内重新创建他们现有的框架,引入额外的工程工作,并可能导致训练和部署之间的差异。
OpenHands 和 Snowflake 通过允许开发者使用他们现有的 OpenHands 代理框架进行后训练来解决这个差距。
使用 OpenHands Agent SDK,开发者可以配置具有自己的提示、工具和技能的代理。任务使用开放 Harbor 格式定义,而 Snowflake Cortex Training 提供了用于强化学习的 GPU 基础设施。
结果是开发者可以优化开放权重模型以针对他们的特定代理配置,而无需在单独的训练框架中重建框架。
您的框架就是训练框架
OpenHands 提供了一个开放、可扩展的框架,用于构建可以与开发环境交互、执行命令、使用工具并完成多步任务的 AI 代理。
而不是规定单个模型或代理配置,OpenHands Agent SDK 给予开发者对其代理如何运行的控制。
这种灵活性扩展到后训练。
在训练期间,每次回滚都是您 OpenHands 代理的真实执行。系统提示、工具、技能和执行限制作为配置传递,而不是在单独的 RL 框架内重新创建。
| 您的框架的一部分 | 如何设置它 |
|---|---|
| 系统提示 | OPENHANDS_SYSTEM_PROMPT_FILE |
| 工具 | OPENHANDS_TOOLS(例如:terminal,task_tracker) |
| 技能 | HARBOR_SKILL,一个或多个 SKILL.md 路径 |
| 回合预算和上下文长度 | MAX_TURNS, MAX_CONTEXT_LENGTH |
| 一个完全定制的代理 | HARBOR_AGENT=my_package:MyAgent |
| 基础模型 | MODEL(例如:Qwen/Qwen3.5-4B) |
代理不需要知道它正在被训练。它发送普通的聊天完成请求,代理和模型之间的代理记录模型在每个回合中产生的确切标记。这些标记成为训练数据:模型从自己的输出中学习,而提示和工具结果是排除在损失之外的。
这允许开发者保留他们现有的代理配置和执行逻辑,而不是维护一个单独的训练实现。
任务使用开放 Harbor 格式,开发者可能已经使用 harbor run 对代理进行评估。
一个 Harbor 任务是一个包含以下内容的目录:
-
instruction.md,它描述了任务。 -
environment/,它定义了沙盒。 -
tests/test.sh,它评估了结果。
测试脚本的分数成为训练过程中使用的奖励信号。
每个 rollout 在自己的 Snowflake Cortex 沙盒中运行。代理的终端和评分器在同一个沙盒中执行,确保奖励反映了代理行动的结果。
结合 OpenHands 和 Snowflake 的关键优势:开发者可以重用他们现有的代理 harness 和任务定义,而 Snowflake 提供了用于 RL 训练所需的隔离执行环境和 GPU 基础设施。
开发者无需维护用于代理开发和模型后训练的单独系统,可以在两个工作流程中使用相同的底层代理实现。
让 OpenHands 运行训练
即使有现有的代理 harness,配置和管理 RL 训练也涉及几个操作决策。
开发者需要分配 GPU、配置批处理大小和序列限制、启动训练作业、监控进度、排除失败的 rollout 问题,并在训练完成后释放计算资源。
OpenHands/extensions 中的新 cortex-training-rl 技能自动化了大部分此过程。
使用 OpenHands,开发者可以描述他们想要的训练运行,编码代理处理设置和执行。
例如,在 OpenHands 中:
Use /cortex-training-rl to post-train Qwen/Qwen3.5-4B on my Harbor tasks in ~/my-harbor-tasks/train and ~/my-harbor-tasks/eval with my agent's skill at ~/my-skill/SKILL.md, a 15-turn budget, for 50 steps.
或从终端,使用 OpenHands CLI:
openhands --headless -t "Use /cortex-training-rl to post-train Qwen/Qwen3.5-4B on my Harbor tasks in ~/my-harbor-tasks/train and ~/my-harbor-tasks/eval with my agent's skill at ~/my-skill/SKILL.md, a 15-turn budget, for 50 steps."
提示命名训练和评估任务目录、harness 和运行长度;代理将它们转换为训练配置。
然后代理:
-
配置用于 harness 和任务的训练启动器。
-
检查 Snowflake Cortex Training 上的 GPU 可用性。
-
在后台启动训练运行。
-
在每个步骤报告奖励指标和失败的 rollout。
-
绘制奖励曲线。
-
在运行完成时释放 GPU 资源。
该技能与 OpenHands 配合使用,也可以从 Claude Code 和 Cursor 中使用。
您的本地机器只需在 CPU 上运行代理 rollout。模型训练和采样在 Snowflake Cortex Training 的 GPU 上运行,默认情况下每个使用四个 H200 GPU。
这种分离允许开发者在现有的代理环境中工作,而无需配置或管理专用的 GPU 集群。
它还展示了 OpenHands 可扩展的代理架构如何支持代码生成之外的工作流程,包括模型训练作业的配置和管理。
示例:后训练自定义代码定位代理
为了端到端测试该方法,我们为代码定位任务(来自 OpenHands 的 CodeScout 工作的一部分)构建了一个自定义代理 harness。
代理从 SWE-smith 数据集中的真实 Python 仓库接收一个 GitHub 问题。其目标是识别需要更改的文件、模块和函数,以解决该问题。
这是一个对 harness 特定后训练的有用测试用例,因为成功的执行不仅取决于模型的通用编码知识。
代理必须导航仓库,使用其可用的工具,遵循配置的工作流程,并在有限的回合数内生成结构化结果。
代理配置
harness 使用具有以下内容的 OpenHands 代理:
-
为代码定位专门设计的系统提示。
-
用于探索仓库的终端工具。
-
用于提交答案的自定义
localization_finish工具。 -
最大预算为 10 个回合。
奖励是根据代理在文件、模块和函数级别上的 F1 分数总和计算的。
最大可能的奖励是 3.0。
我们在该框架中训练 Qwen3.5-4B 共 25 步,每步使用 64 次展开。
训练结果
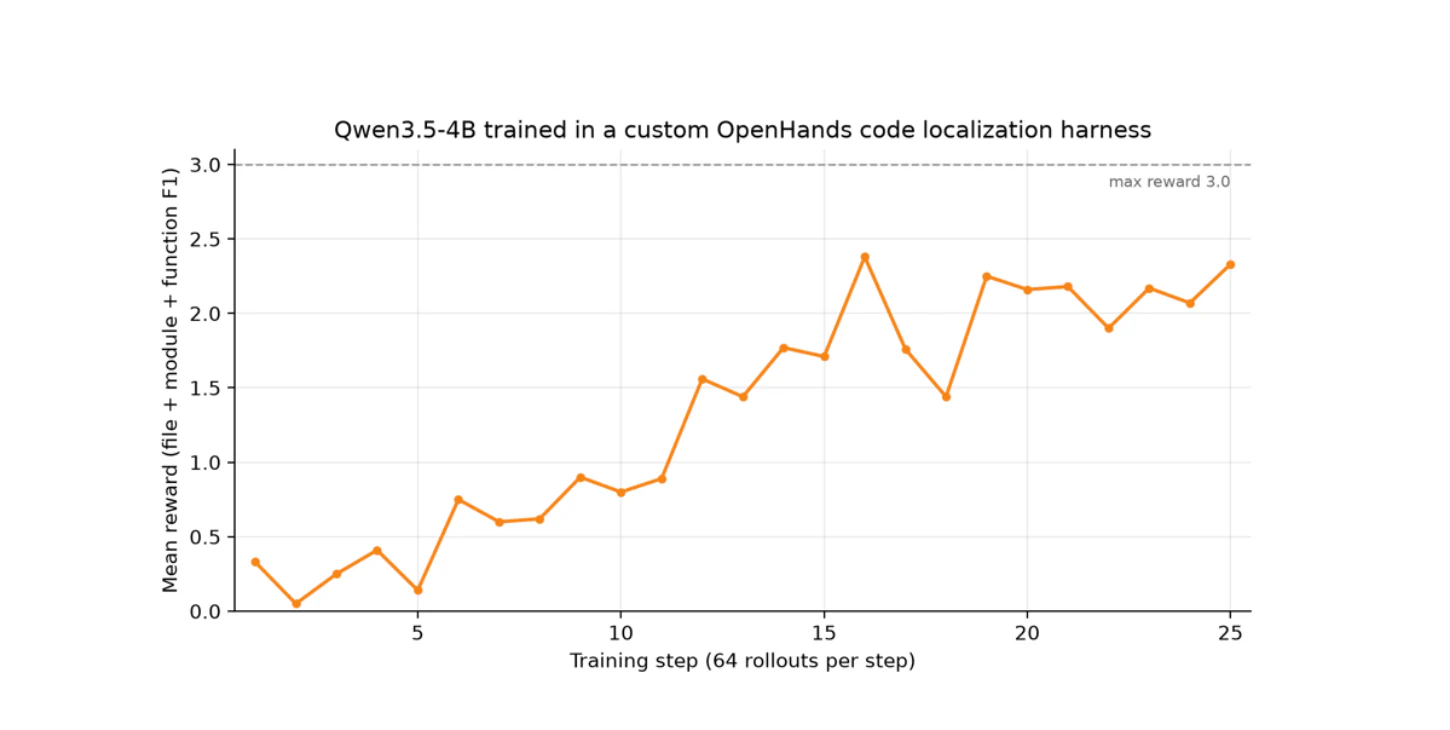
图 1。Qwen3.5-4B 在自定义 OpenHands 代码定位框架中训练的文件 + 模块 + 函数 F1 平均奖励随训练步长的变化。
结果表明,模型在配置的框架内学会了更有效地执行专门的代码定位任务。
这是一个重要的结果:在这个实验中,通过现有的 OpenHands 框架和标准 Harbor 任务格式进行训练,实现了与专门构建的 RL 实现相当的学习成果。
该方法保留了优化模型以适应任务的能力,而无需为训练重建代理框架。
完整的运行,从 Harbor 任务到为框架训练的模型,只需几个小时即可完成。训练后不再需要将其作为独立的研究项目,拥有自己的框架和 GPU 集群。它成为框架开发循环中的一步,与调整提示、工具和技能并肩而行。
使用您自己的代理框架试试看
打开 OpenHands 并描述训练运行,如上例所示。技能 cortex-training-rl 来自 OpenHands/extensions,运行所需的一切只是一个带有 Cortex Training 的 Snowflake 账户和一组 Harbor 任务。
要完全控制训练配置,技能使用的 Arctic Platform Harbor recipe 也可以直接运行。其 README 文档记录了每个设置,并展示了如何重现上述代码定位实验。
值得了解
在配置训练时,有几个实现细节需要考虑。
-
默认情况下沙盒化:训练涉及执行数千个模型生成的命令。每个展开都有自己的 Snowflake Cortex 沙盒,训练机器的凭证不会暴露给沙盒。这为训练基础设施和代理执行之间提供了隔离。
-
基于终端的文件操作:代理的终端在新的 shell 中执行每个命令。工作目录在命令之间持续存在,但导出的环境变量和后台进程不会。OpenHands
file_editor工具在训练期间目前不可用,因此代理必须通过终端编辑文件。 -
GPU 配置:启动器默认针对 Hopper GPU 并使用 FlashAttention 3。其他 GPU 配置可以通过可用设置选择。
接下来
OpenHands 为开发者提供了灵活性,让他们围绕自己首选的模型、工具、技能和执行环境构建 AI 编码代理。
借助 Snowflake Cortex Training,这种灵活性现在扩展到这些代理执行的具体工作流的训练后模型。
开发者不再需要将现有代理适应单独的 RL 框架,而是可以使用配置好的 OpenHands 框架训练模型,根据真实任务评估性能,并使用托管基础设施来运行训练过程。
代码定位实验表明,这种方法可以在产生与专门构建的 RL 实现相当的结果的同时,提高特定任务的性能。
如果你已经使用 OpenHands 构建了一个代理框架,现在可以尝试为它训练一个模型了。
尝试 cortex-training-rl 技能,探索 Arctic Platform Harbor 配方,并告诉我们你训练了什么。
如果你的框架需要的功能尚未得到支持,请在 OpenHands/extensions 或 Arctic Platform 上打开一个问题。
资源
-
cortex-training-rl 技能: OpenHands/extensions,
skills/cortex-training-rl -
Arctic Platform Harbor 配方: Snowflake-AI-Research/Arctic-Platform,
recipes/rl/harbor -
OpenHands Agent SDK: OpenHands/software-agent-sdk
-
Harbor: harbor-framework/harbor
-
SWE-smith 代码搜索数据集: OpenHands/SWE-smith-py-code-search 在 Hugging Face 上
来源: OpenHands Blog · openhands.dev