Together AI 发布了 Together Compiler,持续编译优化 AI 推理。
Together Compiler: Continuous Compilation for AI inference
Together AI 发布了 Together Compiler(TKCC),利用高吞吐智能体持续为推理引擎生成优化方案,在 24 小时内于 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等前沿开源模型上实现 1.3-3x 的 TPS 提升。
原文给出了持续编译在多个前沿模型上的吞吐提升和引擎启动耗时对比,可据此判断推理优化流程的变化。
同一件事另外 1 家也报道了
各家口径不同:Together AI博客提到了模型Kimi K3和GLM 5.3;MarkTechPost提到了SemiAnalysis InferenceX AgentX。
- Together AI Blog··首发
- Together AI Blog··+0 分钟·当前阅读
Together AI 发布了 Together Compiler,持续编译优化 AI 推理。
新增信息:在Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash上实现1.3-3倍的TPS提升。
- MarkTechPost··+32 小时 3 分
Together AI 发布 Together Compiler,智能体让推理最高提速 2.6 倍
新增信息:在SemiAnalysis InferenceX AgentX工作负载下实现2.6倍的TPS提升。
按发布时间排列 · 事件后续出现时自动追加 · 由模型根据各家标题与摘要比对
AI 推理工作负载是动态的。有数千种不同的模式,涵盖新模型、硬件平台、客户、用例和流量形状。手动优化每种模式不再具有可扩展性。
- 架构高度可变:自 Transformer 以来,大约已有 11 年了。我们可能认为会有更多的整合,但在 OpenRouter 上的前 10 名开源 LLM 中,没有一个使用相同的架构!
- 工作负载高度可变:Together 每天为数千名客户服务数千亿个 token,每个客户都有不同的流量形状(批处理大小、序列长度、MoE 专家不平衡、注意力稀疏性、会话持续时间、领域)。
- 硬件高度可变:H100s、B200s、B300s、NVL72、VR、Groq 等,每种都需要不同的策略。
理论上,代理非常适合解决这个问题。它们可以适应新的工作负载,并在不依赖固定规则或启发式方法的情况下搜索可能的优化空间,这些方法困扰着人类专家和传统的机器学习编译器。然而,当今的代理系统受限于实验的速度。
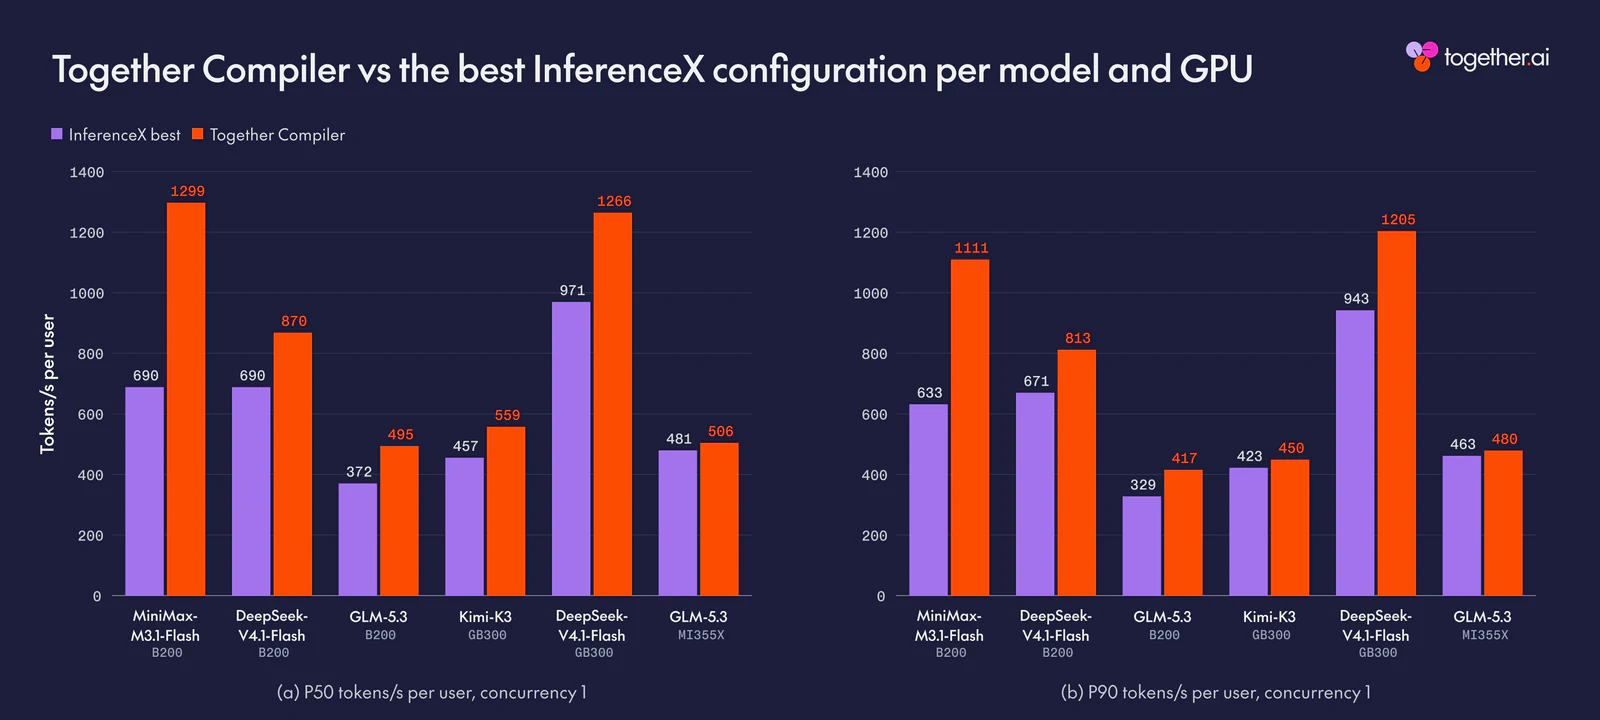
我们介绍了 Together Compiler (TKCC),这是第一个利用高通量代理来优化多样化推理工作负载的真正持续 RSI 系统。在不到 24 小时内,TKCC 在前沿开源模型(Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash)上实现了 1.3-3 倍的 TPS 提升,在 SemiAnalysis 的 InferenceX 基准测试中设置了低延迟的最佳水平,MiniMax M3.1-Flash 达到 1111 TPS,DeepSeek v4.1-Flash 达到 1205 TPS,并在 Llama 1B 批处理大小 1 的设置上比现有的开源超大规模内核高出 1.7 倍。此外,TKCC 还泛化到语言模型推理之外的领域(天气建模、PDE、时间序列和生物学)。这种性能提升得益于 TKCC 与基线代理 RSI 性能优化系统相比,实验吞吐量提高了 252 倍。Together Compiler 目前正在服务数千亿个 token。
流量在不断变化
作为推理提供者,我们看到基于区域模式、新模型发布和突发性的各种用户行为。
- 区域模式:世界各地的用户可能有不同的模型偏好。我们观察到,一个国家的上班时间流量提示比另一个国家长 1.4 倍(97k vs 70k)。
- 模型发布:用户需要时间来弄清楚如何将新模型发布集成到他们的工作流程中。首先,他们倾向于选择基于聊天的交互和评估。发布后两周,提示长度迅速增加 80%,因为用户转向了代理工作负载。
- 突发性:客户可能在一天中的随机时间发送突发请求。如果不小心处理,提示长度可能会突然翻倍,缓存命中率可能会下降。
很明显,我们必须通过为每个新部署进行专门的优化来适应不断变化的用户行为。
Together Compiler 概述
TKCC 将流量形状、模型和硬件作为输入。TKCC 使用代理为推理引擎生成一系列优化。
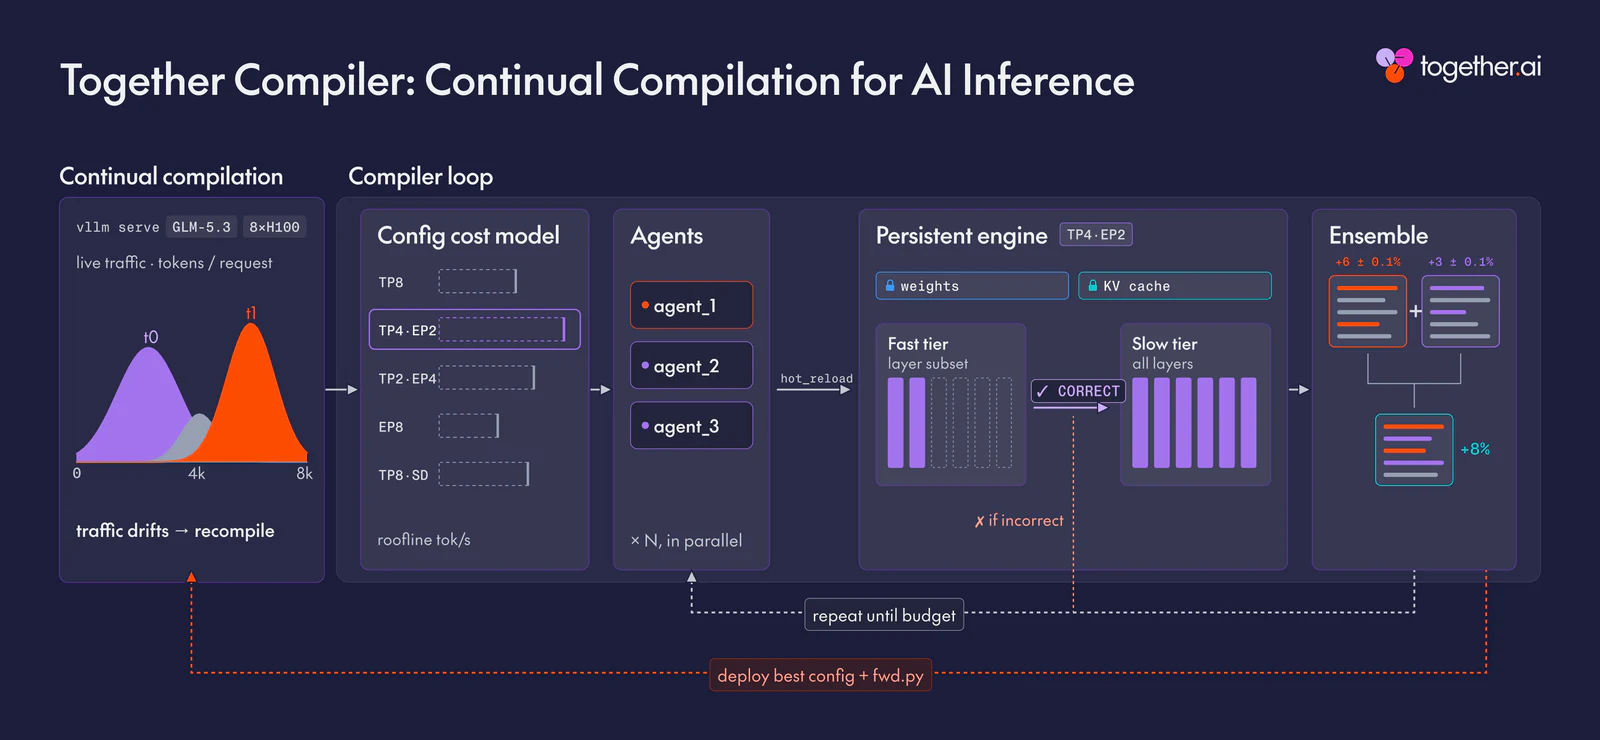
TKCC 的核心见解如下:
1. TKCC 最大化实验吞吐量并最小化代理优化期间的 GPU 空闲时间
大多数现有的 agentic RSI-inference 系统要求代理启动和拆除 VLLM、SGLang 或 TRT-LLM 引擎来测试每个新的实验。然而,引擎启动时间长达数十 分钟,显著阻碍了实验吞吐量(见下表)。相反,TKCC 提出了一种新的“持久引擎”范式,其中引擎启动一次,可以热重载任何候选前向传递,而无需任何重启。为了确保持久引擎持续有新的优化来测试,TKCC 启生多个代理,它们持续生成想法并通过消息板进行通信以并行化他们的工作。
| 阶段 | 现状 (s) | Together Compiler (s) |
|---|---|---|
| 进程 + 工作器初始化。 | 93 | – |
| 权重加载 | 50 | – |
| KV 缓存大小调整 | 21 | – |
| JIT 内核预热 | 93 | – |
| 自动调整 | 193 | – |
| API 服务器就绪 | 10 | – |
| RPC 调用 + Together Compiler 设置 | – | 1.7 |
| CUDA 图捕获 | 7 | 7.3 |
| 服务总时间 | 467 | 9.0 |
表 1: 引擎启动成本高昂
2. TKCC 平衡测量吞吐量与测量保真度之间的权衡
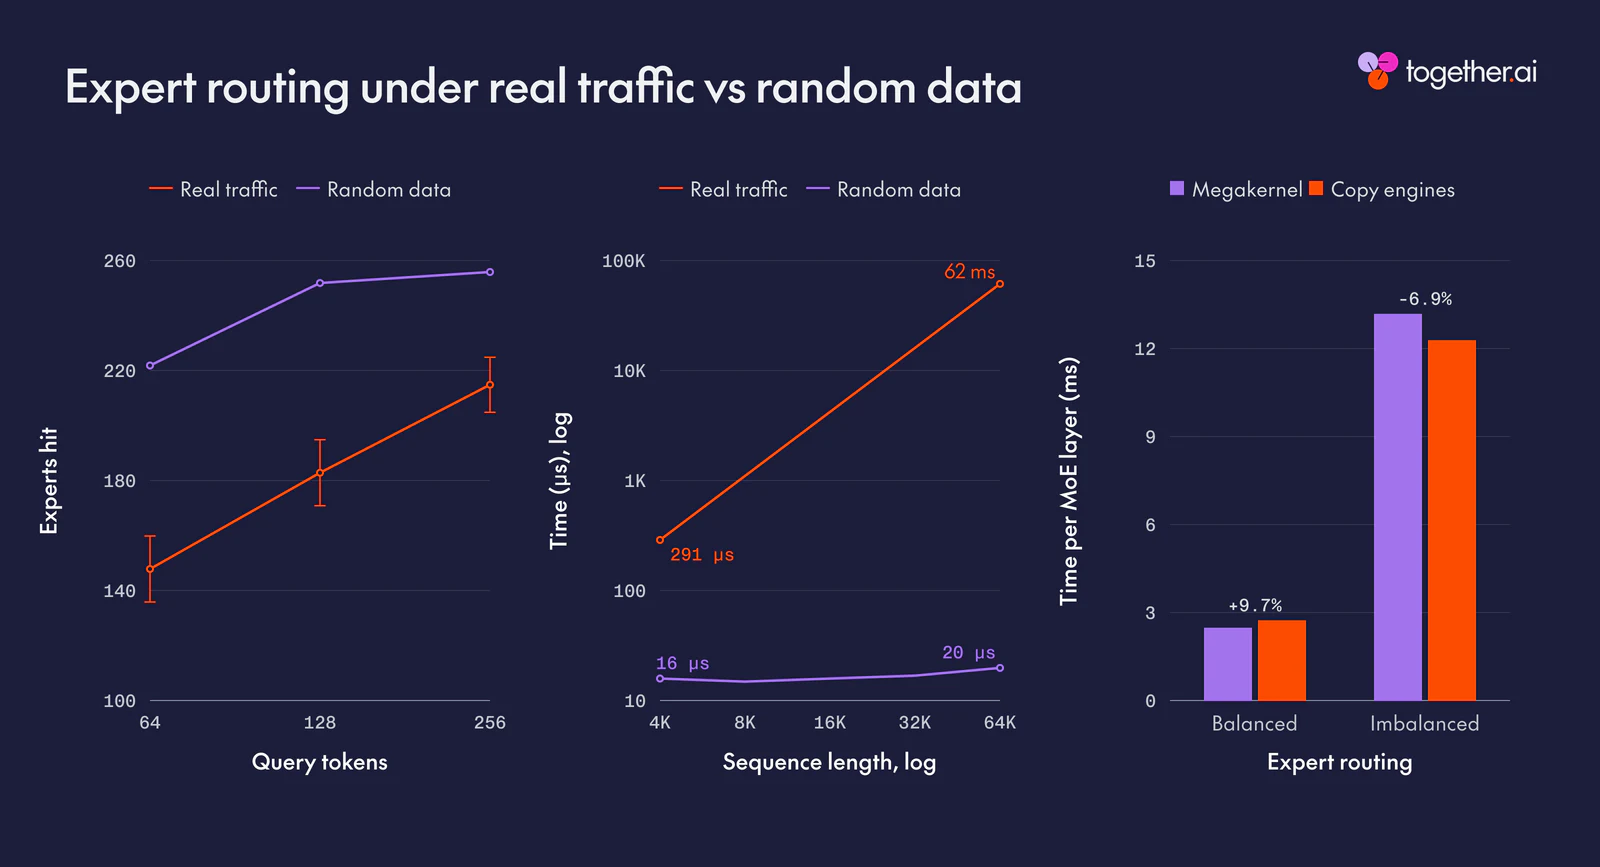
现有的代理优化系统要么迭代重新启动推理引擎,导致实验吞吐量低,要么在推理引擎之外独立优化内核,导致测量保真度差。优化独立内核的系统通常使用随机输入数据来评估它们。然而,随着使用数据相关原语(如 MoE 和稀疏-k 注意力)的现代架构的出现,输入数据分布直接影响哪种优化策略可能获胜(见下图)。高保真输入对于有效优化非常重要。TKCC 使用一组持久引擎来平衡吞吐量-保真度权衡:“快速引擎”加载几层,非常适合快速迭代和低方差时间,而“较慢引擎”加载多层,非常适合测试优化是否在真实数据分布上保持有效。

3. TKCC 利用自定义成本模型来选择并行性策略(例如,TP、EP、DCP 等)以实现代理的最高性能
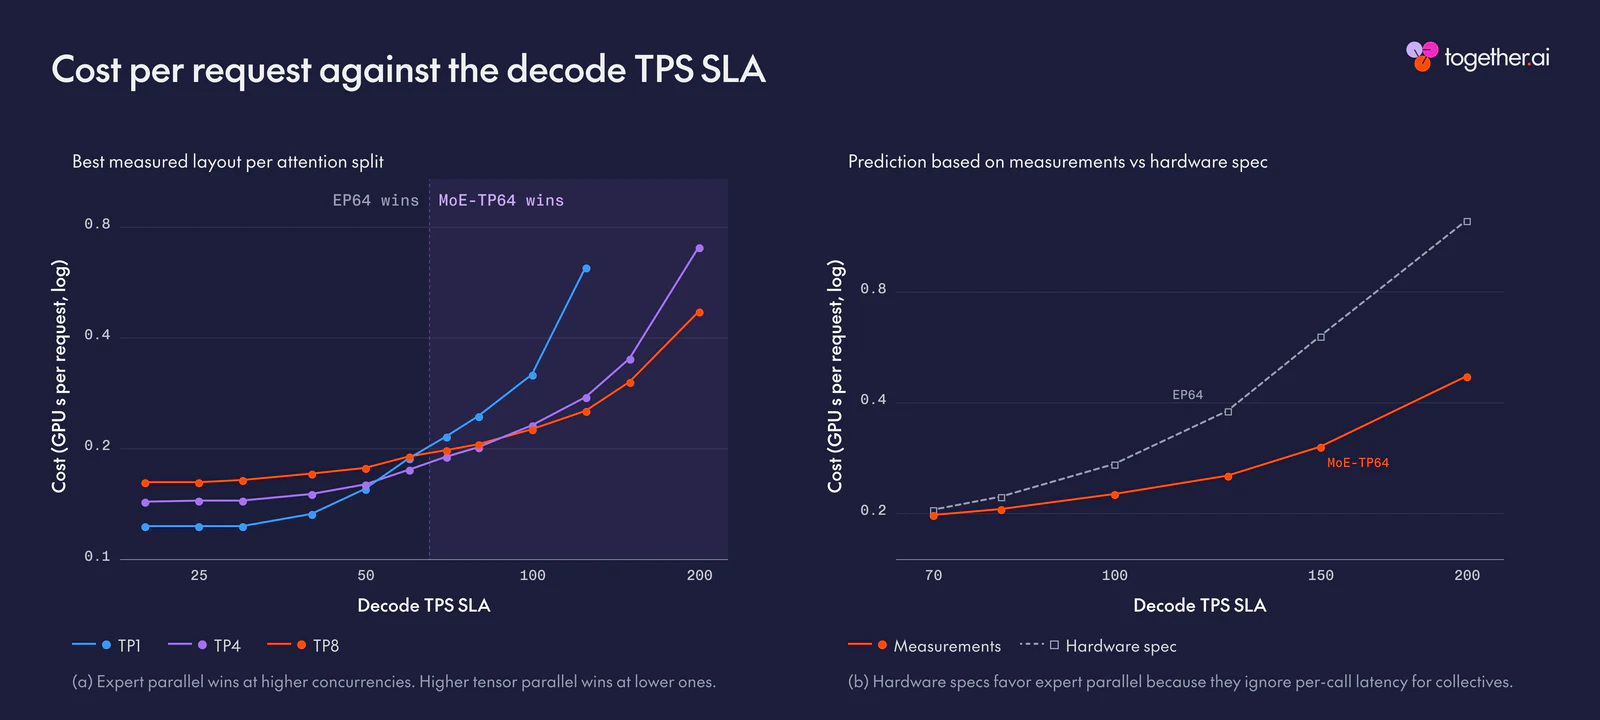
现有系统在 SLA 要求下具有选择推理配置的复杂方法。然而,选择理想配置面临着相同的吞吐量-保真度权衡:测量每个并行性配置是不可行的,特别是由于软件实现尚未成熟。一种简单的方法是根据原始硬件规格或微基准来选择并行性策略。然而,这不足以捕捉数据相关的流量特性,如 MoE 专家不平衡或不均匀的提示长度分布。我们设计了一个成本模型,该模型使用分层测量策略,涉及硬件规格、微基准和测量的前向传递,以构建高保真表示,同时快速修剪配置搜索空间以支持持续的流量漂移。
结果
我们评估 TKCC 与三种不同的基线:手工调优的 megakernels、InferenceX 引擎配置,以及来自天气建模、PDE、时间序列和生物学模型的流行 AI 代码库。
MegaKernel 工作负载
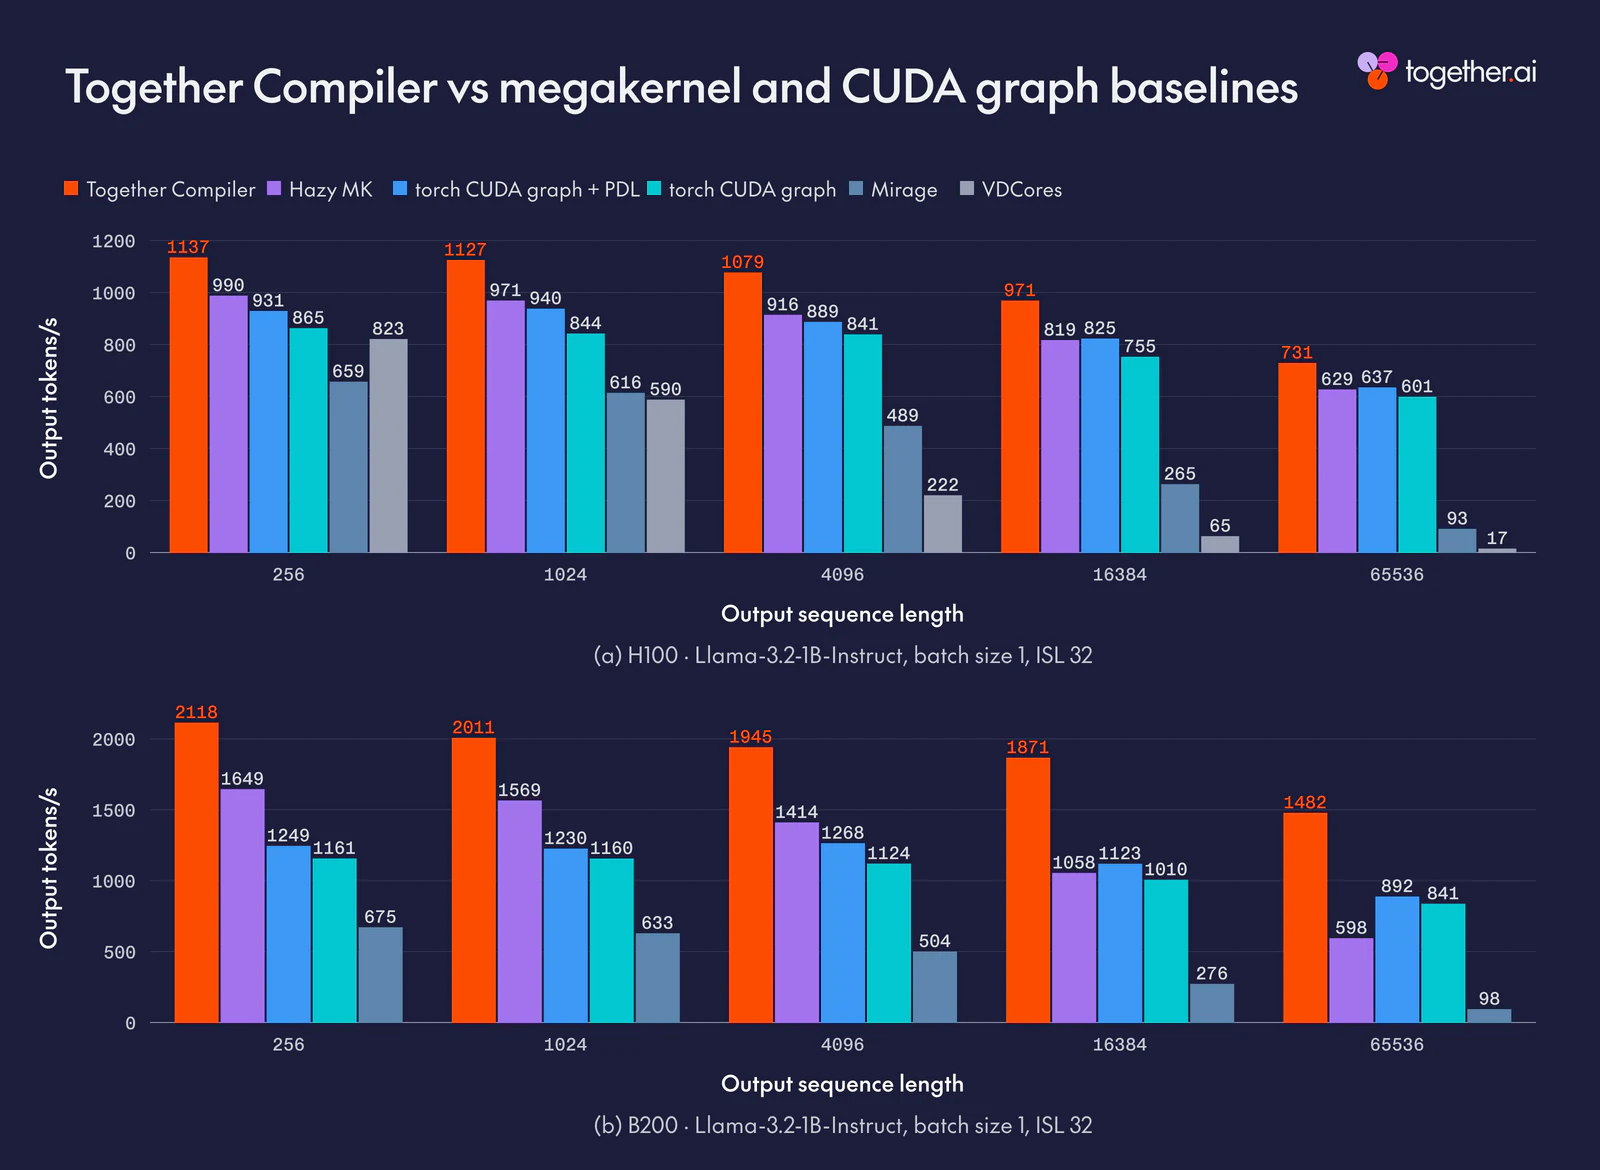
我们首先评估经典的 MegaKernel 工作负载:Llama 1B 在批处理大小为 1 的情况下。这种模型架构已被人类专家和传统机器学习编译器充分优化。TKCC 生成 TPS 高出 1.7 倍,并且随着序列长度的增加,性能持续表现良好。
InferenceX AgentX 工作负载
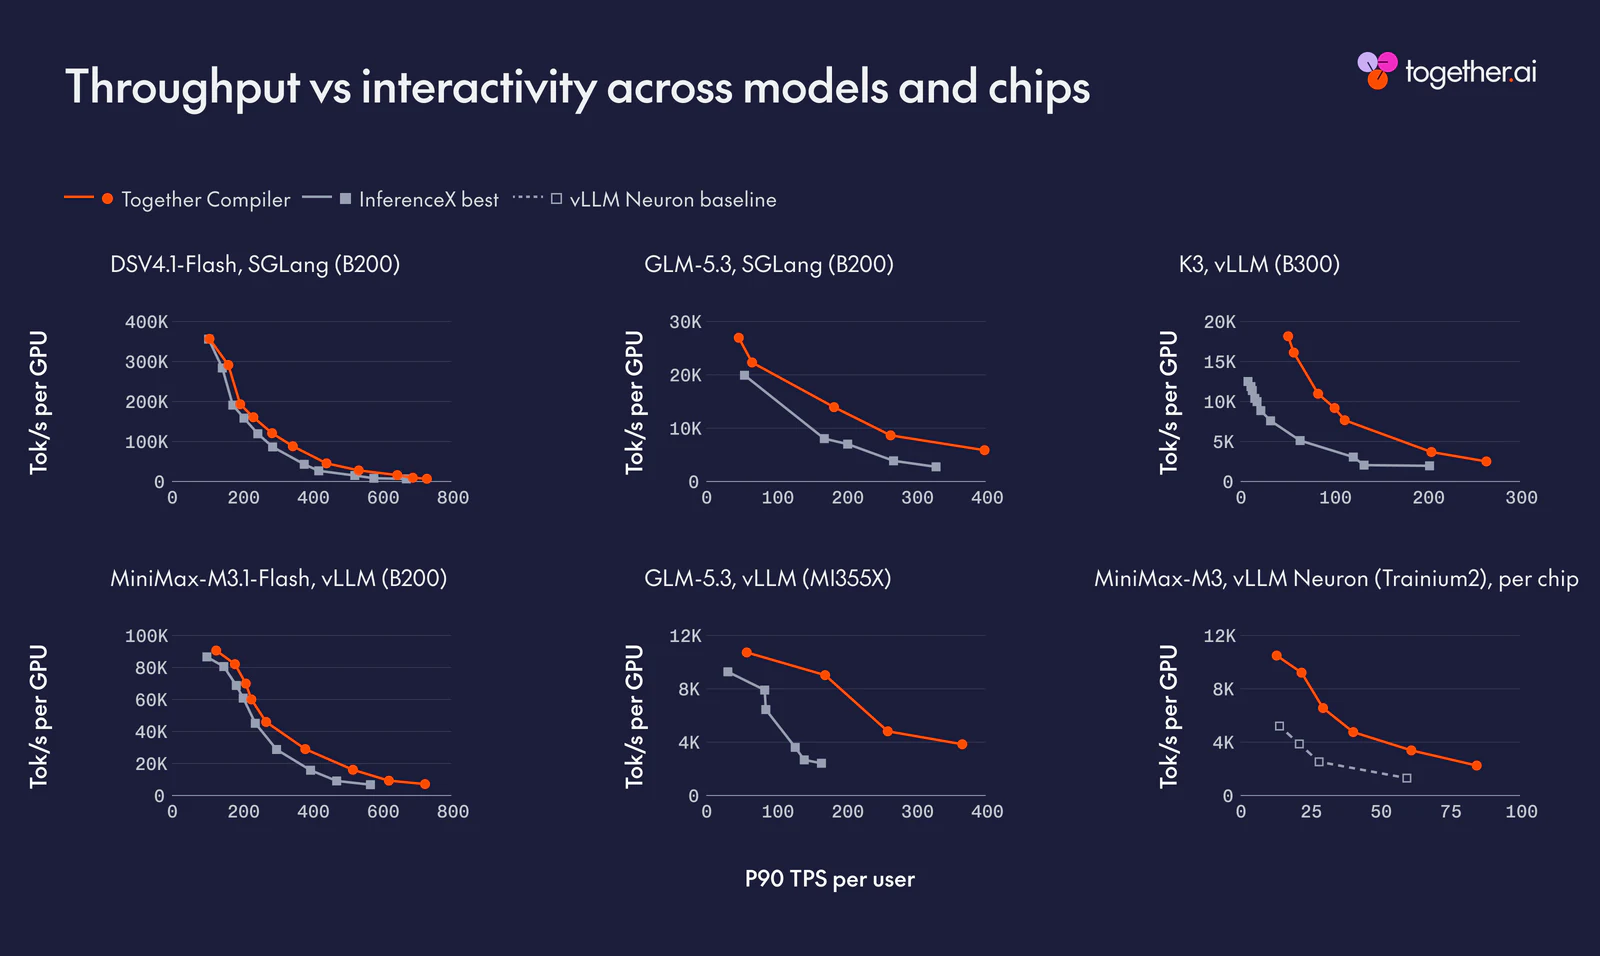
我们在 SemiAnalysis 的 AgentX 基准上评估 TKCC。我们从跨推理引擎和硬件平台的边界模型的最佳报告开源引擎配置开始。TKCC 在所有设置中始终设定性能边界,比高度优化的基线 TPS 高出 1.3-3 倍1。
我们还针对批处理大小为 1 的低延迟用例进行评估,并在 MiniMax M3.1-Flash 上以 1111 TPS、在 DeepSeek v4.1-Flash 上以 1205 TPS 设定最先进性能。对于这些结果,我们使用我们的成本模型选择并行配置,而不是使用 InferenceX 配置。我们观察到这种方法带来的加速。
跨 AI 工作负载
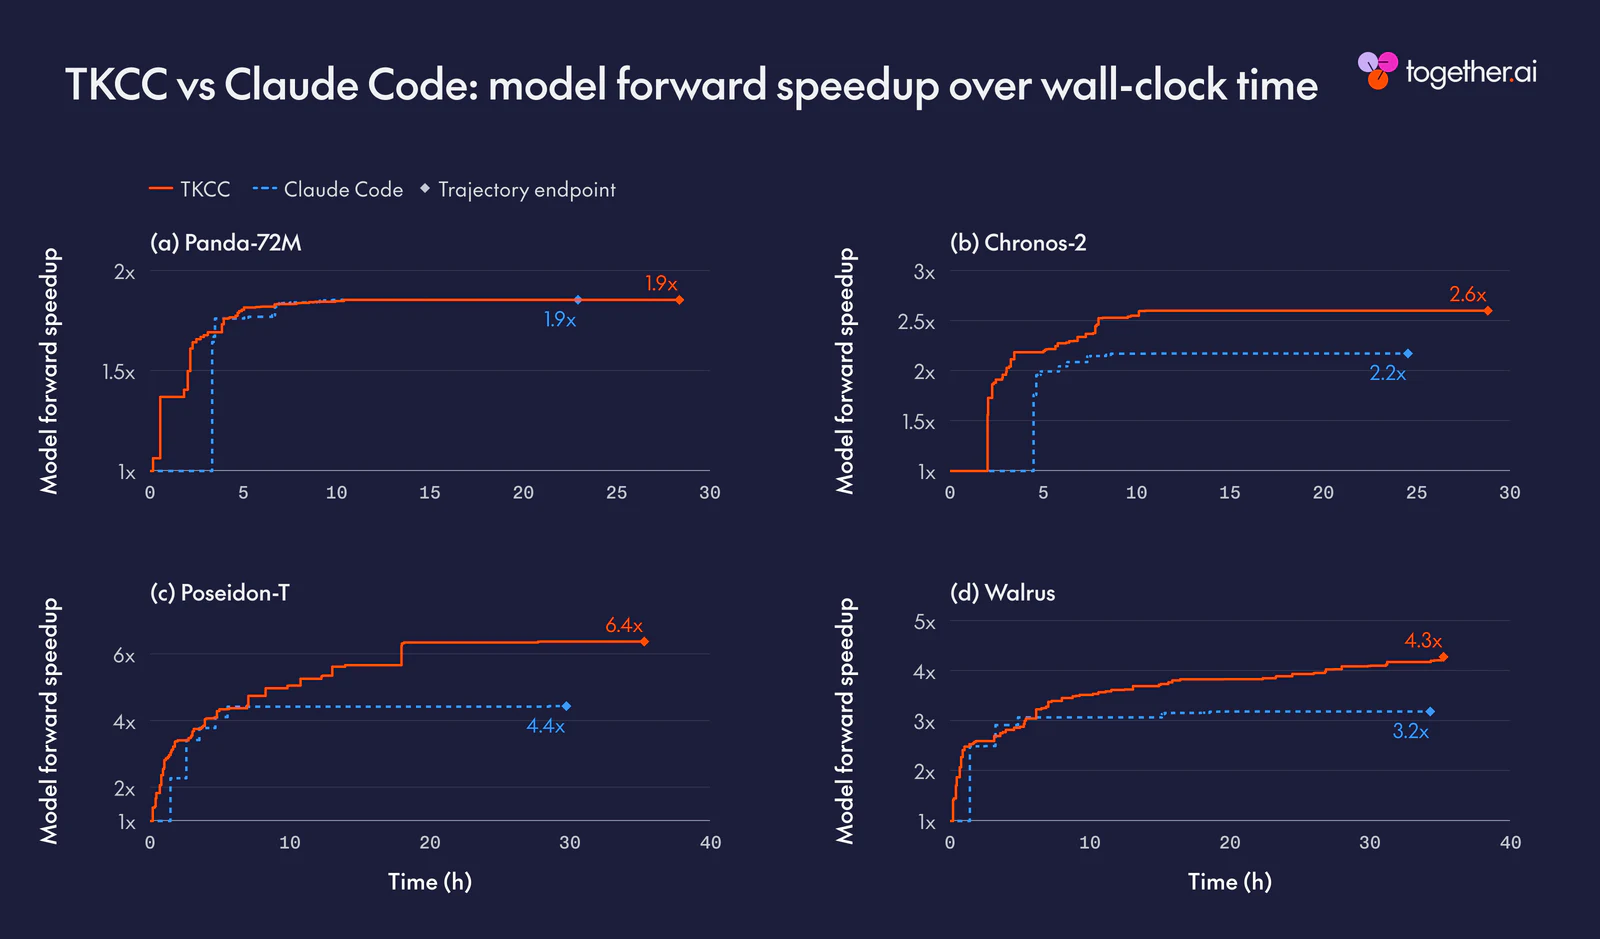
我们选择了来自天气建模、PDE、时间序列和生物学的流行开源代码库。我们展示了 TKCC 相对于仅使用 Claude Code 并带有 /goal 命令的几何平均加速,说明 TKCC 的原理可以泛化到各个领域。我们一直在将 TKCC 作为通用 AI 编译器使用,而不仅仅是用于 LLM 推理。
多态 AI 系统是下一个前沿
对于 Together AI,最令人兴奋的系统挑战是 多态推理。推理不再是为了针对单个硬件平台和模型的单一流量形状进行优化,流量不断动态变化,就像金融市场一样,这种动态性开辟了一系列新的研究问题。
查看我们的 论文了解更多。
如果这些 AI 系统的前沿让你兴奋,请随时 联系我们!
1 Trainium2 在合成多轮数据集(70k ISL,3.5k 新 ISL 95% 缓存,700 OSL)上运行,而不是在 AgentX 上,因为我们的实现尚未在有限的 HBM 容量上支持更高的并发性。
来源: Together AI Blog · together.ai