跳到正文
实时

技术方向

部署工程

把模型跑起来的工程实践:推理优化、显存与成本、Serving 架构与基础设施选型。

66篇精选
62本月
11月14日 21:05更新于
本月仍有更新

最新报道

11月14日周六1–20
  1. 量子位80

    DeepSeek 开放全家桶应用 API,语音接口首次加入

    DeepSeek 宣布正式开放全家桶应用 API,联网搜索、深度思考搜索、文件上传、链接阅读等 App 内功能均提供独立接口,可单独调用、分别计费。语音能力首次加入开放行列,包含 ASR 和 TTS 接口,语音识别原价 0.78 元/小时、现五折 0.39 元/小时,语音合成每万字符 1.5 元。

    推荐理由: 原文列出 DeepSeek 开放的工具接口清单与五折语音定价,读者可据此估算语音助手、文档处理类应用的调用成本。

  2. IT之家 · AI72

    Cloudflare 开源 AI 智能体浏览器 Kitesurf,资源消耗低于 Chromium

    Cloudflare 宣布开源今年 8 月推出的 AI 智能体浏览器 Kitesurf,代码已发布在 GitHub。Kitesurf 运行在 Cloudflare Workers 上,无需 Chromium 进程或容器即可完成 HTML 解析、CSS 应用、执行页面 JavaScript 和截图渲染,并支持 Chrome DevTools Protocol。

    推荐理由: Cloudflare 开源了专为智能体设计的浏览器,并给出与 Chromium 的资源对比,读者可据此判断高并发智能体任务的部署成本。

  3. LangChain Blog60

    LangChain 完成 3 亿美元 C 轮融资,估值 30 亿美元。

    LangChain 宣布完成 3 亿美元 C 轮融资,估值 30 亿美元,由现有投资方 CapitalG 领投,GIC、DFJ Growth 等新投资方参与。公司称已有超过 7000 家机构使用 LangSmith,Clay 用它每月监控数亿次 Agent 运行,Workday 将新 Agent 部署时间从五个月缩短到一天以内。

    推荐理由: LangChain 公布 3 亿美元 C 轮融资,并给出 LangSmith 在运行时、改进与治理三层的产品结构,可据此判断其 Agent 平台的定位。

11月13日周五
  1. Hugging Face Blog65

    llama.cpp 与 ggml 发布 v1.0.0,确立语义化版本规则

    llama.cpp 与 ggml 发布 v1.0.0,将公共 C API 的破坏性变更与主版本号绑定,后续两者都按语义化版本规则发布。项目已支持超过 150 种模型架构和主流投机解码方法,并提供 Linux、macOS、Windows、Android、iOS 的预发布产物及 Docker、Homebrew、conda-forge 等分发渠道。

    推荐理由: llama.cpp 与 ggml 同步发布 v1.0.0,并明确主版本号对应 C API 破坏性变更,下游依赖者可据此规划升级节奏。

  2. vLLM Blog60

    vLLM 在发布首日支持 Thinking Machines 的 Inkling 2 Small

    vLLM 在 Inkling 2 Small 发布首日提供支持。该模型是文本与视觉输入的多模态 MoE,总参数 594B、激活参数 17B,上下文最长 1M tokens,并自带 DSpark 推测解码器。

    推荐理由: 原文给出了 vLLM 对 Inkling 2 Small 的 Day-0 支持细节与多项内核优化,读者可据此了解该模型的部署路径与吞吐表现。

  3. Databricks Blog60

    Databricks 推出 Lakehouse//RT,面向智能体实时分析负载。

    Databricks 发布 Lakehouse//RT,用于在湖仓上直接承载 AI 智能体带来的高并发实时查询,目前处于 beta 阶段。官方称可在 12,000 QPS 下提供低于 100 毫秒的延迟,并通过高并发、快速执行、小步扩容和单一系统四条路径让成本增速低于查询量增速。

    推荐理由: 原文给出四个降本机制和三家客户的迁移数据,可据此判断实时分析层是否值得替换。

11月12日周四
  1. vLLM Blog60

    vLLM-Omni 在 NVIDIA Vera Rubin 上支持 MiniMax H3-Image,4K 生成 0.87 秒

    vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。

    推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。

  2. AWS Machine Learning Blog60

    AWS开源UAEF:跨框架闭环评测AI智能体

    AWS 发布开源框架 UAEF,用适配器将 LangGraph、LangChain、Strands Agents、Amazon Bedrock AgentCore 和 Langfuse 的执行轨迹统一为 AgentTrace,再用 7 个维度 36 项内置指标打分。

    推荐理由: 原文给出跨框架统一评测的适配器与指标设计,读者可据此判断多框架智能体版本对比的落地方式。

11月11日周三
  1. Databricks Blog76

    Databricks 将 Genie One 升级为企业 AI 协作工作台

    Databricks 宣布 Genie One 成为企业 AI 协作的统一入口,将搜索、产物生成和跨工具操作集中到一处,并基于 Genie Ontology 提供企业上下文,由 Unity Gateway 统一治理。

    推荐理由: 原文给出 Genie One 从问答扩展到产物生成、跨工具执行与治理的具体能力,可据此判断企业 AI 工作台如何落地。

  2. Databricks Blog66

    Databricks 宣布 Genie Ontology 正式可用

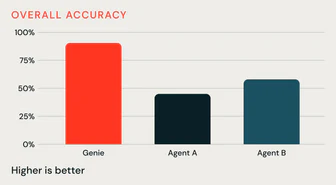
    Databricks 宣布 Genie Ontology 正式可用,由智能体从仪表盘、SQL 查询、notebook 和语义模型中持续学习业务上下文,再由人通过 Unity Catalog 治理关键定义。

    推荐理由: 原文给出与 Turing 共建基准的通过率、耗时和 token 对比,可据此判断企业上下文层对智能体准确率的影响。

  3. Databricks Blog80

    Databricks发布新版Genie:面向复杂企业工作的自主AI同事

    Databricks 发布新版 Genie,定位为自主 AI 同事,可持续跟踪进度、追问缺失输入并在新信息到达时采取行动,用户设定护栏并审批关键环节。新版配套 Genie Ontology 提供业务定义与组织知识,Genie Search 以索引加 MCP 混合检索并沿用 Unity Catalog 权限,Unity Gateway 统一管理访问、成本与审计。

    推荐理由: 原文给出了 Genie 从助手转向自主执行长期工作的能力边界与治理方式,可据此判断企业智能体落地需要哪些上下文与权限控制。

11月9日周一
  1. 量子位72

    百度文心首次披露 RSI 进展,ERNIE Evolve 已用于文心 5.5 Flash 研发

    百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。

    推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。

  2. NVIDIA Newsroom78

    NVIDIA 在 CoRL 发布 GR00T 2 世界动作模型与 Isaac Lab 3.0

    NVIDIA 在 CoRL 上发布开源世界动作模型 GR00T 2,基于 NVIDIA Cosmos 构建,使用 10 万小时 NVIDIA 开源人类第一视角数据训练,可在无任务专属演示的情况下完成 50 项评测任务中的 40 项。

    推荐理由: 原文给出 GR00T 2 在少样本任务上的成功率与 Isaac Lab 3.0 的训练吞吐提升,可据此判断仿真训练对机器人落地的推进程度。

  3. IT之家 · AI82

    美团龙猫开源 LongCat-2.5 模型,总参数 1.6 万亿、支持百万上下文

    美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。

    推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。

  4. 量子位72

    量子位实测 LobeHub AI 协作平台:主管 Agent 派活、招人、接力交付

    量子位作者用 LobeHub 组建 AI 编辑部实测:主管 Agent Sienna 在不到 8 分钟内分派三位小编产出 6 条选题简报,随后自行新建网页开发和 QA 两个 Worker,沿用上一轮成果在约 30 分钟内做出可筛选的资讯看板。

    推荐理由: 作者用两轮实测展示主管 Agent 如何派活、临时招人并接力交付,可观察多 Agent 协作的实际边界。

  5. Hacker News · 300+ 热帖78

    llama-modchip 使 284B DeepSeek-V4-Flash 在 64GB 内存无 GPU 运行

    llama-modchip 发布了一组 ggml/llama.cpp 内核补丁与量化转码工具,将 284.33B 的 DeepSeek-V4-Flash 压缩到 56.56 GiB(1.71 bpw),可在 64 GB 内存的纯 CPU 机器上运行,256K 上下文下峰值内存 57.61 GiB 且无需 swap。

    推荐理由: 项目给出了在 64 GB 内存上运行 284B MoE 的量化方案与内核补丁,并附各硬件实测数据,可据此判断纯 CPU 部署的可行边界。

11月7日周六
  1. 量子位72

    GitHub频繁故障后,OpenAI拟收购Pierre、Anthropic自研Scion、Cursor推Origin

    AI写代码速度加快导致GitHub多次故障,OpenAI拟收购代码托管工具Pierre,并已公开内部Git后端Pando,一次推送的中位耗时降了近八成。Anthropic因日均合并改动从5月约2500项增至9月超3万项,由7名工程师用5个月自研版本控制系统Scion并迁移主代码库;Cursor则推出代码托管服务Origin,允许开发者在Cursor内完成提交、审查与合并。

    推荐理由: 从GitHub故障切入,串起OpenAI、Cursor、Anthropic自建代码基础设施的动因与做法,可看清AI写代码对开发工具链的实际压力。