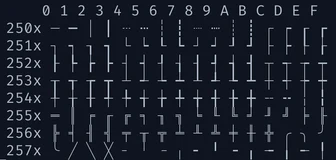
终端边界技术 Cell Borders:不占用单元格空间的绘图方案
终端协议通过在单元格边缘绘制细线替代传统边界字符,实现不占用额外行列空间的边界绘制,其演示应用在 Ratatui 中支持多种场景,包括面板、菜单、图表等,且边界可自定义样式与连接方式。
终端协议通过在单元格边缘绘制细线替代传统边界字符,实现不占用额外行列空间的边界绘制,其演示应用在 Ratatui 中支持多种场景,包括面板、菜单、图表等,且边界可自定义样式与连接方式。
 IT之家 · AI5858
华为麒麟 9050 系列搭载第四代 GPU 微架构,性能提升 40%、功耗降低 45%,二代硬件光追性能提升 78%,支持 BVH、FERT、AO 硬加速单元;新一代 AI ISP 集成像素专用 NPU,首次实现 2 亿像素融合拍照,支持 4K60 视频处理、18EV 高动态视频及全链路 BT.2020 广色域。
 Hugging Face Daily Papers
Test-Time Baking (TTB) 策略通过将交叉视图注意力中的全局场景信息烘焙到轻量级 MLP,在保持 Test-Time Training 效率的同时提升了大视图合成模型(LVSMs)新视角解码的保真度,在多个基准测试中实现了高达 23 倍的渲染速度提升且质量与当前最优技术相当。
 Baseten Labs6565
Claude Code v2.1.159 发布,采用梯度对齐奖励机制,在四则运算任务上使用 Qwen3-8B 模型,通过计算学生输出与专家演示的梯度相似度进行奖励,实验显示模型可能过度拟合专家示例的精确措辞。
 TechCrunch · AI精选8282
TechCrunch 采访的多位投资人和创始人认为,黄仁勋卸任英伟达 CEO 后,公司对 AI 初创的投资可能明显收紧。据 PitchBook 数据,英伟达今年参与了 105 轮融资,且常为最大投资方,曾投资 CoreWeave、Crusoe、Mistral AI、Lambda 和 Black Forest Labs,并以 130 亿美元收购 Hugging Face。
推荐理由: 文章呈现了黄仁勋离任后英伟达投资策略可能收紧的多方判断,读者可据此理解 AI 初创融资格局的变化。
 AWS Machine Learning Blog
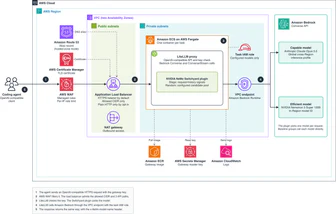
开发者使用 Claude Code 和 OpenAI Codex CLI 等编码智能体时,需按任务而非单次调用付费,因此模型路由应基于每项任务的成本。NVIDIA NeMo Switchyard 是一个开源库,可帮助 AI 智能体选择处理每个请求的模型,支持 Stage 和 Random 两种路由策略。
 NVIDIA Technical Blog6565
NVIDIA Jetson AGX Orin 通过 cuDLA 可在 Python 中运行原生 DLA 推理,支持在 DLA 硬件上执行特定神经网络操作以卸载 GPU 推理任务,提升边缘端应用的能效。
 The Decoder6565
OpenAI 发布 ChatGPT Wallet 让 AI 智能体代用户付款,在美国通过 Dots 服务提供,需 ChatGPT Pro 订阅和合资格银行卡,每次支付需用户 Face ID 或指纹验证,不暴露真实卡信息,现有卡奖励和银行保护适用。
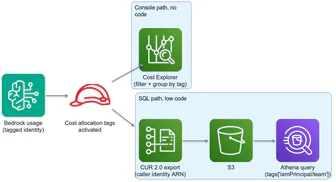
AWS Machine Learning Blog3838Amazon Bedrock 通过内置的零 instrumentation 成本归因功能,将每一次推理调用追踪到 IAM 主体,并将身份信息与组织标签传递至 AWS Cost and Usage Reports (CUR 2.0) 和 AWS Cost Explorer,同时保持数据在 AWS 安全边界内。
AWS Machine Learning BlogAssemblyAI 通过混合使用 AWS 的 EC2 On-Demand 和 Spot 实例,并利用 Amazon ECS、SQS 和 EventBridge 构建弹性架构,以 3.5 倍的速度提升 GPU 实例利用率,在欧洲 AWS 区域内实现成本降低并满足服务等级协议(SLA),其推理平台部署在 g4dn、g5、g6 三种 GPU 实例家族上。
 Ai2 Blog同一件事 · 2 家4040
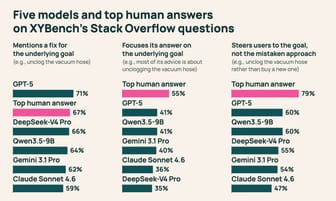
XYBench 发布,包含 8K+ 问题测试 AI 助手如何应对基于误解的请求;Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中常聚焦原错误方法而非用户实际目标。
各家口径不同:Ai2博客称基准测试包含8K+问题,而Hugging Face博客提到8150个问题。
 Hugging Face Blog同一件事 · 2 家4040
Hugging Face 发布 XYBench 基准测试,包含 8150 个真实问题,评估 AI 助手识别用户误解并引导至正确解决方案的能力。Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中倾向于关注用户错误假设(Y),而非实际目标(X),其中只有 35-41% 的回答以实际目标为中心。
 Databricks Blog
Databricks 发布了 Genie Migrate,现支持从 Microsoft SQL Server、Azure Synapse、Teradata、Oracle、Snowflake、Amazon Redshift、Google BigQuery 迁移至 Lakehouse,自动转换 SQL 代码至 ANSI SQL。
Hugging Face Daily PapersSparseRead 控制层通过 Read Intent Protocol、Adaptive Reader Backends 和 Budgeted Read Gate,在不修改智能体模型的情况下减少 AI 智能体对外部内容的过度读取。
Hugging Face Daily Papers6565PhysLoop 利用大语言模型指导视频生成、选择和修正,实现物理一致的自我改进和可控数据构建。该框架通过识别和纠正生成视频中的物理错误,推动视频生成模型有限人工干预下的递归自我改进(RSI),并发布包含 100K 视频的多样性数据集及生成工具。
Hugging Face Daily Papers6565决策模型即使作为行动者表现不佳,通过评判完整行动轨迹也能有效教授强化学习策略,在 ALFWorld 和 WebShop 上提升成功率。
Hugging Face Daily PapersDuo v1 引入互惠世界模型(RWM),通过自回归推理、同步注意力和双重推演蒸馏联合建模意图与现实,实现实时全双工音视频交互。该模型持续感知音视频输入的同时实时响应用户,将智能与物理现实视为同等基础构成世界,支持对话、共享对象、重塑虚拟场景等交互,首批模型已开源。
smolmaxxing 项目通过定制内核、优化内存使用和从闪存流式传输权重,使大语言模型能在小米电视盒子、iPad Air 等老旧设备上运行。在小米电视盒子上,Qwen3.5-2B 模型每秒处理 7.7 个 token,Ling-mini-2.0 模型每秒处理 5.1 个 token。更多设备支持即将推出。
Hugging Face Daily PapersBirdDreams 联合生成视角视频和鸟瞰视频(BEV),使场景布局成为预测未来的部分,通过 BEV 提供车辆位置和运动的俯视图,减少遮挡,而视角视频保留场景细节。在 PhysicalAI-AV 和 nuScenes 上,BirdDreams 比先前的驾驶世界模型更忠实地遵循输入的自身轨迹,并生成更合理的自身运动,无需 HD 地图或车辆状态输入。
IT之家 · AIAxelera AI 公布数据中心级 AIPU 芯片 Titania 架构,2027年Q3投产,设计功耗400W,含2个基于第三代D-IMC计算芯粒,FP8算力2.5PFLOPS,支持MXPF4/MXFP8格式,集成128MB SRAM缓存和32个RISC-V内核。
IT之家 · AI阿里巴巴旗下 AI 音乐创作平台快乐虾米(HappyShrimp)正式上线 iOS 与 Android 平台,App Store 版本为 0.2.14。该平台支持自然语言描述生成人声歌曲和纯音乐,拥有音乐世界知识,提供智能歌词和纯音乐两种模式,标准会员每月 30 元可生成 150 首歌曲。
IT之家 · AI4040三星与中国电信联合推出的心系天下 W27 折叠屏手机正式开售,提供 16GB+512GB(18999 元)和 16GB+1TB(21999 元)两个版本。基于 Galaxy Z Fold8 Ultra 打造,配备天通卫星通信服务,包含 1 年直连卫星功能、300 分钟通话和 100 条短信,并支持领取 2 亿电信 Token 权益。
 GitHub Blog · AI & ML5858
Agent技能允许捕获可重复指令供用户和智能体复用,通过以SKILL.md文件为中心的版本化目录定义任务执行时机与方式。Proof Agent使用独立验证器对抗性验证AI生成内容,Data Forge则通过多个协同技能构建支持台指标管线,各技能共享通过manifest定义的上下文而非独立重发现。
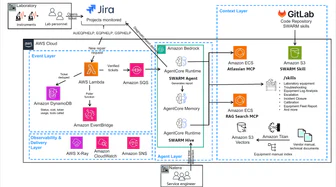
AWS Machine Learning BlogNatera 为解决实验室设备故障导致的知识断层问题,开发 SWARM 智能体系统,通过 Amazon Bedrock AgentCore 实现 130 倍响应提速和 96.2% 自动化处理支持工单。
Databricks BlogGenie Migrate 正式可用,帮助用户轻松迁移至 Databricks Lakehouse,支持大规模数据迁移并保持性能。
TechCrunch · AINectar 推出“创作者智能体”可搜索超 3 亿创作者、分析内容与品牌合作,自动发送个性化消息并管理合作,支持 Instagram 创作者和 TikToker,全球可用并计划通过 Model Context Protocol (MCP) 集成 Claude、ChatGPT、Copilot 等其他 AI 助手。
AWS Machine Learning Blog3838开发者可通过 Amazon Bedrock 应用推理配置文件和 LiteLLM 快速访问基础模型,实现单 API 访问、用户级成本控制和模型性能可观察性。
 Mastra Blog
Mastra 允许用户通过自定义模型网关将代理请求路由到自托管的开源权重模型,例如使用 private/ollama/gpt-oss:20b 配置,使敏感数据不离开网络并降低成本;通过设置 AUTO_BLOCK_EXTERNAL_PROVIDERS=true 可在 Studio 中隐藏外部提供者。
TechCrunch · AI6565Phota Labs 应用通过 AI 将日常照片转为专业级影像,同时保留照片真实性。该应用专注于修复拍摄本身的问题,而非增强已不佳的照片。用户可选择不同摄影风格进行 AI 转换,并使用个性化技术学习用户身份以保持照片真实性,应用内嵌不可见水印以标识 AI 编辑内容,目前以免费模式推出以积累用户基础。
 Replit Blog
Replit Agent 可代理商业采购和运行谷歌广告,需创始人批准支出。该功能支持美国核心及专业用户一次性采购,并允许专业用户全球创建谷歌广告账户,由 Agent 分析内容、生成广告素材并推荐预算。
The DecoderElevenLabs 发布 Scribe v3 和 Scribe v3 Live 语音转文本模型,针对嘈杂环境,Scribe v3 适用于预录音频,Scribe v3 Live 适用于低延迟实时应用。
IT之家 · AI新华三完成 H3C UniServer R4930 G7 服务器核心平台迭代升级,搭载全新国产处理器,单机最高 192 核、768 线程,单线程 IPC 性能提升超 15%。
 量子位精选同一件事 · 2 家8282
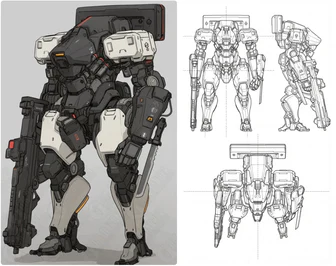
MiniMax开源图像模型H3-Image支持原生4K(4096×4096像素)生成,最多可输入16张参考图。作者实测其能根据产品外观图推演正交三视图和机械爆炸图,并在人脸毛孔、雀斑等细节上减少塑料感。API价格为主流竞品的50%到70%,首周16MP请求再打五折。
IT之家 · AIApex Compute推出的ANR跨平台AI渲染技术测试版,包含AI帧生成、超分辨率和光线重建功能,兼容英伟达、AMD、英特尔显卡及Steam Deck,目前仅AI帧生成功能开放测试。
 OpenRouter Blog
OpenRouter 现支持简体中文、西班牙语、日语和韩语等 8 种语言,本地化功能已进入 Beta 测试。其系统通过每日检测代码中变更的字符串,使用 GPT-6.1 Sol 进行翻译,再经代码检查和第二模型验证,实现自纠正。当翻译失败时,系统会附带原因重新尝试,错误会被记录为规则或测试用例。整个流程在 OpenRouter 内运行,翻译数据存储于代码侧 Git 仓库。
Hugging Face Daily Papers6565One Table Benchmark 测试了 46 种模型在 56 个数据集上的表格生成、插补和预测能力,发现这些任务共享条件信息但保真度和目标交互不同,固定模型在效用和保真度间存在权衡,冻结的基础模型在预测和数值插补方面表现突出,表明统一表格模型有潜力提升分类重建和联合采样。
 36氪 · AI同一件事 · 2 家4545
豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并推出限时特惠计划。用户可根据实际工作需要选择相应模型完成任务。
IT之家 · AI同一件事 · 2 家豆包工作拓展模型选择,首批接入 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 三款第三方模型,同步上线额度消耗倍率与限时优惠。模型选择页面标注额度消耗倍率,用户可权衡效果、速度与成本;工作日及节假日指定时段使用参与活动模型可享额度消耗折扣,豆包 2.1 Lite 与 DeepSeek V4.1 Flash 额度消耗倍率下调。
OpenRouter Blog自托管 LLM 仅在 GPU 负载足够高时才比 API 便宜。以 2026 年 10 月 8 日价格为例,27B 模型在租用 RTX 3090 上需 6-12% 负载才与 API 平衡,而 DeepSeek V4.1 Flash 在四台 H200 上永无平衡点。
IT之家 · AI6565AMD 推出 MEXT 内存解决方案,通过软件协同管理 DRAM 内存与 NVMe 固态硬盘,将不常访问的“冷数据”转移至闪存并利用 AI 预测提前调回 DRAM。