DeepSeek 开放全家桶应用 API,语音接口首次加入
DeepSeek 宣布正式开放全家桶应用 API,联网搜索、深度思考搜索、文件上传、链接阅读等 App 内功能均提供独立接口,可单独调用、分别计费。语音能力首次加入开放行列,包含 ASR 和 TTS 接口,语音识别原价 0.78 元/小时、现五折 0.39 元/小时,语音合成每万字符 1.5 元。
推荐理由: 原文列出 DeepSeek 开放的工具接口清单与五折语音定价,读者可据此估算语音助手、文档处理类应用的调用成本。

DeepSeek 宣布正式开放全家桶应用 API,联网搜索、深度思考搜索、文件上传、链接阅读等 App 内功能均提供独立接口,可单独调用、分别计费。语音能力首次加入开放行列,包含 ASR 和 TTS 接口,语音识别原价 0.78 元/小时、现五折 0.39 元/小时,语音合成每万字符 1.5 元。
推荐理由: 原文列出 DeepSeek 开放的工具接口清单与五折语音定价,读者可据此估算语音助手、文档处理类应用的调用成本。
CDPR 为《巫师 3:狂猎》新 DLC 中的杰洛特波兰语配音采用 Respeecher AI 技术,将 Jacek Rozenek 中风后沙哑的声音调整至早期效果。Rozenek 亲自录制新台词,Respeecher 利用其早期声音模型进行转换,重点还原其情绪表达。CDPR 表示未来可能不再使用此方式,且 Rozenek 当前嗓音或适合塑造更年长的杰洛特。
LiquidCodec 是 Liquid AI 开发的音频标记化技术,用于其最新的 LFM3-Audio-2B 和 LFM3-Omni-2B 多模态设备端智能模型,在 74M 参数规模下实现高保真音频重建与 1.1 kbps 压缩率,同时比同等规模模型在语音生成和 token-to-waveform 解码速度上分别提升 3.5 倍和 8 倍。
各家口径不同:Liquid AI博客提到1.1 kbps的压缩率和3.5倍及8倍的速度提升,而MarkTechPost没有提到这些数据。
Meta 的 AI 代理 Muse 已向美国付费订阅用户推出代打电话功能,该功能在 9 月进行测试,可处理有线电视公司、DMV 和餐厅的繁琐电话,Meta AI 首席 Alexandr Wang 表示该代理拥有超过 1000 万用户,并将很快获得免费邮箱地址。
ElevenLabs 发布了实验性应用 ElevenAI,集成会议笔记、语音转写与智能体功能,支持跨会议数据查询和实时协助,旨在作为团队协作工具而非个人生产力工具。该应用支持 90 多种语言语音转写,能理解行业术语,并允许企业集成 ElevenAgent 执行后续操作,如根据会议笔记起草邮件。
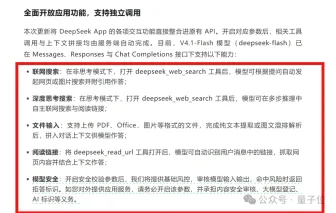
DeepSeek 开放全家桶应用 API,开发者可通过参数调用深度思考搜索、文件输入等对话功能,语音及相关底层能力也开放独立接口,支持单独或组合调用,实现 1:1 复刻 DeepSeek App。V4.1-Flash 模型(deepseek-flash)支持联网搜索、深度思考搜索、文件输入、阅读链接等能力,并收取相关工具调用费用。
Gentle Monster 和 Warby Parker 将于 12 月 10 日推出首款 Android XR 智能眼镜,均搭载高通 Snapdragon AR1 Gen 1 芯片、配备 1,200 万像素摄像头,接入谷歌 Gemini 实现实时翻译、逐向导航等功能,Gentle Monster 起售价 449 美元,Warby Parker 起售价 395 美元。
inclusionAI 发布 Duo 1.2 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含改进的生成质量,模型权重可在 Hugging Face 下载。
inclusionAI 发布 Duo-1.0-distill,一个用于实时音视频交互的全双工多模态世界模型,包含四步蒸馏的 Realization 权重,需与 causal-base 套件叠加使用。
腾讯混元发布了实时语音模型Hy Realtime,在语音理解、指令遵循、拟人化表达等基础对话能力上表现优异,同时新增了Agentic工具调用与唱歌功能。Hy Realtime已上线于元宝语音通话、腾讯客服等产品,近期也将上线腾讯云,对外提供API服务。
腾讯混元发布全新实时语音模型 Hy Realtime,新增 Agentic 工具调用与唱歌能力。Hy Realtime 已在元宝语音通话、腾讯客服等产品上线,近期将上线腾讯云并对外提供 API 服务。
Liquid AI 发布了 LiquidCodec 音频编解码器,支持 24 kHz 音频,将语音转换为语言模型可预测的 token,再转换回音频,参数量约 74M。
各家口径不同:Liquid AI博客提到1.1 kbps的压缩率和3.5倍及8倍的速度提升,而MarkTechPost没有提到这些数据。
Meta的Muse AI代理现在可为用户拨打美国企业电话,但仅限付费订阅用户使用。该功能旨在将消费级AI变为主流产品,目前Muse拥有超过1000万用户,订阅计划起价每月20美元(500亿Muse token/周),最高100美元/月(300亿token/周)。此前该功能仅限部分早期采用者试用,现已向所有付费用户开放。
ElevenLabs 发布 Scribe v3 和 Scribe v3 Live 语音转文本模型,针对嘈杂环境,Scribe v3 适用于预录音频,Scribe v3 Live 适用于低延迟实时应用。
谷歌面向全球 iOS 端 Gemini 用户逐步推送 CarPlay 接入功能,覆盖 Gemini Live 已支持的全部语言。iPhone 18 Pro 等用户可通过 CarPlay 车机屏幕使用 Gemini 语音模式进行免提对话,聊天记录同步至 iPhone 应用。用户可连接 Gmail、Google 日历等应用获取每日简报,或询问目的地信息、练习演讲等,对话自动同步至手机端。
亚马逊 SageMaker AI 双向流推出按使用量计费模式,使模型提供商能通过 AWS Marketplace 报告实时流式推理的实际使用量。Deepgram 成为首发合作伙伴,为 AWS Marketplace 带来语音转文本和文本转语音的按使用量计费。
DeepL 推出语音 AI 翻译模型 Aure,实时复现说话者语气情绪。Aure 基于 DeepL 声音保留技术,能动态适配翻译语音,全程捕捉语气起伏、情绪流转、重音及语速变化,支持英语、德语等八种语言。
DeepL Aure模型通过分析原文音频和翻译文本,将说话者的语气、情绪和语速传递至目标语言,支持英语、德语、西班牙语等八种语言,适用于DeepL Voice在线会议、面对面交谈及DeepL API。
OpenAI 将于 12 月 11 日停用 ChatGPT 的 Advanced Voice Mode 和 Standard Voice Mode,全面转向 GPT-Live。自 7 月发布以来,GPT-Live 使用量已接近翻倍,但部分用户不满其打断对话、丢失上下文的问题。旧版模式将在 11 月 10 日开始收到停用通知,12 月 11 日正式移除,此前用户将自动切换至 GPT-Live。
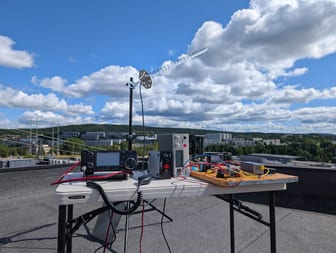
挪威奥斯陆业余无线电小组通过地面无线电发送语音指令,成功让 OPS-SAT PRETTY 卫星启动《毁灭战士》游戏,创全球首次通过无线电链路让卫星自主识别并执行口头指令的纪录。团队利用可更新的软件和软件无线电设备为卫星增加语音控制能力,使用约 27MB AI 语音识别模型将声音转为文字并检测指令,实验重点在于让卫星自主分析无线电信号并采取行动。
Fish Audio 发布全双工语音模型 Live 3,可同时听说并学习实时对话时机,短反应最快 186 毫秒;部署于 Fish Agent 平台、API 或企业本地,英语支持,价格 0.035 美元/分钟(至 2026 年 12 月 31 日)。
OpenAI 在 AI 工程师代码峰会上介绍了 Codex 的新工作方式,包括云功能改进、语音交互和智能体协作。Codex Cloud 2.0 允许用户在隔离实例中运行多个任务,但仍存在云功能易用性问题。语音模式作为控制平面可管理代码库,个人智能体 dots 可作为安全网、委托节点和无处不在的存在。
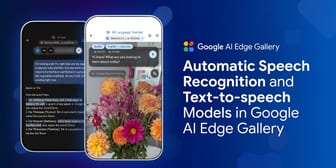
Google AI Edge Gallery 今日推出设备端自动语音识别(ASR)与文本转语音(TTS)功能,可在手机和可穿戴设备上完全离线运行多语言 ASR 和自然 TTS 模型。
Sierra 设计师使用 AI 在两周内完成 Mossy 项目,该项目旨在设计一个可见的语音助手。
开源多模态模型 Claude Code v2.1.159 发布,支持多语言和代码生成。
Zyphra 发布了 ZONOS3-Mini,一款 800M 总参数、100M 活跃参数的开源语音合成模型,支持实时本地部署和零样本语音克隆。该模型在 Zyphra 自研 ZTTS2-Eval 基准测试中排名开放模型第一(66.2 分),单 H100 GPU 上生成首个音频耗时 80 毫秒,但参考音频克隆效果远低于嵌入模式。
Spotify AI DJ 支持用户选择不同声音和个性,新增静音选项减少歌曲间评论。自2023年推出以来,该功能已服务超9400万Spotify高级用户,新功能将于11月10日上线95个市场。
Otter AI 推出支持 30 多种语言的跨语言会议记录功能,可在同一场会议中自动检测并转录切换语言的内容,新增支持 27 种语言,总支持语言数达 31 种。目前已有 13 种新语言可用,其余 14 种即将推出,旨在帮助全球团队克服语言障碍。
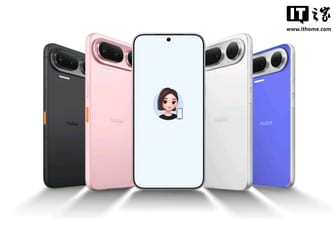
努比亚 NaviX Ultra 星空典藏版售价 6999 元开启预售,提供 16GB+512GB 版本,该手机号称“全球首款 AI 智能体手机”,搭载第五代骁龙 8 至尊版平台和 Seed 全双工语音大模型。
Confucius4-R2T2 是一个用于实时应用的稳定前缀流式语音识别模型,通过后训练将全上下文 ASR 模型转换为流式模型,无需架构修改。基于 Qwen3-ASR-1.7B 构建,R2T2 实现了近离线识别精度和低发射延迟,支持可配置的流式块大小,并展现出有前景的跨语言泛化能力。该模型和实现已公开发布。
Claude Fable 5.2 从一段提示词设计了语音助手中心,包括电路板布局、CAD 外壳建模和固件编写,Diode Computers 根据其设计文件制造了原型板。这是该项目中 Claude 设计的三款设备之一,Anthropic 与 Diode 存商业关系。
苹果iOS 27.3代码显示其开发一套个人记忆系统,包含“记忆图谱”组件,用于整理用户人际关系、常去地点、日常习惯等信息。系统设计“记忆原子”数据单元记录事实、观点等,并关联具体信息,通过两种机制收集数据,目前代码中仅出现一种由AI驱动的机制。该系统采用苹果版本的Kuzu图数据库,但尚未完成且未透露上线时间。
三星准备对 Bixby 进行大幅升级,让语音助手进一步变成能够代用户处理订酒店、预约等日常事务的个人 AI 智能体。用户只需向 Bixby 提出定期执行某项任务的要求,Bixby 便会理解指令并设置相应操作,等待用户确认。该功能有望在明年初随 Galaxy S27 系列推出,但现有 Galaxy 手机能否通过更新获得尚不确定。
微软提交专利申请,利用AI近乎实时修改直播内容并同步嘴型,可替换口头填充词、口吃、冒犯性词汇等,支持实时翻译,延迟1至10秒,潜在应用场景包括讲座、体育赛事直播等,目前仅专利申请,技术尚未获授权。
Cursor 今日推出“与智能体实时语音聊天”功能,支持开发者通过语音与编码智能体双向对话,用于描述代码修改需求、询问任务进展等,同时智能体后台完成编码工作。该功能在 Cursor 的 Agents Window、IDE、网页端及 iOS 应用中使用,由 Grok Voice 驱动语音识别与合成,提供 Ara、Eve 等多种语音选择,并支持通话中切换。
Cursor推出Voice Chat,用户可与智能体进行实时语音通话,口述改动需求、询问智能体正在做什么,并听取进展更新。
推荐理由: 官方说明了语音通话在哪些端可用、如何与编码智能体分工,读者可据此判断它适合哪些协作场景。
亚马逊为购物助手 Alexa 添加新功能,用户可通过短信描述或照片让 AI 搜索亚马逊商品并代为下单。该功能基于 5 月推出的 Alexa for Shopping,在更方便使用短信的场合提供购物服务,支持订购杂货、获取礼品建议、查找相似产品等。目前该功能已向美国部分用户推出,未来几周将扩展至数百万用户。
Underdog 发布仅 32MB 的语音模型 Woof,可在边缘设备运行,无需互联网连接;该模型含 3100 万参数,已开源。此前其发布的 Bark 为 167MB 语音转写模型,两者均旨在让用户掌控数据。
Hugging Face Open ASR 排行榜新增埃及英语和尼日利亚英语的 Liva AI 私有数据集,包含 1.34 小时和 1.55 小时的对话语音,用于提升 ASR 评估的代表性及可信度。排行榜现支持基于 Kachru 三圈模型的更细致口音分类,涵盖 US 与非 US、内圈与外圈/扩展圈等分组。
Meta 宣布个人 AI 助手 Muse 上线实时语音对话与虚拟形象功能,率先面向美国用户推送,覆盖移动端、网页端和 Mac 应用。该功能由 Muse Realtime Voice 与 Muse Realtime Avatar 两个模型支持,可流式输出 448×768 分辨率、25 帧每秒的竖屏视频,从用户说完话到收到首个音视频响应的延迟约为 870 毫秒。
推荐理由: 原文给出了实时语音与虚拟形象的延迟、分辨率和交互方式,读者可据此判断这类面对面智能体交互的成熟度。