Google 详解 Pathways:面向大模型的单控制器训练系统
What is Pathways? Single-controller training for large models
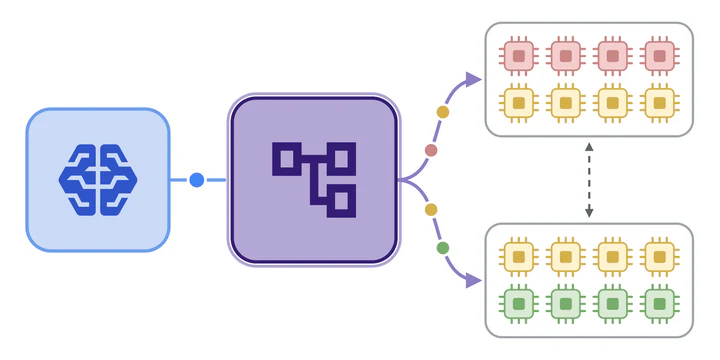
Google 宣布 Pathways 在 Google Cloud Platform 上正式可用(General Availability),这是 Google 用来训练 Gemini 等自家大模型的分布式系统。
Google 工程师解释 Pathways 的单控制器执行模型,并给出它与 Ray 的分层差异,便于判断大规模训练编排的选型。
同一件事另外 1 家也报道了
- Google Developers Blog··首发·当前阅读
Google 详解 Pathways:面向大模型的单控制器训练系统
- 36氪 · AI··+23 小时 19 分
按发布时间排列 · 事件后续出现时自动追加
2026年11月9日
余力 软件工程师
抱歉,您的浏览器不支持此视频的播放
要点
今天,我们宣布 Pathways on Google Cloud Platform的正式可用。在本文中,您将了解Pathways,这是Google构建的分布式系统,用于训练其自身的大型模型,包括Gemini。我们将讨论Pathways如何通过引入一个客户端来描述整个计算为图,从而解决协调挑战,以及分布式运行时如何放置它,移动张量,并使加速器保持忙碌。
大多数大型模型训练都作为单程序多数据(SPMD)程序运行。每个加速器都以同步方式运行相同的程序,并通过collectives(如AllReduce)进行协调。
当您的任务是每个设备上运行的相同程序时,它工作得很好。当任务不再统一时,它会遇到困难,例如一个其阶段相互等待的管道,或一个RL循环,其中采样器、奖励模型和训练器是必须重叠的不同程序。
大型运行还必须承受硬件故障,这多次中断了Gemini 2.5的训练。在SPMD中,一台丢失的机器停止每个进程并将运行恢复到最后一个检查点。在每种情况下,挑战都是协调。您必须决定在何处以及按何种顺序运行,张量如何在设备之间移动,以及当一台机器掉线时任务如何继续。
在“Pathways on Google Cloud”系列的本文中,您将了解Pathways,这是Google构建的分布式系统,用于训练其自身的大型模型,包括Gemini。本文将讨论Pathways如何通过引入一个客户端来描述整个计算为图,从而解决协调挑战,以及分布式运行时如何放置它,移动张量,并使加速器保持忙碌。
到文章结束时,您将了解SPMD何时不是最优的,单个控制器执行有何变化,以及Pathways如何在整个集群中协调整个训练任务。
当扩展变成协调问题时
如果您训练PyTorch模型,您几乎肯定使用分布式数据并行(DDP)或完全分片数据并行(FSDP)。DDP在每个加速器上运行您的脚本的副本,并使用AllReduce等集体操作来平均梯度。FSDP将参数、梯度和优化器状态分片到工作器中,以便模型适合所有内容。
抱歉,您的浏览器不支持此视频的播放
图1:使用DDP和使用FSDP的一个训练步骤。
DDP和FSDP都遵循单程序多数据(SPMD)执行模型。每个进程运行您的脚本相同的副本,在整个运行期间拥有其加速器,并与其他人同步移动,因为它们唯一的协调方式是通过AllReduce等collectives。在一个紧密连接的加速器组内,collectives在快速互连上运行且成本较低。将任务扩展到多个组,相同的collectives跨越数据中心网络,这要慢得多。例如,在TPU v5p上,每个芯片在其组内获得1,200 GB/s的双向芯片到芯片带宽,但只有50 Gb/s(吉比特,约6 GB/s)到数据中心网络,这大约是两个数量级的差距。
因为每一步都依赖于它的集体,所以通信直接在步骤时间内到达。你跨越的组越多,每个步骤花费在移动数据上的份额就越大,因此吞吐量的增长速度慢于你添加的加速器数量。
只要你的训练作业是一个填充了你给它的硬件的程序,这种执行模型就非常适合。你像只有一个设备一样编写你的模型,集体来做剩下的工作。但是将模型放入内存只是问题的一部分。让每个加速器保持忙碌是更难的部分,而这正是 SPMD 模型开始显示其局限性的地方。
以 流水线并行 为例。你将模型分成块跨设备,每个设备现在在不同的代码上运行较小的微批处理。激活值向前流动,激活梯度向后流动,而设备 0 正在处理第一个微批处理时,设备 1 和 2 在等待。除了你仍然在付费的空闲加速器之外,这降低了利用率,即使每个设备在稳定状态下都有工作。
抱歉,您的浏览器不支持此视频的播放
图 2:三个设备,四个微批处理。阴影部分是流水线气泡。
另一个例子是 LLM 的 RL 训练后。你有一个生成展开的采样器,一个对它们进行评分的奖励模型,以及一个更新策略并将新权重发送回采样器的训练器。这三个是应该重叠的不同程序;否则,采样器在训练器运行时空闲,训练器在采样器生成时空闲。
抱歉,您的浏览器不支持此视频的播放
图 3:相同的 RL 循环,依次运行和重叠(玩具调度)。
在这两种情况下,作业现在是在不同设备上运行的几个不同的程序,它们的依赖性不能再通过单个集体来管理。你现在必须协调哪些设备共享哪些张量,哪些进程在其他人仍然完成时运行,以及如何提前排队下一个缓冲区,以便加速器永远不会等待输入。由于每个工作员只能看到其本地设备和数据,因此没有单个进程可以自己管理所有这些依赖性。这有几个后果。
首先,因为每个进程在整运行程中拥有其加速器,并且每个集体都阻塞直到所有设备完成,一台失败的机器会阻止集体完成并停止整个作业,迫使从最后一个检查点重新启动。你无法在运行中途添加设备,也无法将设备归还。
其次,因为每个进程从开始到结束都持有其加速器,容量不能移动到需要的地方。在一个作业中,一个需要比另一个更少芯片的阶段仍然保留多余的。它们处于空闲状态,你仍然在付费,并且作业的其他部分直到运行结束都无法使用它们。在团队中,在集群规模上也是如此。每个作业在运行期间都拥有其加速器,因此共享集群意味着将其分成按作业分配,并且每个新作业都在其自己的主机上启动自己的进程。
最后,开发过程本身变得更加困难。在一台主机上,你可以快速迭代,因为你可以运行脚本,进入 Python shell,设置断点,并进行调试。一旦工作跨越多台主机,这就不再成立。你需要一个启动器来将你的脚本推送到每一台主机,你会遇到在单台机器上从未出现过的协调错误,而且没有单个进程可以进入。当某个东西挂起时,每个工作进程都卡在集体等待其他人的地方,没有一个地方显示整个作业。
所以这里的共同挑战本身就是协调。一旦作业不再是同步的单个程序,你就必须决定在什么地方运行什么,以什么顺序运行,以及张量如何从一个设备传输到下一个设备。
有一种方法可以用图来描述这一点,其中每个块是一个节点,每个在块之间移动的张量是一条边,而设备是节点放置的地方。你可以通过 SPMD 手动连接这个图,一次一个进程。但如果一个客户端声明了这个图,包括每个块做什么,它需要什么,以及它在哪里运行,而分布式运行时处理沿其边的传输、依赖和顺序呢?
抱歉,您的浏览器不支持此视频的播放
图 3:相同的 RL 循环,依次运行和重叠(玩具时间表)。
这就是 Pathways 的想法,这是 Google 构建的分布式系统,用于训练其自己的最大模型,包括 Gemini。Pathways 在 JAX 程序上运行 TPUs,并且它在 Google Cloud 上可用。
使用 Pathways 协调整个计算
使用 Pathways,你从单个 Python 客户端定义端到端的计算,而无需编写自定义协调代码,并且分布式运行时执行它。该客户端与硬件解耦。它运行在普通的 CPU 机器上,你针对虚拟设备编写程序;资源管理器将它们映射到真实的芯片上,并且每个加速器主机上的工作进程运行它收到的编译程序。
抱歉,您的浏览器不支持此视频的播放
图 5:虚拟设备、资源管理器以及主机故障后的重映射。
由于你的代码引用的是虚拟设备而不是物理设备,因此运行时具有灵活性,允许用户更改用于特定计算的设备。这让你在运行时控制,同时运行时处理映射到硬件。例如,在 RL 循环中,训练者和采样器很少想要相同数量的芯片,因此你可以通过请求更多虚拟设备来给采样阶段提供更多芯片。
此外,当主机故障或硬件尚未准备就绪时,这种能力也有帮助。如果一台主机死掉,资源管理器会将工作重新映射到健康的芯片上,并且运行继续而不是重新启动整个作业,这是 弹性训练 的基础。并且因为程序针对虚拟设备,所以在物理芯片配置之前就可以开始编译,所以设置与配置重叠,而不是等待配置。
负责芯片的资源管理器还意味着一个 Pathways 集群可以为多个客户服务,因此一个团队上的研究人员可以共享其容量。使用 共享 Pathways 服务,集群作为长时间运行的服务保持运行,这允许您在 GKE 上托管的 TPU 上交互式开发。每个客户从笔记本电脑或 VM 上按需连接,从共享池中获取自己的切片(紧密连接的 TPU 芯片组),并在断开连接时将其交还。当每块芯片都忙时,下一个工作负载等待容量空闲。
取图 2 中的三块模型。块 A 在一组设备上运行,块 B 在第二组上运行,块 C 在第三组上运行。您声明每个块计算的内容、其目标设备和其输出去向。Pathways 将这些依赖关系表示为分布式数据流图,其中每个块是一个编译的 SPMD 程序,每条边是一个运行时必须传递的张量。
抱歉,您的浏览器不支持此视频的播放
图 6:分布式数据流图。实线箭头跨越组;虚线边保持本地。
在一个 SPMD 程序中,框架处理保持组内设备同步的集体操作,无论是否使用 Pathways,您的代码都不会改变。区别出现在作业在多个组上运行多个程序(多个程序、多个数据、MPMD)时,比如这三个块或 RL 循环中的采样器、奖励模型和训练器。然后没有单个进程能看到两边(之前同样的限制,即每个工作只知道自己的设备),因此将张量从块 A 传送到块 B 是您必须自己协调的手递手操作。
Pathways 填补了这一差距。您只需声明一次依赖关系,运行时就会为您移动和重新分片张量,通过组内的快速互连和在组之间的数据中心网络。
为了使加速器保持忙碌,Pathways 使用 futures 和并行异步调度提前准备启动。当块 A 仍在计算时,块 B 还不能运行,但它的输入形状和 dtypes 已经知道,因此运行时分配 B 的缓冲区并在 A 的输出甚至存在之前就安排传输。每个块的主机端设置在开始时完成,并且每个块在其输入到达时启动。
抱歉,您的浏览器不支持此视频的播放
图 7:顺序设置与异步调度(示意持续时间)。
这也是防止单个客户成为瓶颈的原因。由于调度是异步的,协调工作与芯片上正在运行的计算重叠,因此客户保持在关键路径之外,而不是在步骤之间停滞加速器。
在 Pathways 中,当一组有多个操作准备就绪时,运行时决定执行顺序。在流水线训练中,B 的设备通常同时持有即将到来的微批次的正向传递和更早一个的逆向传递。如果每个设备都自行选择,它们的集体操作会冲突,并且组会停滞。
Pathways 有一个中央调度器,将每个程序的运算放入一个一致的顺序中,因此必须通信的运算可以一起开始,而不是死锁。
抱歉,您的浏览器不支持此视频的播放
图 8:没有共享顺序时组会停滞;有一个调度器时它保持运行。
因为仍然是一个客户端,之前提到的开发循环又回来了。无论你驱动一个主机还是数千个主机,都是同一个 Python 进程,所以你可以 进入一个 shell,设置断点,并在运行时检查。当某个东西停滞不前时,有一个地方知道每个设备上排队了什么以及哪个依赖项尚未满足,而不是在单独的进程中散布的挂起。
总的来说,Pathways 将模型构建与执行分离。您使用客户端选择模型如何在硬件上分区。并且运行时处理保持加速器忙碌的传输、排序和调度,跨越整个集群,而不仅仅是您的切片。
以这种方式描述,Pathways 开始听起来像您已经知道的协调器。如果调度工作、移动张量并保持整个集群忙碌让您想到 Ray,那么它应该这样。但它们在不同的层工作。
这不是 Ray 做的吗?
Ray 是一个用于在大型集群中协调原生 Python AI 工作负载的开源框架。它提供集群,将您的 Python 代码作为 任务和演员 调度,并在主机上启动您的工作负载,将数据加载、训练、服务和调整统一在一个控制平面下。对 Ray 来说,加速器是一个要调度的资源。
Ray 不改变的是您的训练如何在芯片上运行。每个工作器内的作业 仍然作为 SPMD 运行。框架插入集体操作,并且每个进程只看到自己的设备。Ray 放置并启动该作业,但它不会将其转换为驱动整个集群的单个程序。
这就是 Pathways 工作的层。它更改了底层的执行模型,因此一个客户端协调每个芯片。因为它们位于不同的层,所以两者是互补的。原则上,Ray 可以协调集群和管道,而 Pathways 处理训练步骤的执行方式。
所以具体来说,Ray 的工作是关于协调,而 Pathways 的工作是关于执行。使用 Ray,您将您的数据、训练、服务和调整捆绑在一起,并将异构工作分布在加速器和云上。使用 Pathways,您在许多芯片组上运行一个模型,表达超出 SPMD 的模式,并在主机失败时恢复,而不是重新启动整个作业。
结论和下一步
当训练作业不再是一个统一的程序时,挑战变成了协调阶段之间的依赖关系、跨越网络的张量以及保持每个加速器获得供应的顺序。
SPMD 要求您解决这些依赖关系。使用 Pathways,您从单个客户端一次描述计算,将其作为块及其之间的张量的图。并且您有一个运行时,它将块放置在虚拟设备上,移动和重新分片张量,跨集群排序工作,并在主机失败时重新映射。
使用 Pathways,模型构建和执行是分离的,您考虑整个集群,而不是其中的一部分。
如果您想了解更多关于 Pathways 的信息,您可以查看以下资源:
- Google Cloud 上的 Pathways - 文档
- Pathways:用于机器学习的异步分布式数据流 - 论文
- 使用 Pathways 进行弹性训练 - 文档
- Pathways 工具 - GitHub 仓库
- MaxText - GitHub 仓库
祝您构建愉快!
上一个
下一个
来源: Google Developers Blog · developers.googleblog.com