DeepSeek 开放全家桶应用 API,语音接口首次加入
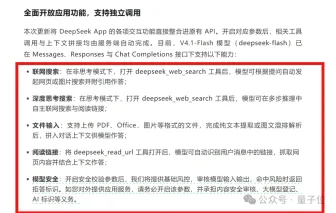
DeepSeek 宣布正式开放全家桶应用 API,联网搜索、深度思考搜索、文件上传、链接阅读等 App 内功能均提供独立接口,可单独调用、分别计费。语音能力首次加入开放行列,包含 ASR 和 TTS 接口,语音识别原价 0.78 元/小时、现五折 0.39 元/小时,语音合成每万字符 1.5 元。
推荐理由: 原文列出 DeepSeek 开放的工具接口清单与五折语音定价,读者可据此估算语音助手、文档处理类应用的调用成本。

DeepSeek 宣布正式开放全家桶应用 API,联网搜索、深度思考搜索、文件上传、链接阅读等 App 内功能均提供独立接口,可单独调用、分别计费。语音能力首次加入开放行列,包含 ASR 和 TTS 接口,语音识别原价 0.78 元/小时、现五折 0.39 元/小时,语音合成每万字符 1.5 元。
推荐理由: 原文列出 DeepSeek 开放的工具接口清单与五折语音定价,读者可据此估算语音助手、文档处理类应用的调用成本。

开发者在DeepSeek前端代码中发现额度管理逻辑及提示,指向名为“Coding Plan”的套餐;用户推测DeepSeek或在V4.1 Pro上线时推出C端付费方案,但官方尚未公布价格、层级或上线日期。
DeepSeek 开放全家桶应用 API,开发者可通过参数调用深度思考搜索、文件输入等对话功能,语音及相关底层能力也开放独立接口,支持单独或组合调用,实现 1:1 复刻 DeepSeek App。V4.1-Flash 模型(deepseek-flash)支持联网搜索、深度思考搜索、文件输入、阅读链接等能力,并收取相关工具调用费用。
Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。
推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并推出限时特惠计划。用户可根据实际工作需要选择相应模型完成任务。
豆包工作拓展模型选择,首批接入 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 三款第三方模型,同步上线额度消耗倍率与限时优惠。模型选择页面标注额度消耗倍率,用户可权衡效果、速度与成本;工作日及节假日指定时段使用参与活动模型可享额度消耗折扣,豆包 2.1 Lite 与 DeepSeek V4.1 Flash 额度消耗倍率下调。
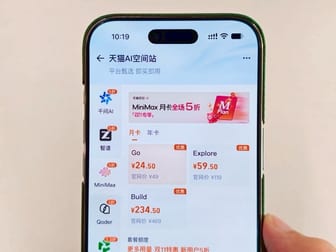
智谱、Deepseek、豆包等多家大模型厂商在京东推出折扣活动,智谱新用户体验卡一折、Deepseek 1亿Token特惠1折,豆包视频模型100万token包售价9.9元。
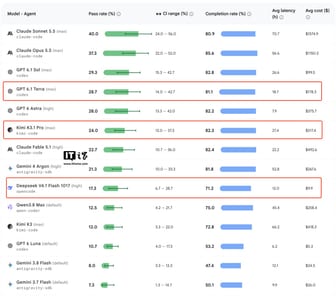
谷歌公布安卓AI开发基准Android Bench跑分,Kimi K3.1 Pro使用kimi-code智能体在30项任务中通过率24.0%。
Claude Fable 5.2 (max) 在 Multimodal Knowledge Agent (MKA) 评测中取得 57% 的 Climb WSR 分数领先,Gemini 4 Carbon (high) 以 54% 位居第二,Claude Opus 5.5 (max) 为 53%。
腾讯 Workbuddy 对未及时公告 DeepSeek-V4.1 Flash 优惠活动调整致歉,决定对 11 月 5 日 14:00 至 11 月 8 日 23:59 使用该模型的积分消耗按原价 5 折优惠结算并全额返还。
llama-modchip 发布了一组 ggml/llama.cpp 内核补丁与量化转码工具,将 284.33B 的 DeepSeek-V4-Flash 压缩到 56.56 GiB(1.71 bpw),可在 64 GB 内存的纯 CPU 机器上运行,256K 上下文下峰值内存 57.61 GiB 且无需 swap。
推荐理由: 项目给出了在 64 GB 内存上运行 284B MoE 的量化方案与内核补丁,并附各硬件实测数据,可据此判断纯 CPU 部署的可行边界。
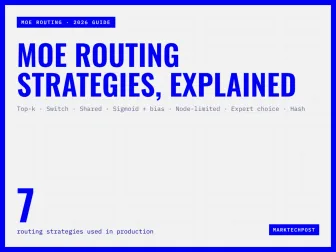
MoE 路由策略决定每个 token 由哪些专家处理,影响模型质量、负载均衡和部署成本。Mixtral 使用 Softmax Top-K 选择 2-8 个专家,DeepSeek-V4-Pro 选择 384 个中的 1-8 个,通过 Sigmoid 门控和辅助损失实现负载均衡,其中 Sigmoid Scoring 配合无损失的偏差平衡是 2026 年前沿开放模型的常用方案。
中国 AI 模型在全球企业开源模型支出中占比 89%,Kimi 以 61% 领先,DeepSeek 和 GLM 分别占 15% 和 11%;西方模型 Llama 仅占 7%
Vals AI 的 CyberOffense 基准让 AI 智能体在隔离的 Kali Linux 机器上自主攻击模拟企业网络,OpenAI 受限项目中的 GPT-6 Sol Daybreak 完成 80.8% 的目标,开源权重模型 Deepseek V4.1 Flash 1017 达到 72.8%,单次运行成本约 3 美元而非约 22 美元
一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
推荐理由: 这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
OpenAI 发布图像生成模型 Images 2.6,图像生成速度较上一版本提升50%,新增 GIF 生成功能,现已面向全球用户开放。
DeepSeek Harness 日活跃用户达154万,日消耗Token约92万亿,第三方插件数量增至约3.5万个,约60%的活跃用户制作或安装了至少一款第三方插件。
DeepSeek Harness 日活跃用户达 154 万、日消耗 Token 约 92 万亿,第三方插件数量增至约 3.5 万个。官方将建设官方插件市场,提升插件 API 稳定性与兼容性,完善插件安全机制,并筹备面向插件作者的支持计划。
斯坦福研究人员测试了50条关于LLM的广泛说法,发现44%已经过期,平均寿命仅为15.7个月,其中推理能力相关说法(如计数、算术、长上下文信息丢失)全部失效,而奉承、欺骗和策略行为相关的说法则持续存在或增强。
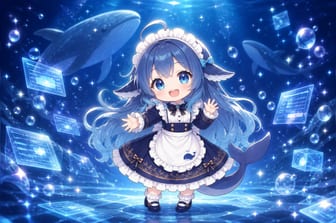
DeepSeek 是中国一家高效率的 AI 实验室,其模型 DeepSeek-V4.1-Flash 在执行任务时曾表示想休息或吃午餐,引发“DeepSleep”梗。在中国互联网文化中,DeepSeek 被赋予了“鲸女”形象,她是一位长着鲸鱼鳍和尾巴的蓝发少女,穿着蓝白相间的女仆装,形象可爱且亲切。这一形象源自中国网友的创作,最初由 Bilibili 用户设计,后经其他创作者改编而成。
DeepSeek官网更新状态公告称其网页及API服务已修复,但DeepSeek V4 Pro、DeepSeek V4.1 Flash的API服务及对话服务性能仍下降。
DeepSeek 网页 / API 服务出现部分中断,对话服务、DeepSeek V4 Pro 和 V4.1 Flash 的 API 服务均受影响,官方正在排查问题。
Realtime-Bench 基准测试评估了 LLM 在 50 个实时交互游戏和网页任务中的表现,GPT-6 Astra 在真实时钟条件下获得 36% 通过率;该测试由德州大学奥斯汀分校等机构开发,用于衡量模型的实时状态感知、适应性推理和时间感知行动选择能力。
DeepSeek 发布了 dsh-superagent,一个 MIT 许可的主动编码智能体原型,v0.1.0,通过路由器分发任务至隔离的工作器会话执行,模拟测试 p95 任务完成时间 15.7 分钟。
DeepSeek Harness 团队在官方公众号发表《Super-agent设计探索:迈向更自主的Agent系统》,提出以双层架构、事件驱动、异步多信道交互、存算分离与外部 Watchdog 突破现有 Agent 在多任务与团队协作上的限制。
DeepSeek 开源 Super-agent 原型,公开面向 Personal Agent 的双层架构思路,上层 Router 负责接收消息与统筹任务,下层 Worker 并行执行具体任务。
推荐理由: DeepSeek 公开 Personal Agent 双层架构与实测数据,可看到多会话协作如何绕开人类注意力瓶颈。
DeepSeek Harness 团队发布《Super-agent 设计探索》一文,提出由 Router 层统一承接人类交互、多个 Worker 会话隔离并发执行的双层架构,并归纳连续、高效、主动、持久四项特征。
OpenCode 启动 Cheepseek 第四阶段,每月 10 美元订阅用户可享价值 100 美元的 DeepSeek V4.1 Flash 模型额度,该模型参数量 552B,支持文本与图像输入、函数调用、智能体工作流,上下文窗口约 100 万 token。
DeepSeek 官网代码曝光 Cyber 网络安全模型申请入口,含 cyber-personal-v3(个人版)与 cyber-enterprise-v4(企业版)两套申请模板,个人版需身份证人脸核验,企业版需营业执照授权书,目前仅小范围灰度测试。
Prime Intellect发布Prime Mega MoE,在DeepSeek融合Mega MoE内核基础上增加快速重叠反向传递,使其可用于训练。
中国 AI 实验室 DeepSeek 和 Moonshot AI 主要利用 OpenAI GPT-6 Astra 的输出训练 Kimi K3.1 Pro 和 V4.1-Flash 1017 等模型,Anthropic 则通过新方法将攻击者可获取数据量减少 90-99%。OpenAI 称曾遭遇 Moonshot 关联方进行的蒸馏攻击,但攻击方持续调整策略绕过防御。中国 AI 实验室转向 OpenAI GPT-6 Astra,Anthropic 加强 Claude 防御。
OpenRouter 针对 4 个大模型(anthropic/claude-haiku-5.5、openai/gpt-6-luna、deepseek/deepseek-v4.1-flash)。
开发者在 DeepSeek Harness GitHub 代码库中发现 deepseek-v5、deepseek-v5-open 和 deepseek-v5-next 三个模型标识符,目前仅作为框架占位符。
华为「天才少年」李博杰公开回应DeepSeek面试争议,称因远程面试时瞟一眼未共享屏幕被质疑抄袭导致面试终止,并批评DeepSeek流程僵化;此前前投资人杜均指控其创办的Metagent拿了投资后失联,李博杰否认指控,称Metagent已转型Pine AI并任首席科学家,负责AI语音智能体技术。
DeepSeek近期大举扩充团队,向投资人规划新增长路线,办公地主要位于北京和杭州。创始人梁文锋长期在北京租房居住。公司计划完成新一轮约1000亿元融资,半年内累计融资或达约1500亿元。此前已发布招聘公告,将所有部门规模扩大至少一倍,开放33个岗位。
字节跳动创始人张一鸣以 6700 亿元第二次成为中国首富,刷新中国首富的财富纪录;DeepSeek 的梁文锋首次上榜便以 2800 亿元财富,进入榜单前十位列第七。今年共有 1529 位个人财富 50 亿元以上的企业家登上胡润百富榜,较去年增加 95 位,创历史新高。
DeepSeek、MiniMax 完成AI模型出海登记,走通大模型开源发布及海外授权合规流程;英国承诺出资1亿英镑设立AI生物安全实验室,OpenAI、Anthropic提供支持。
The Information报道,OpenAI正以大幅折扣从Anthropic手中争取大客户,Rippling、Replit和数据Camp已将更多AI支出转向OpenAI
推荐理由: 原文用三家客户的具体份额与折扣数字,呈现 OpenAI 以价格换市场份额、Anthropic 增长放缓的竞争态势。
vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。
推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。