蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI/Duo-1.0-causal-base 发布:一个用于全双工交互的多模态世界模型
inclusionAI 发布 Duo 1.0 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含实现权重和主干、意图模型和适配器、音视频编解码器、语音识别器和强制对齐器。该模型权重基于 MiniMax H3 初始化,并已开源。
AI 词典
H3 是由 MiniMax 开发的多模态生成模型,能够生成高分辨率视频,并支持对文本、图像、视频和音频的统一上下文理解。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo 1.0 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含实现权重和主干、意图模型和适配器、音视频编解码器、语音识别器和强制对齐器。该模型权重基于 MiniMax H3 初始化,并已开源。
 Comfy Blog
MiniMax H3 图像现已原生支持 ComfyUI,提供 4096×4096 高分辨率输出,支持文本生成图像和参考图像编辑,通过 Partner Nodes 也可直接运行。
 量子位3838
海马云旗下 RunningHub 平台通过自研算力池和垂直模型后训练,将算力利用率提升至行业 70% 以上,推出 RH Upscale 超分模型、H3 Lightning 视频生成模型等,实现低成本、高效率的 AI 内容生产。平台整合 Agent、工具链与专家知识上下文,支持模型动态路由和智能编排,用户无需掌握复杂操作即可完成专业级任务,每月 Token 消耗量达 9 万亿。
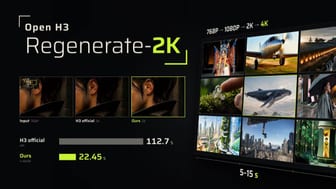
量子位英伟达与麻省理工学院团队开源视频增强方案 Open-H3-Regenerate-2K,基于 MiniMax H3 模型将低分辨率视频重生成 2K(2560×1440)或 4K(3840×2160)视频。
Comfy Blog7070使用 FastVideo 的 FastH3 V2 检查点,通过四步采样、稀疏注意力、小型文本编码器、小型检查点和融合 FP4 MLP 等优化,在单个 RTX 5090 GPU 上生成 15 秒 448×256 分辨率的视频,VRAM 需求从 80GB 降至 <30GB;该自定义 Comfy 节点已开源,可通过 Comfy API 请求 GPU 和模型进行部署。
 MiniMax News
MiniMax 发布 H3 模型,支持文本、图像、视频和音频的统一上下文理解,能生成带原生立体声的 2K 分辨率视频(最长 15 秒)。
 MiniMax · Hugging Face 新模型
MiniMax-H3 是一个通用多模态生成系统,支持统一理解文本、图像、视频和音频,能生成最高 2K 分辨率、最长 15 秒的带立体声音频的视频。其 H3-Context-IR 模块用于深度理解输入指令并转化为 H3-Base 可理解的中间表示,但未开源。H3-Base 和 H3-Regenerate-2K 模块分别负责 768p 和 2K 分辨率的音频视频生成,前者开源,后者需 API 调用。