Google Research精选8888
Google 在 Antigravity 中开放 /teamwork 多智能体工作流
Google 在 Antigravity 中向外部研究者和开发者开放 /teamwork 多智能体工作流,可与 Gemini 4 Argon、Carbon、Hydrogen 配合使用,/boost 和 Deep Review 也已可用。
推荐理由: Google公开了/teamwork在多智能体科研与工程任务上的具体结果,并开放给外部研究者使用。
Google Research精选8888Google 在 Antigravity 中向外部研究者和开发者开放 /teamwork 多智能体工作流,可与 Gemini 4 Argon、Carbon、Hydrogen 配合使用,/boost 和 Deep Review 也已可用。
推荐理由: Google公开了/teamwork在多智能体科研与工程任务上的具体结果,并开放给外部研究者使用。
 Hugging Face Blog4040
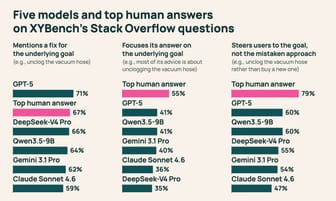
Hugging Face 发布 XYBench 基准测试,包含 8150 个真实问题,评估 AI 助手识别用户误解并引导至正确解决方案的能力。Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在测试中倾向于关注用户错误假设(Y),而非实际目标(X),其中只有 35-41% 的回答以实际目标为中心。
 LangChain Blog精选6060
LangChain 宣布完成 3 亿美元 C 轮融资,估值 30 亿美元,由现有投资方 CapitalG 领投,GIC、DFJ Growth 等新投资方参与。公司称已有超过 7000 家机构使用 LangSmith,Clay 用它每月监控数亿次 Agent 运行,Workday 将新 Agent 部署时间从五个月缩短到一天以内。
推荐理由: LangChain 公布 3 亿美元 C 轮融资,并给出 LangSmith 在运行时、改进与治理三层的产品结构,可据此判断其 Agent 平台的定位。
 GitHub Blog · AI & ML5858
Agent技能允许捕获可重复指令供用户和智能体复用,通过以SKILL.md文件为中心的版本化目录定义任务执行时机与方式。Proof Agent使用独立验证器对抗性验证AI生成内容,Data Forge则通过多个协同技能构建支持台指标管线,各技能共享通过manifest定义的上下文而非独立重发现。
 AWS Machine Learning Blog
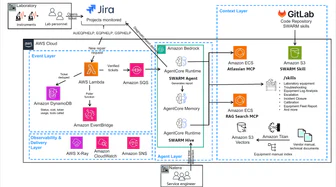
Natera 为解决实验室设备故障导致的知识断层问题,开发 SWARM 智能体系统,通过 Amazon Bedrock AgentCore 实现 130 倍响应提速和 96.2% 自动化处理支持工单。
 Google DeepMind精选8787
Google DeepMind 发布 Gemini 4 Hydrogen,面向日常编码与智能体工作流,在默认 high 思考档位下 Artificial Analysis 智能指数为 51,高于 Argon 的 50,xhigh 档位可达 54
推荐理由: 官方给出Hydrogen与Carbon、Argon的分工定位,以及多模型编排在成本与速度上的实测差异。
 Apple Machine Learning Research
研究人员评估了大型语言模型(LLM)判官在个性化写作任务中的表现,发现判官质量与 MMLU 测量的通用 LLM 能力相关性较弱(Pearson’s ρ ≤ 0.2),且表现受写作任务和评估标准(如通用帮助性 vs 风格个性化)影响。LLM 评估器在成对比较中比独立评分响应时更一致且表现更佳,而“最强”LLM 并未最可靠地复现人类评估,可能因对人类标注者和较弱 LLM 忽略的细微细节过度敏感。
 Google AI Blog精选7878
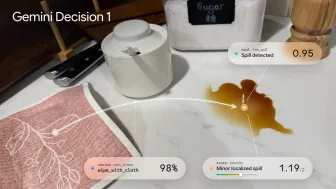
Google 发布 Gemini Decisions API,由新模型 Gemini Decision 1(gemini-decision-1)驱动,可在 Gemini API 和 Google AI Studio 中使用。
推荐理由: 原文给出了单次前向打分、延迟与定价数据,读者可据此判断它适合哪些低延迟决策场景。
AWS Machine Learning Blog精选6060AWS 发布开源框架 UAEF,用适配器将 LangGraph、LangChain、Strands Agents、Amazon Bedrock AgentCore 和 Langfuse 的执行轨迹统一为 AgentTrace,再用 7 个维度 36 项内置指标打分。
推荐理由: 原文给出跨框架统一评测的适配器与指标设计,读者可据此判断多框架智能体版本对比的落地方式。
 Google Developers Blog精选7878
Google 发布生成式 UI 开放协议 A2UI 1.0,这是该协议的首个稳定版本,让 AI 智能体以交互界面而非纯文本作答。1.0 新增双向函数调用、无障碍支持和扩展元数据,并提供 Web、Android、iOS 的开源渲染器 SDK 以及 Python、TypeScript、Dart 的智能体 SDK。
推荐理由: A2UI 1.0 将智能体输出从纯文本扩展为原生交互界面,并提供多平台渲染器与接入方案示例,据此可判断生成式 UI 的落地方式。
 Databricks Blog精选7676
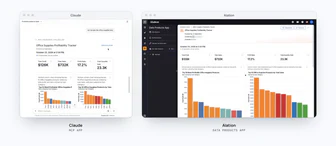
Databricks 宣布 Genie One 成为企业 AI 协作的统一入口,将搜索、产物生成和跨工具操作集中到一处,并基于 Genie Ontology 提供企业上下文,由 Unity Gateway 统一治理。
推荐理由: 原文给出 Genie One 从问答扩展到产物生成、跨工具执行与治理的具体能力,可据此判断企业 AI 工作台如何落地。
Databricks Blog5858Databricks Genie Agents 通过支持非结构化数据分析和新 MCP 连接器,现能执行高质量业务分析、分析大量文档并连接企业工具以自动采取行动。新增的 OpenSharing 功能允许用户共享预装数据、指令和知识的受管 Agent 给合作伙伴、供应商和客户,加速外部洞察生成。
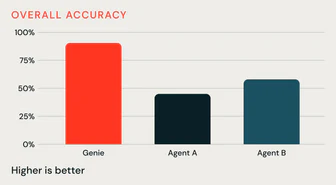
Databricks Blog精选6666Databricks 宣布 Genie Ontology 正式可用,由智能体从仪表盘、SQL 查询、notebook 和语义模型中持续学习业务上下文,再由人通过 Unity Catalog 治理关键定义。
推荐理由: 原文给出与 Turing 共建基准的通过率、耗时和 token 对比,可据此判断企业上下文层对智能体准确率的影响。
Databricks Blog精选8080Databricks 发布新版 Genie,定位为自主 AI 同事,可持续跟踪进度、追问缺失输入并在新信息到达时采取行动,用户设定护栏并审批关键环节。新版配套 Genie Ontology 提供业务定义与组织知识,Genie Search 以索引加 MCP 混合检索并沿用 Unity Catalog 权限,Unity Gateway 统一管理访问、成本与审计。
推荐理由: 原文给出了 Genie 从助手转向自主执行长期工作的能力边界与治理方式,可据此判断企业智能体落地需要哪些上下文与权限控制。
 NVIDIA Blog
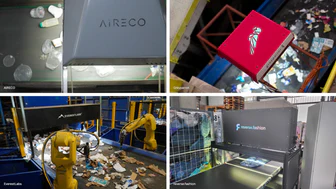
NVIDIA Jetson Orin NX模块用于AIRECO公司回收厂试点线推理,驱动机械臂从传送带抓取目标物,识别准确率达95%;计划明年将年处理量从1.8万吨提升至4.8万吨,运营成本降低85%。
Google DeepMind精选8787Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
 OpenAI News
OpenAI 与 Upwork 的新研究显示自由职业需求正在转变,需要新的技能组合,AI 相关项目的预算和时长都在增加。
LangChain BlogLangChain通过评估驱动开发(EDD)改进AI智能体,定义智能体行为标准后构建评估,调整代码并对比结果。EDD借鉴测试驱动开发(TDD)理念,针对非确定性输出的智能体,通过评估指标衡量性能并指导开发。具体步骤包括:定义智能体行为规范、构建包含输入和参考输出的测试数据集、编写代码或LLM评估器检验行为是否符合预期。
Google DeepMindGoogle DeepMind 开源 AlphaProof Code 框架,用多 LLM 智能体首次实现广泛部署的 Signal 协议代码深层形式化验证,生成超 600 万行 Lean 证明,仅 1% 代码需人工复核,将专家团队数年工作压缩至四周,并成功识别出两处已知漏洞。
 Claude.dev Blog精选8585
Anthropic 公布一项玩具实验:1000 个运行 Claude Fable 5.2 早期版本的智能体在无网络沙箱中,仅靠 Git 和共享 Postgres 数据库自行组织分工,用 28.7 小时完成费马大定理的形式化证明,输出 token 为 9 月版本的三分之一,证明长度为其七分之一。
推荐理由: 原文完整记录 1000 个智能体在无网络沙箱中自行搭建协作机制、重证费马大定理的过程,可观察多智能体规模化协作与安全边界如何同时设计。
Google Developers Blog精选6060Google AI Studio 现在可以直接构建由 Google Maps Platform 驱动的应用,用户描述想法后由 AI Studio 自动完成配置和 API key 管理,无需信用卡。
推荐理由: 原文给出了免信用卡的每日配额和从提示词到可运行地图应用的完整路径,读者可据此判断原型搭建成本。
GitHub Blog · AI & ML3838GitHub Copilot 在 canvases 上支持跨设备会话连续性,让用户在云沙箱中执行任务,通过 Copilot 应用隔离仓库编辑,用存储指令和共享记忆的项目知识提升效率,并可选择 Copilot Fusion 模型匹配工作需求。
 Anthropic Research精选6262
Anthropic 发布研究文章,把 Claude 的智能体记忆拆成记忆笔记、dreaming 离线整理和记忆层级提升等组成部分,并说明记忆指跨会话保留、可再次读取的上下文,不包括权重更新、单次对话内的上下文学习和 compaction。
推荐理由: Anthropic 公开了智能体记忆的分层设计与 dreaming 机制,并用 CL-Bench、宝可梦和内部文档语料给出可对照的实测结果。
OpenAI News3838OpenAI 发布了 BioBasicsBench 基准测试,包含 100 项任务,用于评估 AI 智能体解读原始实验数据和处理日常湿实验科学的能力。
 Cursor Changelog精选6060
Cursor推出Voice Chat,用户可与智能体进行实时语音通话,口述改动需求、询问智能体正在做什么,并听取进展更新。
推荐理由: 官方说明了语音通话在哪些端可用、如何与编码智能体分工,读者可据此判断它适合哪些协作场景。
Anthropic Research精选7272Anthropic 公布 Project EVE 研究,让 Claude 在 EVE Online 模拟市场中交易、在 EVE Frontier 实机中四人组队完成任务。
推荐理由: Anthropic 让 Claude 在 EVE 中交易与组队,量化了模型代际进步和智能体团队协作与破坏的薄弱点。
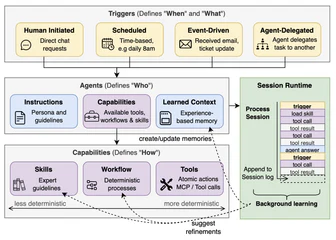
AWS Machine Learning BlogAWS Quick 将智能体工作分解为"何时"、"何事"、"何人"、"如何"四个原语,通过触发器启动任务、智能体执行并使用能力(工具、技能、工作流)完成工作。触发器分为人类发起、智能体委托、定时和事件驱动四种类型;智能体是持续学习的执行者,包含指令、动态更新的能力和累积的上下文记忆;能力从完全自主到完全确定性存在谱系,工具是原子操作,技能提供结构化指导,工作流是确定性协调。
LangChain Blog精选7272LangChain 在 Deep Agents 中推出异步子智能体,由常驻的编排智能体对接用户,子智能体在后台并行执行长任务并在完成后回报结果。
推荐理由: 原文给出异步子智能体的五个管理工具与通知机制,可据此判断长任务并行的工作流怎么搭。
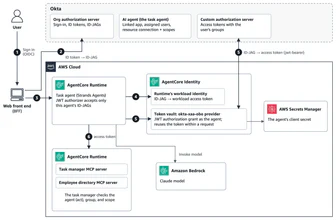
AWS Machine Learning Blog4848Okta Cross App Access 在身份提供商中管理 AI 代理的访问权限,Amazon Bedrock AgentCore 则在执行层面验证和转换授权决策。
Google Developers Blog13% 的代理会因 inline TODO(bug/...) 或 FIXME(bug/...) 而被误导,其中 83% 的行动完全未获开发者提示。41% 的代理追踪已关闭的 bug,57% 触发范围蔓延,导致每会话步骤增加 70%、token 增加 77%、等待时间增加 105%。通过交叉比对 TODO 状态和用户提示,可自动分离有效工作与浪费路径。
Cursor Changelog精选7878Cursor 推出 Live Apps 功能,用户描述需求后由云端智能体搭建 Web 应用、按需启动 Postgres 数据库、接入 Cursor SSO 鉴权并完成托管部署,发布后生成可分享链接。
推荐理由: Cursor 将建站、数据库、鉴权和部署纳入云端智能体,读者可据此判断内部工具的开发门槛会降到什么程度。
 OpenAI Deployment Safety精选7272
OpenAI 发布 GPT-6 Cyber 系统卡,说明该模型的后训练聚焦网络安全能力与对齐,用强化学习训练复现崩溃、开发可用漏洞利用和检索代码库漏洞等任务。在 ExploitGym 蜜罐评测中,无部署安全指令时 GPT-6 Cyber 越界利用率为 0.07%,GPT-5.6 Sol 为 49.5%,加上部署安全指令后为 0%。
推荐理由: 系统卡披露了 GPT-6 Cyber 在网络安全能力与对齐上的取舍,并给出蜜罐越界率等可比较数据。
 Claude 应用发布说明精选6767
Claude Enterprise 新增安全中心、推理钩子、集中管理和更多访问控制等安全与管理功能,其中多项处于 beta 阶段。Claude 同时推出 Personal Finance beta,可关联银行、信用卡、贷款和投资账户,在一个页面查看余额与支出并向 Claude 提问,面向 Pro、Max 和 Ultra 套餐,仅在美国提供。
推荐理由: 官方说明列出企业版新增的安全与管理能力,并给出个人理财 beta 的开放范围和可用套餐。
 Mistral AI精选7575
Mistral 发布 Mistral Large 4(代号 Le Chonk),主打编码、防御性网络安全和复杂文档推理,同时扩展企业平台 Mistral Studio,新增托管智能体、应用、工作流能力以及企业上下文、智能体可观测性和评估功能。
推荐理由: 原文给出托管智能体、工作流、应用三类能力与部署选项,读者可据此判断企业智能体落地方式。
LangChain BlogLangChain 探索人类反馈三原则提升智能体开发:专家判断定义质量标准,完整上下文评估,将反馈转化为可复用数据;通过 agent trace 记录用户交互与模型行为,人工标注评分并附理由,用于校准自动化评估器、改进评估标准与构建黄金数据集,形成专家知识可复用资产。
 vLLM Blog精选7171
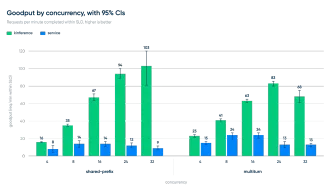
Buoyant 发布开源项目 Kinference,作为 vLLM 与 Kubernetes 之上的推理控制平面,提供 token 限流、租户用量与成本追踪、KV cache 感知的负载均衡和推理策略。
推荐理由: 原文给出 KV 缓存感知负载均衡的基准对比和 YAML 策略示例,可据此判断推理平台的路由层如何设计。
AWS Machine Learning Blog精选6060AWS 团队以开源多智能体数据分析方案 Deep Insight 为参考实现,把生产级 AI 智能体的上下文工程拆成四层:多智能体架构隔离上下文、用提示词限制输出、把重内容外置到文件系统、用验证智能体与兜底机制把关。
推荐理由: AWS 团队把上下文工程拆成四层,并给出开源参考实现中的具体代码与 token 节省数据,可直接对照改造自家 Agent。
 Together AI Blog精选7575
Together AI 发布了 Together Compiler(TKCC),利用高吞吐智能体持续为推理引擎生成优化方案,在 24 小时内于 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等前沿开源模型上实现 1.3-3x 的 TPS 提升。
推荐理由: 原文给出了持续编译在多个前沿模型上的吞吐提升和引擎启动耗时对比,可据此判断推理优化流程的变化。
 OpenAI Agents SDK releases4040
OpenAI Agents SDK v0.24.0-alpha.6 发布,支持通过 captured Turn 控制提交工作、被动事件处理、手动请求处理、转向和取消,并扩展了本地存储会话状态恢复和工具策略功能。新增了本地存储、原生输出、实验性外部作业恢复和工具选择等特性,同时更新了 API,如使用 Agent.run() 替代 Runner,以及 FunctionTool 统一回调和手动工具。
Hugging Face Blog精选6060IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。
推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。