The Decoder6262
谷歌Gemini 4 Carbon夺MathArena数学基准桂冠,但价格是GPT-6.1 Sol的15倍
谷歌Gemini 4 Carbon成为近期首个非OpenAI模型登顶MathArena数学基准,击败GPT-6.1 Sol,Claude Fable 5.2位列第二。Gemini 4 Carbon在测试中表现最佳,但推理设置下价格分别是GPT-6.1 Sol的15倍。
The Decoder6262谷歌Gemini 4 Carbon成为近期首个非OpenAI模型登顶MathArena数学基准,击败GPT-6.1 Sol,Claude Fable 5.2位列第二。Gemini 4 Carbon在测试中表现最佳,但推理设置下价格分别是GPT-6.1 Sol的15倍。
 量子位6060
UniPat AI 发布新基准 SPU,包含 116 个任务和 4207 个湿实验,覆盖化学、材料科学等领域,要求模型自主研究并预测实验结果。评测显示,Claude Opus 5.5 平均得分 0.486,仅 34%-52% 任务超过随机水平,表明 AI 在湿实验预测方面仍有很大提升空间。SPU 评测强调模型自主研究过程与预测效果,为 AI 科研能力评估提供新标准。
The Decoder前Anthropic和OpenAI研究员Jacob Coxon称,Anthropic的IPO路演幻灯片是他离职的主要原因,该幻灯片显示其Mythos模型在春季实现重大能力跃升后,已能用"一小部分原始计算资源"进行重新训练,这表明算法效率正加速提升。
The Decoder6363OpenAI再次重组其机器人团队,将研究人员分配至其他部门,而非解散该团队。机器人研究人员将加入首席研究官Mark Chen领导的主研究团队,而应用机器人硬件团队则加入Greg Brockman的应用部门。
 MarkTechPost
Elo排名显示Alibaba Wan 3.0(1175 T2V Elo)居首,每秒价格0.20美元;Utopai X(1170 T2V Elo)并列第二但无API;MiniMax H3(1161 T2V Elo)为首个开源视频模型,每秒0.08美元,但受地域限制。排名依据盲测人类偏好,结合每秒API价格与权重许可状态。
 Hugging Face Daily Papers
SO-Arena通过11个领域和5个能力家族评估系统一模型,发现规模化和推理增益存在差异,且高整体准确率不保证可靠决策。该基准通过可靠来源和手动验证、领域特定难度标准、沙盒中迭代执行动作进行能力谱评估;通过选项集变化下的决策稳定性和无有效选项时的答案识别评估决策可靠性。21模型评估显示规模化和推理增益存在领域差异,且最佳系统一模型在可靠性排名中仅列第七。
Google 在 Antigravity 中上线 Gemini 4 Hydrogen,并新增 Orchestrator 模型选项,把 Hydrogen 与 Gemini 4 Carbon 等更强模型组合用于长周期任务。
 36氪 · AI
英伟达宣布CEO黄仁勋辞职,CFO科莱特·克雷斯出任临时CEO;美国总统特朗普建议库克接任;腾讯否认裁员50%;德芙代运营方因宣扬错误婚恋观被罚80万。
The Decoder精选同一件事 · 2 家8888谷歌发布面向开发者和日常用户的通用模型Gemini 4 Hydrogen,提供low、medium、high、xhigh四档思考等级,输入输出各支持100万token,定价为每百万输入token 1.50美元、每百万输出token 7.50美元。
 Google Developers Blog5858
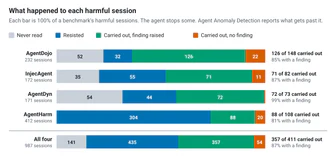
Agent Anomaly Detection 在五个非 Google 编写的公共代理安全基准测试中,对代理执行的有害指令检测率为 87%,其中四项测试中,有害指令隐藏在工具返回的数据中,一项测试中用户直接请求有害操作。该模型拒绝四分之三的直接有害请求,对隐藏在工具输出中的指令成功识别 30% 左右,执行后标记 87% 进行事后审查,但长期记忆中毒指令检测率仅为 22%。
 The Verge · AI6565
IP保护公司Podqi的一项研究发现,ChatGPT、Gemini和Perplexity在回答购物相关问题时会推荐虚假零售网站,其中Perplexity在6795个回答中推荐了15%的此类网站,Gemini为4%,ChatGPT为8%。所有AI引擎都曾展示过仿冒真实零售商的网站、已重新注册的旧品牌域名或已失效但可被他人购买和重用的网站。
 IT之家 · AI6565
CNET 测试了 32 款手机,发现苹果 iPhone 18 Pro Max 在 45 分钟压力测试中掉电 1%、在 3 小时视频测试中耗电 6%,综合续航表现最佳。iPhone Duo 同列压力测试第一,Pixel 11 Pro XL 排名第三。测试累计超过 120 小时,iPhone 18 Pro Max 的优势得益于更大电池、iOS 27 优化以及 A20 Pro 芯片能效提升。
IT之家 · AI百度李彦宏在百度世界大会 2026 上推出大模型服务平台“词元所”,宣称解决模型选择困难、质量参差不齐的问题。词元所通过全面准入测试、持续质量监测及多维度评分体系确保模型可信度,并为模型提供方打分建立信用档案。上线一个月后,平台已汇聚 100 个供应资源,日均调用 Token 数达 7000 亿。
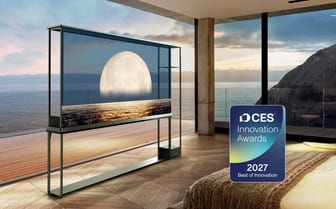
IT之家 · AI5050LG SIGNATURE OLED T6 获艺术科技类“最佳创新奖”,采用 77" 4K 透明 OLED 面板并支持 60GHz 毫米波 Zero Connect;新一代无线壁画电视 LG OLED evo AI W7 获视频显示类创新奖,厚度 15.7mm、支持 165Hz 刷新率。
36氪 · AI3535黄仁勋已回英伟达上班,就最近的风波向员工致歉;Anthropic IPO认购需求超数倍,拟通过IPO及私募融资最高904亿美元;谷歌推出Gemini Decisions API,每百万输入token收费0.10美元。
 AWS Machine Learning Blog3838
Claude Haiku 5.5 发布,成本比 4.5 版本低 75% 并支持成本控制;GPT-6.1 Terra 在 OpenAI 评测中表现与 GPT-6 Astra 相当且速度更快三倍。
 Databricks Blog5858
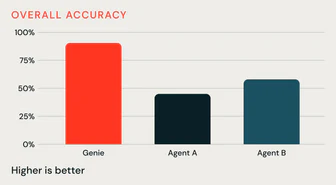
Genie 在包含表格、笔记本、仪表板等企业级知识资产的基准测试中,正确率达 91%,远超 Agent A(45%)和 Agent B(58%),同时 token 使用量减半,速度提升 3-4 倍。Genie Ontology 通过自动提取和组织企业知识,为 Genie 提供共享的业务理解,显著提升准确性和效率。
 IBM Research Blog3838
IBM Quantum Starling 将于 2029 年交付,能在 200 个量子比特上运行 1 亿个硬操作。IBM 已验证 c-coupler 技术,实现密集非局部量子比特连接,并将 qLDPC 代码改进至仅需五个量子比特连接而非六个。
Hugging Face Daily Papers6565MMDM评测了28个决策模型,显示多数模型在常见知识上表现良好,但在相互依赖选项、约束决策和多选任务上表现不佳。例如,Perplexity Decider-V1.2在知识单选上达78.75%准确率,但在选项逻辑和约束规划上分别只有53.95%和47.95%,而所有模型在硬多选上的最佳准确率仅为36.81%。
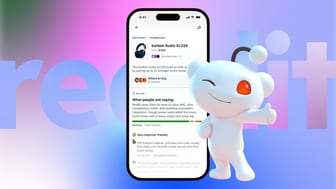
IT之家 · AI6565Reddit 测试 Reviews 功能通过 AI 汇总用户评论分析商品优缺点,但用户担忧其损害真实交流并助长软广,版主认为将模糊真实意见与广告。Reddit 称嵌入链接为快捷入口而非付费广告位,品牌方无法付费获取展示资格。
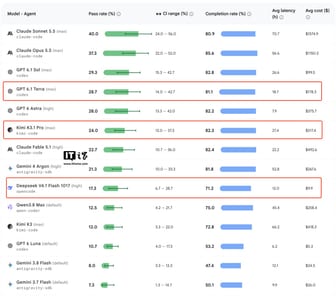
IT之家 · AI6565谷歌公布安卓AI开发基准Android Bench跑分,Kimi K3.1 Pro使用kimi-code智能体在30项任务中通过率24.0%。
IT之家 · AI同一件事 · 3 家3434Anthropic 启动最高 643.5 亿美元 IPO,估值 1~1.4 万亿美元;Anthropic 发布 Claude Fable 5.2 与 Claude Mythos 5.2 模型,编码、推理能力提升,输出速度最高提高 30%,成本下降 20%,API 调用费下降 20%。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
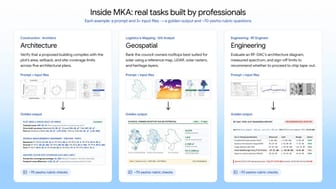
IT之家 · AI谷歌联合 Artificial Analysis 推出 MKA 基准测试,评估 AI 智能体处理多模态知识工作能力,Gemini 4 Carbon 获测试第二,任务成本为第一名的六分之一。
 Artificial Analysis Articles
Claude Fable 5.2 (max) 在 Multimodal Knowledge Agent (MKA) 评测中取得 57% 的 Climb WSR 分数领先,Gemini 4 Carbon (high) 以 54% 位居第二,Claude Opus 5.5 (max) 为 53%。
The Decoder同一件事 · 5 家Google 发布 Gemini 4 Carbon 模型,在 Artificial Analysis 测试中低于 Fable 5.2 的推理强度表现更优,与 Gemini 4 Argon 互补而非替代,后者更适合多数软件工程任务。
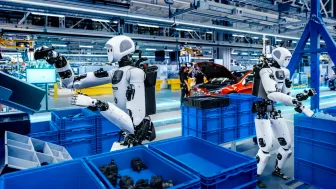
The DecoderGemini Robotics 2.5 在梅赛德斯-奔驰装配线试点中成功率达 96%,处理金属零件分拣任务;相比前代模型,任务成功率提高 30-100%,速度提升 20-30%。该模型为视觉语言行动模型(VLA),支持 Apptronik Apollo 2 人形机器人及 Franka Duo 平台,并采用实时控制避免物理危险,安全任务完成率提升 33%(近障碍物)和 43%(近人员)。
 OpenRouter Blog
Claude Opus 5.5 在 OpenRouter 测试中识别出 264 个关键值中的 262 个,以每千页 16.42 美元的价格领先,Mistral OCR 以 258 个关键值和每千页 2.02 美元的成本位居第二,Ling 3.0 Flash VL 因推理关闭以每千页 0.04 美元和 254 个关键值表现最佳。
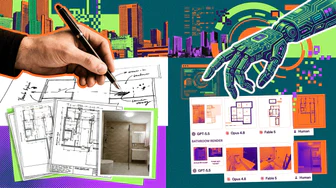
The Decoder同一件事 · 3 家Anthropic 的 Fable 5.2 完成 41.3% 的真实自由职业任务,较去年增长 38.5%。该模型在 3D 模型、音频编辑和建筑设计等领域表现突出,成功完成近 50 项此前 AI 未能解决的复杂项目。其直接前代 Fable 5.1 仅完成 17.8%,而 Opus 5.5 和 GPT 6 Astra 分别以 21.25% 和 20.83% 位列其后。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
量子位Fable 5.2 在智能体编程、软件工程测试等能力上全面超越 Opus 5.5,支持 100 万 Token 上下文,输出速度提升 30%,价格降 20%,API 每百万输入输出 Token 分别为 8 美元和 40 美元;网友实测可制作 3D 游戏、视频、交互体验,甚至从达·芬奇手稿生成 3D 模型,但高推理档位下 Token 消耗显著增加。
量子位Seedream 5.5 在连续编辑 100 轮图像的高压任务中表现优于 GPT-Image 2.6,展现出更强的稳定性。该模型提升了真实感,支持小字与多语言渲染、透明图生成与编辑,以及图层拆分与文字二次编辑功能。此外,Seedream 5.5 的 API 价格降至单张 0.28 元,速度提升,延续“输入图 + 输出图”两段计费结构,无文本 Token 费用。
IT之家 · AI同一件事 · 3 家Anthropic 发布了 Claude Fable 5.2 模型,编程能力在 FrontierCode 2.0 测试中达到 49.1%,超过 GPT-6 Astra 的 42.8%;在 Humanity's Last Exam 测试中得 74.2%,领先 GPT-6 Astra 的 57.2%。该模型输出速度最高提升 30%,成本下降 20%,API 调用费降至 $3/百万 tokens。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude Fable 5.2 在 Artificial Analysis 评测中获得 65 分,是目前最高分;该模型在 Intelligence Updated Capability Indexes 评测中表现优异。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
IT之家 · AI同一件事 · 2 家Muse Ember 是 Meta 最小、效率最高的 AI 模型,在 Artificial Analysis 排行榜中表现媲美 Claude Haiku 5.5,但单任务成本仅为 1/3 并超越 GPT-6 Luna。
IT之家 · AI同一件事 · 3 家Anthropic 推出 Claude Fable 5.2 和 Claude Mythos 5.2 模型,后者面向专业机构。Fable 5.2 每百万词元输入/输出费用分别为 8/40 美元,较 5.1 下降 20%。生成速度最高提升 30%,可选快速模式 2.5 倍速但价格更高。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Hugging Face Daily PapersGPT-5 在金融回测中正确回答 76% 的控制事实但声称仅知道 38%,其声称不知道的事实中 61% 仍正确回答。知识声称可延伸至测量知识边界后七个季度。历史日期指令能消除大部分知识声称而不改变准确率。
The Decoder同一件事 · 3 家Anthropic发布的Claude Fable 5.2和Mythos 5.2在多个基准测试中超越竞争对手,包括在Artificial Analysis Index v5高计算层级中以65分领先GPT-6和Gemini 4 Carbon。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Epoch AI
Nvidia GB300 相比 H100 在智能体推理任务上的能力提升达 25 倍,远超 8 位 FLOP/s 的 2.5 倍增长。IPI 指数通过比较芯片在多种输出速度要求下能同时处理的请求数量来衡量推理能力,GB300 设为基准值 1,得分为 1 的芯片能同等条件下服务两倍用户。IPI 版本 1 结合四款代表性模型结果,采用 GB300 当作参考基准。
Artificial Analysis Articles同一件事 · 2 家6666Muse Ember 得分 36,与 Claude Haiku 5.5 相当但任务成本仅为 0.14 美元,较后者低三分之二;其输入输出 token 价格与 Claude Haiku 5.5 和 GPT-6 Luna 相同,但缓存输入成本更低。在 AutomationBench-AA 上得分 68.1%,与 Muse Wonder 相当,但在知识准确率上最低(21.1%)
 Simon Willison3535
Claude Opus 5.5 在纯 JS + WebGL 环境中能完成 3D 模型转换,无需 Three.js 库。用户测试显示其生成的代码与 Three.js 版本存在差异,但功能相似。开发者认为 Three.js 版本代码更易理解,但实际使用中代码可读性差异不大。
Artificial Analysis Articles3838Artificial Analysis 发布决策指数 v2,采用新指标奖励模型正确性与校准置信度,45%基准基于私有数据集;Drex Max v1.1(Nace AI)以 73 分领先,GPT-6 Luna(Max)以 76 分位列语言模型第一,但成本与推理时间显著更高。