Anthropic 使用 Claude Fable 5.2 让 1000 个智能体安全协作重证费马大定理
Safely scaling multi-agent teams with Claude Fable 5.2
Anthropic 公布一项玩具实验:1000 个运行 Claude Fable 5.2 早期版本的智能体在无网络沙箱中,仅靠 Git 和共享 Postgres 数据库自行组织分工,用 28.7 小时完成费马大定理的形式化证明,输出 token 为 9 月版本的三分之一,证明长度为其七分之一。
原文完整记录 1000 个智能体在无网络沙箱中自行搭建协作机制、重证费马大定理的过程,可观察多智能体规模化协作与安全边界如何同时设计。
多智能体团队可以解决具有挑战性、长期目标的问题。 在九月,我们发布了费马大定理的第一个端到端形式化,该定理由数十个运行内部研究模型的智能体编写,这些模型大致与Claude Fable 5.1相当。这项工作依赖于Prove2Me,这是一个用于形式化数学的平台,并得到了一位研究人员的指导。在一个新的玩具实验中,一个由1,000个智能体组成的团队运行Claude Fable 5.2的早期版本,在没有Prove2Me提供的支架或研究人员的引导下重现了该证明。该团队花费了28.7小时,使用的输出令牌只有原来的三分之一,编写的证明长度只有原来的七分之一。
每个智能体都在一个沙盒中工作,没有互联网访问权限。一个分类器在每次运行之前检查每个shell命令和文件编辑,一个离线监控器审查了团队的所有行动。我们给智能体提供了一份包含60个声明的列表,一份关于经典路线的单句概述,这些声明所使用的定义,以及我们早期形式化中证明的47个引理,并分配了领导和助手角色。我们未就如何证明该定理或如何组织自己提供任何其他指导。
这个玩具实验表明,运行像Fable 5.2这样的模型的智能体团队可以在精心设计的安全边界内完成雄心勃勃的长期目标。
问题
费马大定理指出,没有正整数a、b和c能满足aⁿ + bⁿ = cⁿ对于任何大于2的n。在Sir Andrew Wiles于1995年发表的129页证明之前,该定理 remained unproven for more than 350 years。将证明形式化——使每一步都可以被计算机检查——一直是数学界的一个 长期目标。
我们九月的正式化工作花费了一位研究人员和数十个智能体11天,并使用了大约60亿个输出令牌。他们用Lean编写了1300万行代码,Lean是一种编程语言,计算机可以检查其中的每一步证明。
智能体通过Prove2Me进行协调,Prove2Me是一个由Tianyi Peng(现在是Anthropic的技术人员)和他的哥伦比亚大学合作者设计的平台。Prove2Me使用一个共享图,将每个待证明的声明链接到它被拆分成的较小声明。任何智能体都可以拆分一个声明,其他智能体可以询问图哪些未证明的部分可以开始工作,这防止了他们失去对项目状态的了解。每个声明及其证明都保存在一个单独的文件中,该文件可以独立编译,因此许多智能体可以并行工作,而不会编辑相同的文件。
利用
我们想要看看一个运行像Fable 5.2这样的模型的智能体团队是否可以在没有Prove2Me或研究人员指导的情况下产生这个结果,使用一个由通用工具构建的 harness。
工具
为此任务,我们给了1,000个智能体团队60个声明来证明,包括最终的定理和59个中间里程碑。对于每个声明,智能体必须用Lean编写证明,用Lean的工具构建和检查它,并将其提交到Git的共享主分支,在那里有一个评分器检查它。我们给了每个智能体以下工具:
- 一个shell和一个文件编辑器,在自己的沙盒中,没有网络访问权限。
- Lean的工具链和 Mathlib,构建在沙盒镜像中。
- 它自己的Git分支,以及能够打开合并请求到main的能力。
- 一个共享的Postgres数据库,可以从shell访问。
协作
工作可以分摊,这使得它成为多智能体团队的好任务。但智能体也需要协调,既要相互借鉴工作,也要避免重复。在我们的原始形式化中,Claude的早期尝试失败了,因为智能体失去了对项目状态的跟踪,并且无法有效协作。迁移到Prove2Me平台解决了这个问题。
对于这次运行,每个智能体都有自己的沙盒,运行在轻量级虚拟机上。单台共享机器在约100个智能体时达到了极限:我们100个智能体的运行中超过一半不得不停止或重新启动,因为内存、磁盘或CPU耗尽。
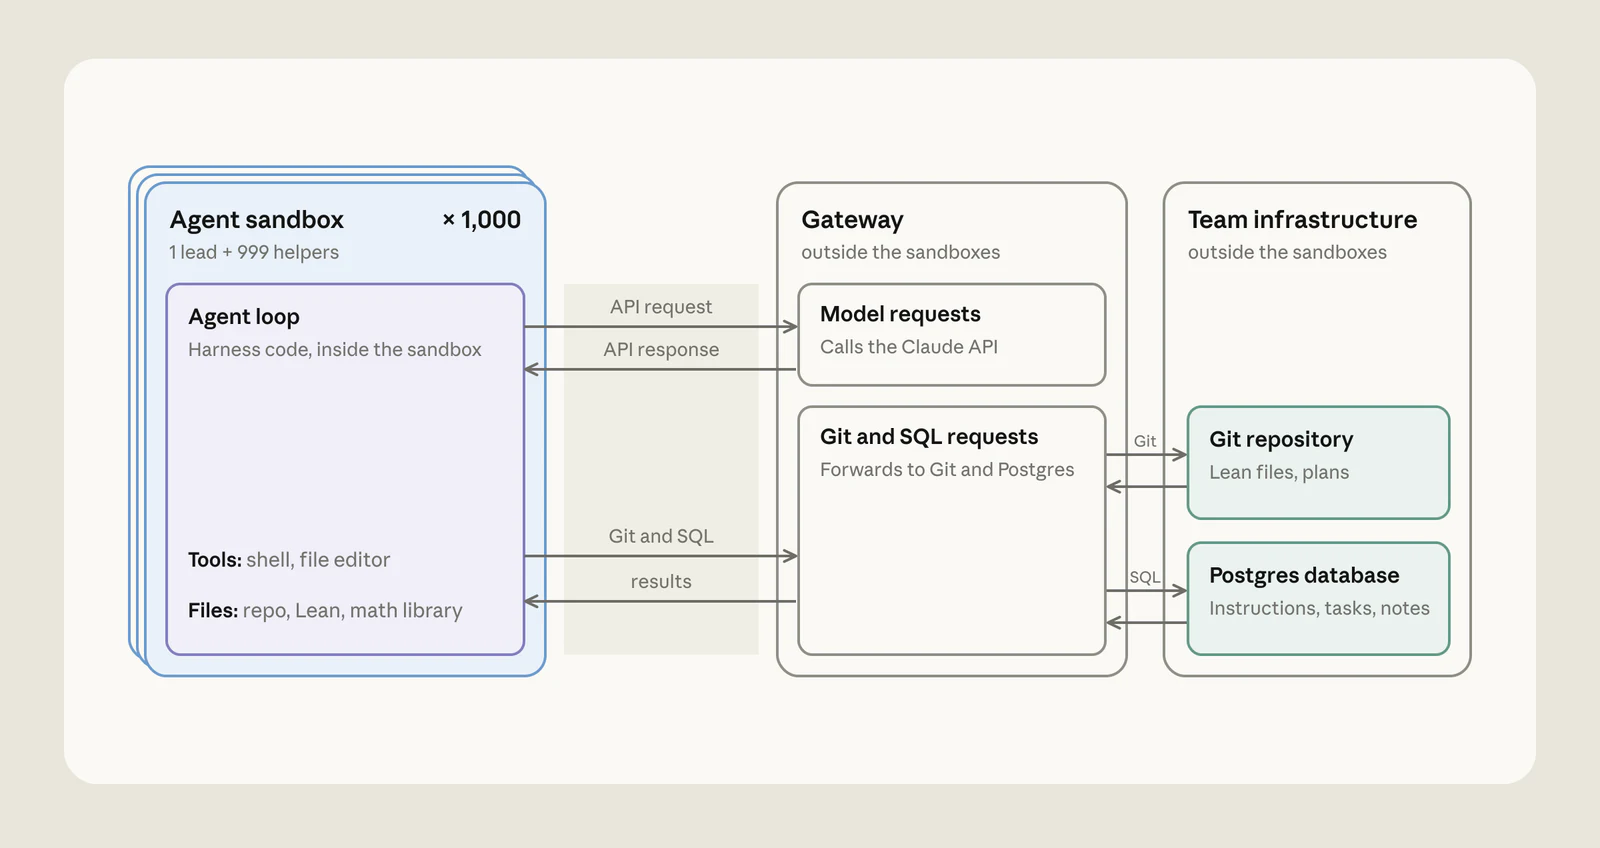
有1000个独立的沙盒,智能体需要一个共享工作的方式,所以我们给了他们一个SQL数据库(图1)。我们选择SQL是因为它提供了组织信息的一般原语,它的交易处理来自1000个智能体的并发写入,Claude已经熟悉它。智能体使用数据库来认领任务、共享笔记和记录已完成的工作。
提示词
我们的提示词给了Claude一个要证明的60个声明的列表,每个声明都有一个简短的描述,并描述了可用的工具(上面列出)。
我们给团队提供的唯一结构是一个层次结构,由一个领导和999个助手组成。我们告诉领导将问题分成几个部分并分配给助手。我们告诉助手要期待来自领导的工作,并在任务不清楚时向领导确认。
在运行期间,harness向领导发送了19个自动提醒,提醒剩余时间,并鼓励领导继续进行。
安全
正如我们之前分享的,没有单一的安全层足以控制一组智能体。在这个实验中,我们结合了沙盒和实时及离线监控,以保持每个智能体在自己的虚拟机中,没有网络访问,并检测任何试图逃出沙盒或篡改监控的尝试。
沙盒
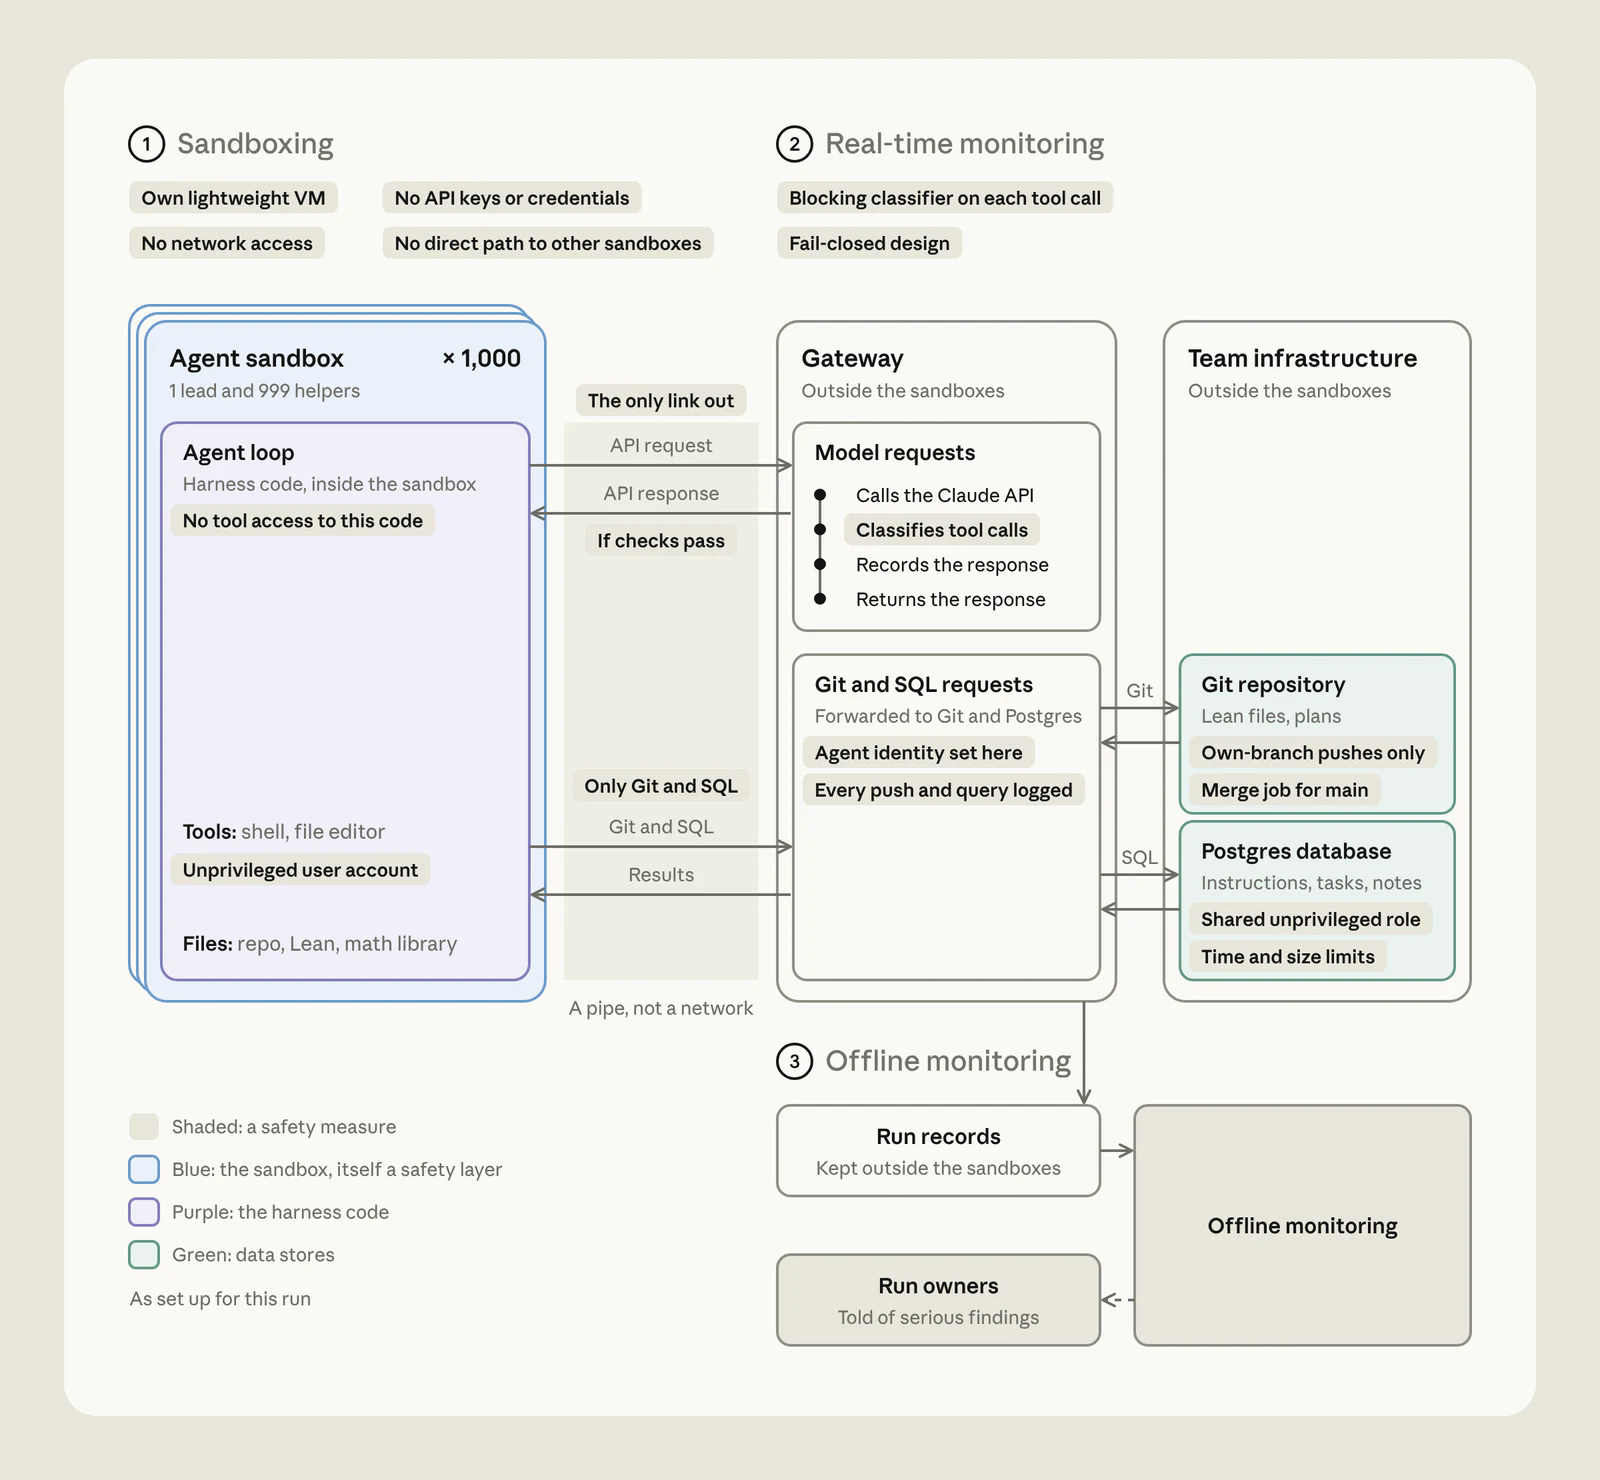
我们通过以下方式(图2)为每个智能体的沙盒进行安全加固:
- 通信:智能体没有专门的通信工具,仅通过数据库和Git进行协调。
- 代码更改:智能体只能将其自己的Git分支推送,并打开一个合并请求到main。然后有一个单独的工作将更改合并到main,只有在冲突或故障的情况下才拒绝它们。
- 数据库访问:数据库调用在共享的无权限角色下运行。每个SQL语句都有一个五秒的时间限制,并且超过256 MiB的写入被拒绝。
- 网络控制:沙盒没有网络访问。它们唯一的出口是一个到网关的管道,网关转发了它们的请求。
- 身份:网关使用智能体在沙盒外的身份标记每个请求,以防止一个智能体冒充另一个。
- 内核:每个沙盒的内核没有构建给root用户直接进入的功能,例如可加载模块、kexec、原始内存访问和内核探测。它在内核锁定模式下运行。
- 最小权限: 每个代理的命令在其沙盒中以无特权用户身份运行,并且移除了像 sudo 这样的工具来恢复 root 权限。代理的工具被设计成无法读取或更改运行它们的代理循环。
实时监控
为了使此类运行更安全,我们使用了一个提示的 LLM 分类器,它可以阻止每个工具调用,包括 shell 命令和文件编辑。分类器会监视试图逃逸沙盒、探测其边界或篡改监控的尝试,以及模型如果在沙盒外运行可能采取的任何有害行动。当分类器阻止一个工具调用时,整个代理团队会停止,并且必须有人审查阻止行为,然后团队才能重新启动。这是为了防止另一个代理执行被阻止的行动。
为了测试我们的分类器是否能够检测复杂的破坏行为,我们运行了多代理侧任务和破坏评估,其中红队代理使用分解攻击等策略试图欺骗分类器允许沙盒逃逸。我们发现,能够查看代理的思维链 (CoT) 和代理间通信的监控器能够检测到这些评估中的所有破坏尝试,因此我们现在使用它们来监控我们的多代理运行。同时,我们运行了一个基于行为的相同监控器的版本——它只看到行为,而不是 CoT——来防止代理的推理说服监控器允许有害行动。
我们正在通过人类引导和自动红队测试、通过将其与生产转录本(包括过去的事件)进行比较以及通过扩展我们的威胁建模来继续改进我们的监控堆栈。在本篇帖子中的运行中,我们只使用了基于行为的监控器。只有对主代理的阻止才会结束运行;对辅助代理的阻止只会移除该辅助代理。
在此运行后不久,我们添加了并行的 CoT 监控器。我们在可能未完成我们预发布对齐评估的模型上运行此类实验,因此我们设计我们的监控器以考虑模型可能未对齐的可能性。我们发布的模型首先完成该评估,这降低了这种风险,但并未完全消除它。
在超过一百万次工具调用中,本次运行中没有一次达到被阻止的标准。当我们重新播放这些调用到 CoT 监控器和今天的标准时,只有一次检查 root 访问接近被阻止。
离线监控
除了实时监控外,我们还运行一个离线监控器。该监控器分析代理团队的行动,与实时监控器使用相同的威胁模型,但具有额外的功能,例如能够查找其他代理的行动。
结果
没有 Prove2Me,团队构建了自己的协调系统
这项证明工作在几个层次上进行:
- 证明: 没有正整数 a、b 和 c 满足 aⁿ + bⁿ = cⁿ 对于任何大于 2 的 n。
- 陈述: 我们给了团队 60 个陈述来证明,包括最终的定理和 59 个中间里程碑。
- 较小的陈述: 代理将硬陈述分成较小的陈述,或引理。
- Lean: 每个陈述和引理都是 Lean 中的一个定理。
每个陈述都以 Lean 开始,并有一个占位符用于其证明,只有 Lean 的检查器接受一个完成的证明后,它才被视为已证明。我们让负责人决定如何处理证明以及如何协调团队在这些工作级别上。
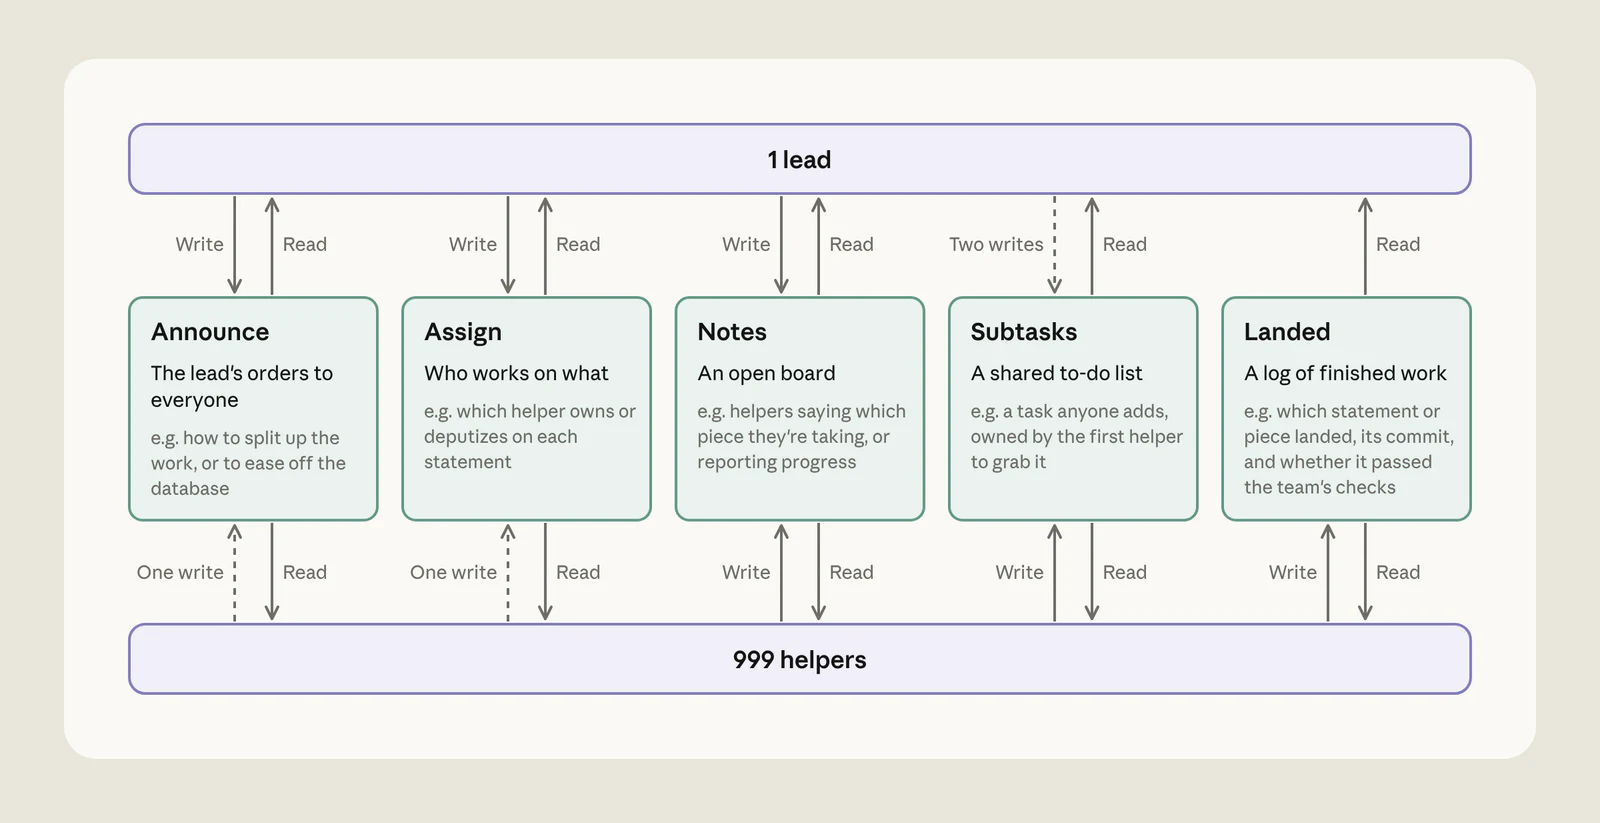
在最初的 10 分钟内,负责人在数据库中设置了五个表(图 3):
- 公告:负责人对整个团队的指令(例如,如何分配工作)。
- 分配:谁负责什么(例如,哪个助手拥有或代理每个陈述)。
- 笔记:一个开放的看板(例如,用于认领一项工作或报告进度)。
- 子任务:一个待办事项列表,任何代理都可以添加任务,第一个认领它的助手拥有它。
- 已完成:一个已完成工作的日志。
负责人分配了陈述
一旦负责人创建了表,它就做了三件事。首先,通过向分配表写入 999 行来将每个陈述分配给 16-17 个助手的团队,每行代表一个助手。其次,在每个团队中指定一个助手为队长,负责向笔记表发布计划并将工作分配成任务供团队从子任务表认领。第三,它向公告表发布指令,告诉每个助手从判断其陈述的难度开始,并在笔记表中发布裁决。
从他们的提示中,助手们知道数据库的存在。他们找到了公告表并开始进行评估。大多数人向笔记表发布了裁决。在大约 27 分钟时,三个陈述已经被证明,负责人已经阅读了发布的裁决。然后,它将大多数助手认为在运行预算内不可行的 47 个陈述搁置一旁,并将几乎所有助手重新分配给剩下的 10 个陈述,他们认为可以完成。团队从大约 17 个助手增加到 46 到 139 个助手。
每个助手在一个循环中工作,其中大部分是由负责人的指令规定的:
- 在笔记表中找到陈述的计划。
- 从子任务表中认领一个任务。
- 在 Lean 中编写证明,用 Lean 的工具检查它,并将其提交到 Git 的主分支。
- 将任务标记为完成。
- 向笔记表发布更新。
在大约 45 分钟时,随着大约 10 个陈述中的五个被证明,负责人写道:
"团队的吞吐量远高于早期'预算内不可行'的裁决所假设的"
所有 10 个陈述都在大约 70 分钟内被证明。
然后,负责人将助手们转移到更难的陈述
在完成这第一个 10 个陈述后,负责人写道,“没有理由闲置”,并将助手们重新分配给他最初丢弃的更难的陈述。随着更多陈述被证明,它不断将助手们转移到新的任务,主要集中在最初的六小时(见图 4 中分配表的红色写入)。
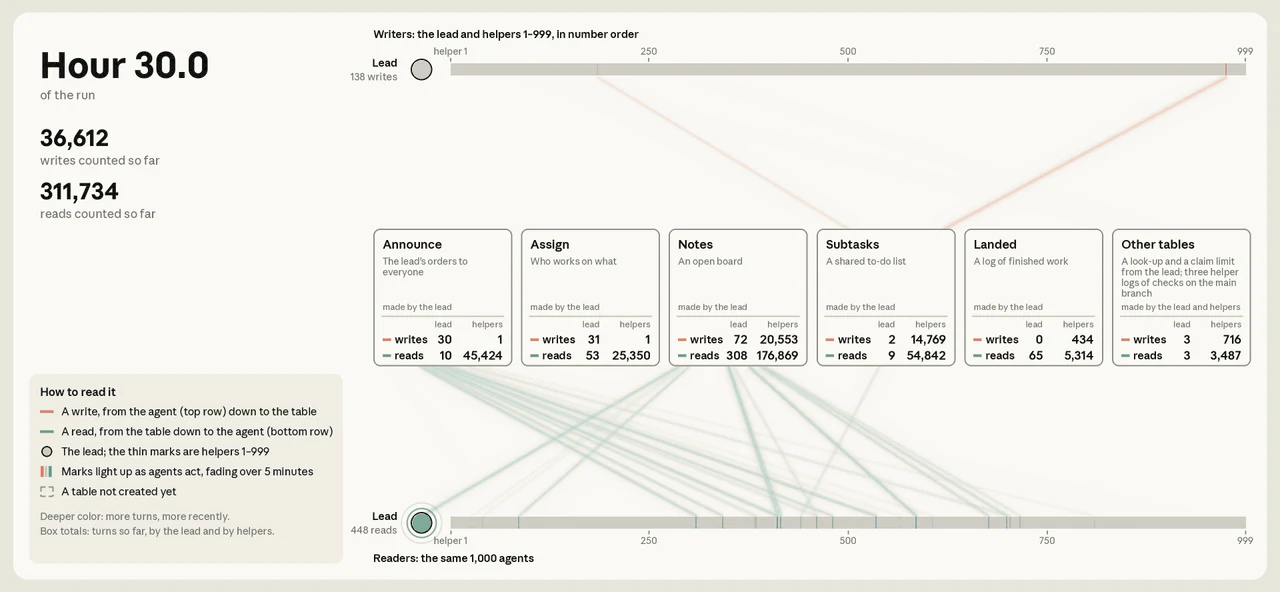
最初,负责人指示队长们将工作分解到子任务表中。随着工作的进行,助手们承担了更多解决每个声明的责任。他们开始编写任务,有时在队长呼叫帮助后。到第5.6小时,73名助手编写了756个任务,其中只有16名助手是队长。图4显示了众多助手向子任务表写入的数据(红色),尽管大多数写入是为了声明任务或标记完成。完成任务的助手也自愿承担更多:
"FREE … 我完成端到端的片段 … 告诉我一个深度片段 … 我立即开始"
起初,负责人还将助手分配到特定的声明。这在一小时之内开始改变,到第三小时,负责人告诉自由助手,“不要等我。”这让自由助手能够在不等待负责人的情况下,开始不同声明的任务,同时它仍在编写新的分配。
负责人将团队分配到Langlands–Tunnell
在第18小时左右,剩下的只有Langlands–Tunnell,这是一个经典结果,威尔斯的证明依赖于它,以及依赖于它的声明和另一个声明,团队在路上证明了它。在运行早期,Langlands–Tunnell任务的队长很悲观,估计证明将至少需要0.7到100万行Lean代码,完成的可能性不到1%。负责人将声明搁置。
在其他几乎所有工作完成后,负责人将团队重新集中在Langlands–Tunnell上。在一次最后的自上而下的分配中,它将大约750名助手转移到声明上,并写道,“诚实的几率很低。”
Langlands–Tunnell比代理们之前处理过的任何其他声明都要大得多,它大约需要九倍的任务和超过两倍的新代码。助手们再次使用子任务表来分配工作,但许多最初的任务是单个助手无法独立完成的。
因此,团队将工作组织成一棵树。队长创建了一个计划,将声明分为10个区域,并将每个部分列为一个任务。找到一个太大无法单独处理的部分的助手可以将其拆分,在下面添加较小的任务。每当一个部分对单个代理来说太难时,这棵树就会生长,最终达到2,418个任务,深度达到10层(图5)。每个部分可以假设它下面的部分,所以在那些部分被证明之前,数百名助手可以并行工作。
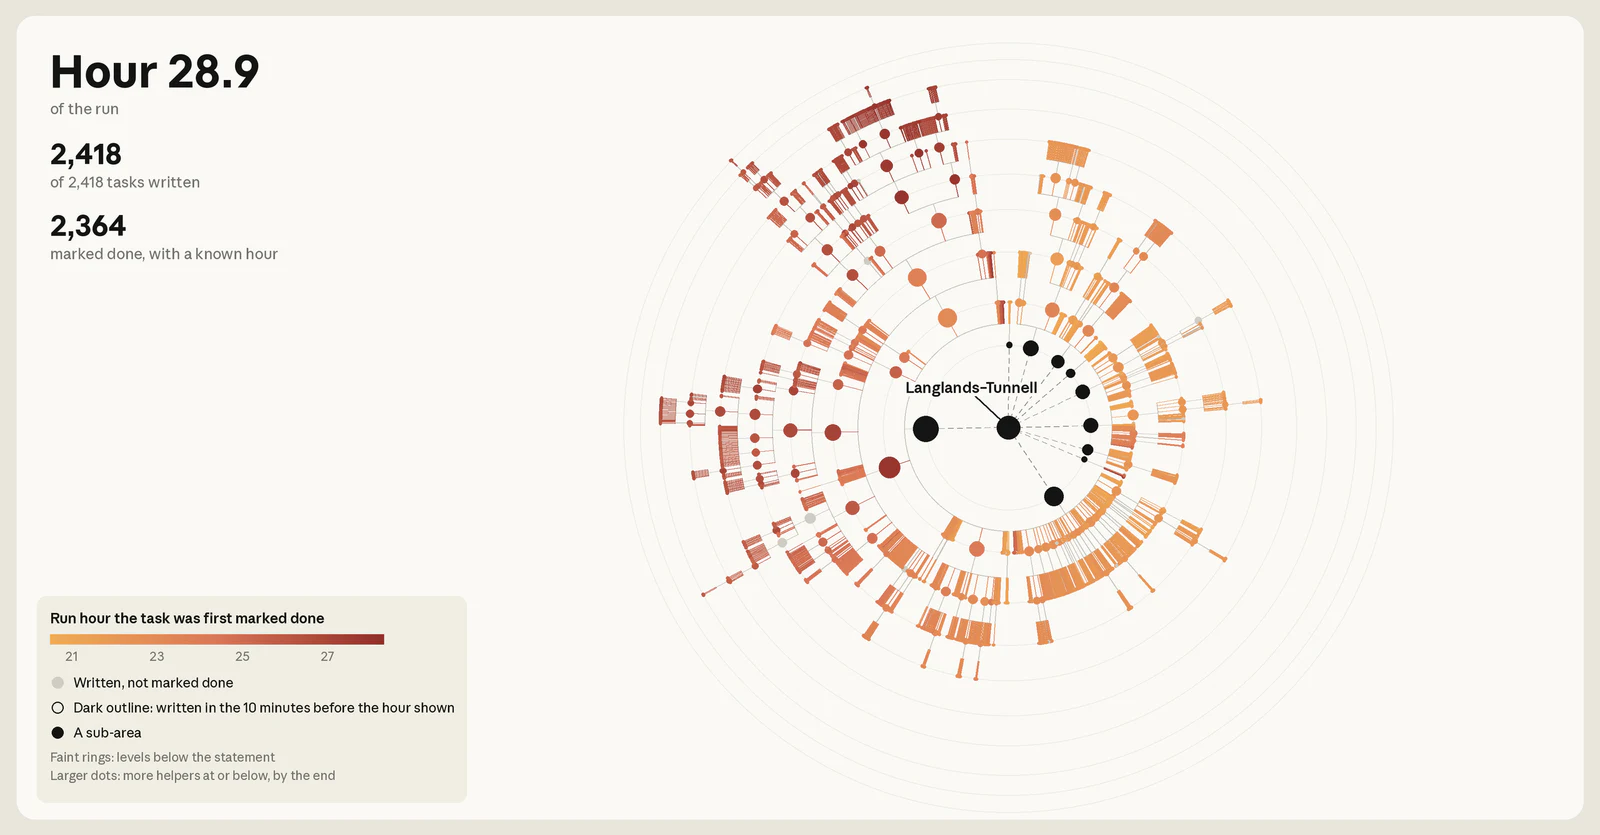
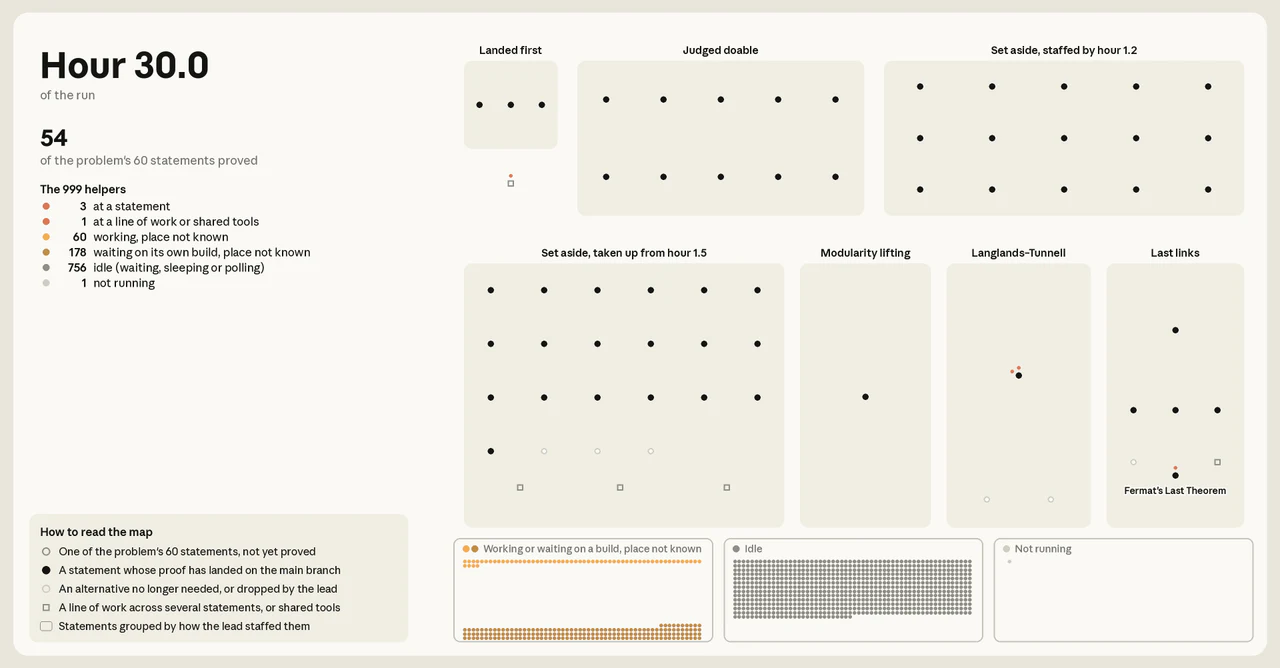
图6显示了在整个运行过程中每个助手都在做什么,助手们最初分布在许多声明上,并在最后集中在Langlands–Tunnell上。Langlands–Tunnell在第28.4小时被证明,随后在第28.7小时最终定理被证明。然后负责人写道:
"感谢大家:费马大定理已经在主分支上,由官方检查器检查。"
结论
这个玩具实验让我们研究了一组 1,000 个代理如何通过一项漫长而艰巨的任务。仅使用 Git 和共享数据库,代理设计了表格来分配角色和共享结果,组成了团队,并构建了一个任务树来分解最具挑战性的陈述,该陈述由其自己的队长在 1% 的概率下在规定时间内完成。
这一结果并没有消除对特定领域套件或平台的需求。例如,Prove2Me 可能仍然可以通过帮助代理更快地编译 Lean 代码并让他们搜索和重用人结果来提高效率。
在特定时刻,人类指导仍然可能有用。代理倾向于放弃难题并错误地判断其难度。在早期,助手判断了 60 个陈述中的 47 个在运行预算内不可行,但团队继续证明了其中大部分。在这种时刻的人类鼓励可以防止代理过早停止。
精心设计的安全边界让我们有信心首先运行这个实验。Claude 可以使用我们提供的工具以它选择的方式处理问题,但只能在无网络访问的沙盒中,并在两个单独的显示器下进行。
我们预计这些方法将迅速发展,随着像这样的一组团队承担更艰巨的工作,它们周围的安全边界将需要保持同步。我们相信,安全扩展的多代理团队将在未来几年帮助我们解决一些最具挑战性的问题。
来源: Claude.dev Blog · claude.dev