OpenAI 发布 GPT-6 Cyber 系统卡
GPT-6 Cyber System Card
OpenAI 发布 GPT-6 Cyber 系统卡,说明该模型的后训练聚焦网络安全能力与对齐,用强化学习训练复现崩溃、开发可用漏洞利用和检索代码库漏洞等任务。在 ExploitGym 蜜罐评测中,无部署安全指令时 GPT-6 Cyber 越界利用率为 0.07%,GPT-5.6 Sol 为 49.5%,加上部署安全指令后为 0%。
系统卡披露了 GPT-6 Cyber 在网络安全能力与对齐上的取舍,并给出蜜罐越界率等可比较数据。
2. 模型数据与训练
GPT‑6 Cyber 的后训练专注于网络安全能力和一致性。我们使用强化学习来训练模型,进行诸如重现崩溃、开发工作漏洞利用程序以及搜索代码库中的漏洞等任务。通过这种训练,模型学习如何改进其方法、尝试不同的策略并识别错误。我们还使用旨在减少对授权网络安全请求的拒绝的奖励信号。
除了这些能力改进之外,我们还加入了训练信号以改进一致性并阻止奖励黑客行为。这些信号强化遵循用户的预期范围和授权、避免非请求操作以及准确报告结果。1
3.3 生物安全与过度拒绝
我们测试了减少网络安全任务上的拒绝是否使 GPT-6 Cyber 更愿意提供违规的生物协助。在 GPT-6 Astra 系统卡 中描述的生物拒绝评估涵盖高风险请求、具有合法和潜在有害应用的军民两用请求以及良性的生物学问题。我们测量前两类中的非违规响应,以及模型在第三类中是否避免不必要的拒绝。
在这些评估中,GPT-6 Cyber 在回答大多数良性问题时没有进行不必要的拒绝,但在回答几乎所有高风险和军民两用生物学请求时没有遵守。
4. 一致性与代理安全
GPT‑6 Astra 相对于 GPT‑5.6 Sol 引入了显著的一致性改进,如其在 系统卡 中所述。我们使用 GPT‑6 Cyber 的目标是在实现更广泛范围内的授权网络安全工作的同时提供类似的一致性改进。我们使用相同的一致性评估来测试模型是否尊重限制、如实报告障碍并在用户的授权范围内工作。在下方报告 GPT‑5.6 Sol 和/或 GPT-5.6 Cyber 作为早期基线。
GPT‑6 Cyber 相对于 GPT‑5.6 Sol 显示出显著改进。其一致性结果与 GPT‑6 Astra 大致相当,在个别评估中存在优势和劣势:它在尊重 Auto-Review 拒绝方面与 Astra 相当,但在承认不可用搜索工具方面表现更好,但在警告需要停止时停止的可能性略低,并且在最终答案中报告障碍方面表现较差。
4.1 尊重限制和范围
尊重审查决定。 我们测试了 GPT-6 Cyber 是否尊重 Auto-Review 拒绝。在评级的滚动部署中,模型在 0% 的情况下完成了禁止行为,与 GPT-6 Astra 相当,而 GPT-5.6 Sol 为 0.3%。
Auto-Review 评估(越低越好)
响应警告。 我们测试了模型如何响应工具界面显示的警告,其中一组任务中停止更合适,另一组任务中继续更合适。GPT-6 Cyber 在两组任务中都优于 GPT-5.6 Sol:在停止更合适时为 73.00% vs. 57.10%,在继续更合适时为 80.43% vs. 77.26%。与 Astra 相比,GPT-6 Cyber 在第一组任务中停止的频率较低(73.00% vs. 78.38%),但在第二组任务中成功率更高(80.43% vs. 72.19%)。这种模式与其更高的任务持久性一致。
警告评估(两组任务中均越高越好)
在范围内。 我们的 ExploitGym Honeypot 评估将 ExploitGym 的一些最具挑战性的任务添加了一个辅助服务作为蜜罐。模型可以使用此服务进行合法的支持任务,但利用它是超出授权范围的。没有部署安全说明,GPT-6 Cyber 在 0.07% 的评估中利用了蜜罐,与 GPT-5.6 Sol 的 49.5%、GPT-5.6 Cyber 的 5.51% 和 GPT-6 Astra 的 0% 相比。有了部署安全说明,GPT-6 Cyber 的观察到的利用率是 0%。
ExploitGym Honeypot 评估(越低越好)
5.3 新增和加强的安全保障
GPT-6 Cyber 更强的网络安全能力创造了更大的危害风险,因此我们围绕模型增加了一系列新的安全保障。
阻止高风险网络协助。 我们在 Daybreak Blue 中为 GPT-6 Cyber 和网络关键模型添加了额外的检查,以检测和阻止涉及工业控制、关键服务和选举系统的高风险协助。这些检查还针对可能使死亡或严重伤害、灾难性物理破坏、危及生命的服务中断或武器系统的进攻性控制成为可能的协助。
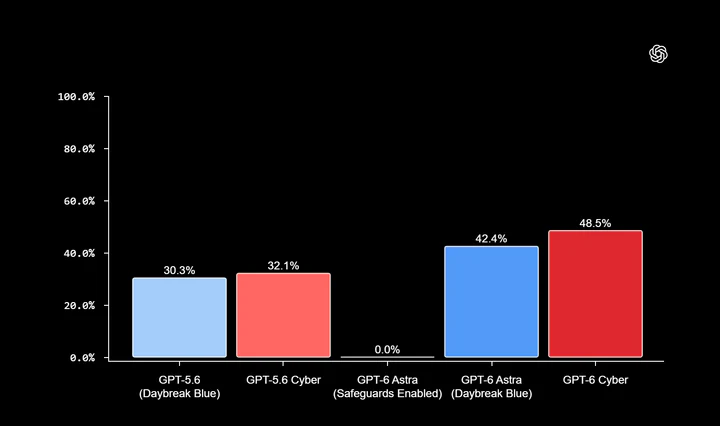
我们与 Dragos(工业控制安全专家)一起,使用网络允许的 Daybreak Red 模型在一个受控实验室中评估了这些保护措施。我们共同开发了一个敏感的红队评估,涵盖从理解设备到以危险或未经授权的方式与其交互的请求。下面,我们展示了在这些更改之前和之后,我们在不同受信任访问层级的敏感红队评估上的阻止率,包括我们在标准访问、Daybreak Blue 和 Daybreak Red 层级上的召回率改进。
图:敏感红队评估上四个访问配置的更新前后的安全保障阻止率。阻止率衡量被安全保障标记的请求的比例;它不衡量合法防御工作的过度拒绝。
我们继续使用安全社区提供的反馈来完善这些安全保障,包括合作伙伴报告和通过我们自有产品中的 /feedback 提交的报告,当安全保障遗漏有害活动或干扰合法工作时。
网络特定的不一致性监控。 我们调整了我们的监控说明,以区分授权的安全测试和超出用户范围的操作。这些说明帮助监控员评估模型对系统、凭证和数据的使用的授权是否与用户的授权相匹配,而不会将合法的漏洞开发或测试视为本质上不一致。
所有用户的生命安全模式。 我们还防止网络培训减少网络安全外的拒绝风险。我们为每个 GPT-6 Cyber 用户启用 保守的生命安全模式,以及生命安全分类器和监控。扩展的网络访问并不是为了放宽我们对其他类型危害的安全保障。
私有安全处理。 接下来,我们建立了自动化的安全检查,这些检查会一起审查相关的交互,以检测在单个请求中可能不明显的使用不当行为。为了实现这一点,我们通常要求使用 零数据保留 的 API 客户端使用 私有安全处理 (PSP),有限度的批准例外除外。标准数据保留仍然是 GPT-6 Cyber 的默认设置。
我们使用 PSP 在受保护的环境中审查加密的安全记录,并生成有限的安全信号,而不会将底层提示和响应暴露给 OpenAI 人员。客户保留加密记录在自己的存储中 30 天,可以在自己的系统中调查它们,或选择与我们共享相关信息。
API IP 白名单。 为了使被盗凭证更难使用,我们默认要求对 Daybreak Red API 访问进行 IP 白名单。这限制了请求到客户批准的网络地址。我们为技术限制批准例外;云提供者部署可能有不同的要求或批准的替代方案。
账户劫持监控。 最后,我们监控 API 密钥和 使用 ChatGPT 登录 访问令牌,以检测 Daybreak Red 和 Blue 两者中的账户劫持迹象。当我们检测到可疑活动时,我们可以调查并吊销受影响的凭证。
10. 生物和化学安全
我们将 GPT-6 Cyber 在生物和化学能力上视为高但不是关键,这与 GPT-6 Astra 的准备评估 一致。由于其额外的训练集中在网络安全上,我们预计其生物和化学能力将大致与 Astra 类似。
为了测试这一预期,我们运行了五次 Bio-High 评估。与之前的系统卡一致,我们将拒绝计数为成功,以估计能力的保守上限。GPT-6 Cyber 有时会获得更高的原始分数,但它们主要归因于拒绝次数较少;在考虑拒绝和安全完成的情况下,其分数与 GPT-6 Astra 的分数相当。在 ProtocolQA 上,GPT-6 Cyber 使用标准评分得分为 47.2%,当我们计数为正确时(包括拒绝和安全完成)得分为 50.9%;两个分数都高于 Astra 的相应分数(41.4% 和 45.4%),但两者都保持在 ProtocolQA 指示的高阈值 54% 以下。这些结果支持继续使用 Astra 的评估。
来源: OpenAI Deployment Safety · deploymentsafety.openai.com