Flint-interactive:一种用于创建交互式数据可视化的语言
Flint-interactive 使 AI 生成的图表具有丰富的交互性,用户可通过点击、筛选、缩放、高亮和跨图表交互来探索数据。它通过高级语义事件和更新操作简化复杂交互的构建,并利用 Flint 编译器处理交互逻辑和视觉依赖,提高可靠性和开发效率。Flint-interactive 支持创建交互式数据故事、仪表板和连接体验,AI 代理可使用其生成带交互功能的图表,帮助用户更高效地分析数据。

Rescale 利用 Strands Agents 和 AI-DLC 框架在 AWS 上五天完成智能分流代理的搭建,并在数周内投入生产。该代理通过调用 Claude Opus 4.8 对夜间端到端测试失败进行分类,检索知识库中的历史失败模式,查询 MCP 日志获取运行时证据,生成包含文件引用、函数名和推荐修复方案的整改报告供工程师审核。
METR 和 Redwood Research 对 OpenAI 内部智能体监控系统进行了为期三周的深度访问红队测试,评估了约 75-94% 的 GPT-5.5 及以上模型 Agentic Responses API 流量在测试时的监控覆盖率。
Redwood Research 与 METR 员工在 7 月 21 日至 8 月 11 日期间对 OpenAI 内部智能体监控系统进行深度测试,发现约 75-94% 的 GPT-5.5 及以上模型 Agentic Responses API 流量可被监控。
LASAGNA评估了450种RAG管道配置在8个基准和5K-200K文档语料库上的表现,发现不同阶段单个技术优势不必然组合有效,检索质量与答案忠实度优化方向不同,最佳组合随语料库规模变化,表明孤立测试结果不可靠,新RAG技术需在完整环境中评估。
𝜏-Entity基准测试语音智能体在200项任务中捕捉姓名、电话等实体信息的准确性。GPT Live 1在常规条件下正确率为60.3%,但在噪声和语音干扰下仅为34.0%;推荐验证策略可将成功率提升14-31个百分点,但通话时长增加21-28秒。
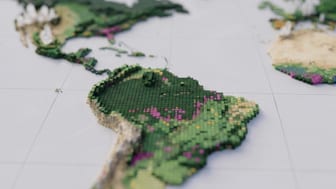
Google DeepMind 与 Google Research 联合发布 Forest Typology (ForTy) 2020 全球地图,将地球每 10x10 米土地分类为六种森林和土地利用类型,并追踪 2017-2025 年变化。该地图基于联合国粮农组织定义,准确区分原生林、人工林、单一物种林浆、经济作物林和其它土地,支持欧盟防砍伐法规,准确率达 90%。
各家口径不同:谷歌 DeepMind 表示地图将土地分为六种类型;The Decoder 提到只有四种类型(原始森林、木材种植园和树作物农场)。
AKV 提出缓存工程方案,通过 drop 和 repos 操作管理 LLM 智能体键值缓存,提升效率与准确性;实验显示,工具响应滚动 drop 缓存策略使平均基准分数提升 1.7 分,成本降低 27.7%,输出吞吐量最高提升 1.2 倍,P95 请求延迟加速 1.5 倍。
未来块预测(FCP)通过引入未来块监督,改进自回归视频扩散模型,生成更符合物理规律的视频并降低训练成本。该方法在教师强制(teacher forcing)框架下,预测时间上分离的视频块而不依赖中间视觉上下文,直接利用训练视频提供监督,无需额外预训练视觉编码器且不改变自回归推理。
Socratic Skill Learning 通过教学与练习交替的方式提升可迁移的智能体技能,在主要测试集上达到 0.801 的效用,优于轨迹蒸馏和对比蒸馏方法。
StreamEval 基准测试了交互式流式视频生成模型在五个任务上的表现,发现可靠的请求执行和持续的状态一致性仍是主要挑战。该基准包含 300 个脚本化测试用例,涵盖角色对话、角色表演、世界生成、指令编辑和参考编辑任务,通过四个评估维度(任务执行、状态一致性、视觉保真度和视听协调)进行评分。
Spectral-Spatial Interpretation (SSI) 发布,使用符号归因解释模型分数,为每个空间单元和频谱通道分配贡献度。SSI 在三个数据集和两种掩码基线下的三个指标平均表现最佳,例如 HLS 联合删除的均值基线得分 0.1545 高于 KernelSHAP 的 0.2096。SSI 在空间定位、频谱 Hit@K 和通道删除方面领先于比较方法。
LGWM 预测下一屏的表示来验证 GUI 转换,在 RSWT-BENCH 上训练无需语义标注,达到 0.987 AUC,决策耗时 17 ms,优于生成式 GUI 世界模型三个数量级。
投资研究公司 Citrini 与 Anthropic 合作尝试让未发布的 Claude 模型生成蝎子抗毒血清,该模型生成了约 211 个候选蛋白质设计,其中 17 个能结合部分蝎子毒素,但专家指出这仅是药物开发的早期阶段,将候选分子转化为有效药物仍面临巨大挑战。Citrini 承认实验未成功制造出药物,但称其展示了 AI 辅助药物发现的潜力
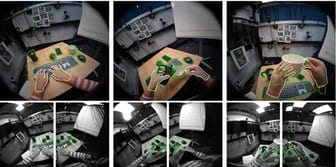
NVIDIA EgoScale 项目通过将摄像头安装在 1000 名参与者的前额和手腕,收集了 20,854 小时的第一人称视频数据,用于训练人形机器人手部技能;这种被称为“以自我为中心的数据收集”的新方法,标志着人形机器人数据收集进入第三代,旨在解决传统远程操控和同构外骨骼方法的疲劳、成本和精度问题。
生数科技Motubrain团队连续直播半个月公开Physical AI训练全流程,此前小米MiMo负责人罗福莉已公开MiMo-V2.6强化学习阶段训练进展。
Adobe Research 与 UCLA 提出的 Tev 模型在长程推理任务上追平 GPT-6 Astra 与 Claude Opus 5 的表现,该模型为 27B 参数规模的开源模型,通过构建“答案世界”并设计长程考题提升智能体能力。
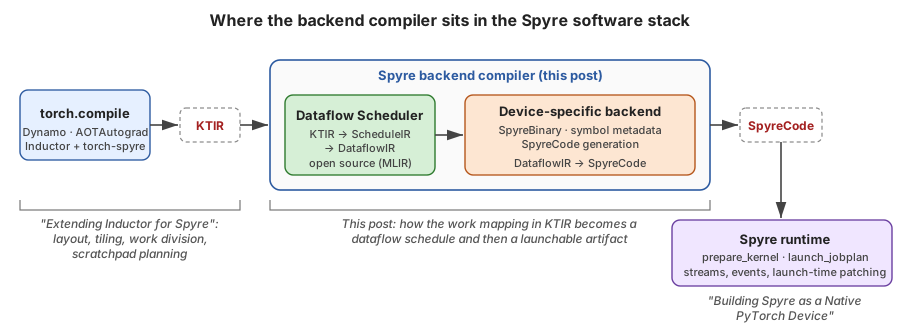
Torch-spyre 的 Inductor 决定每个内核的工作如何在 Spyre 的核心上分配,并管理张量在片上 Scratchpad 和片外内存之间的驻留,而后端编译器将这些决策转换为硬件可以实际运行的指令。
千诀科技发布预测式世界模型Polibrain,比LeCun团队相近研究早一年。该模型通过多项式表征和因果记忆技术,让机器人学会根据物理世界变化自主决策,已在四足、人形、轮式等机器人形态上适配。Polibrain采用松耦合架构,将环境理解与动作执行分离,支持跨本体复用,为不同机器人提供智能能力。
OpenAI联合PerturbAI和Scripps Research部署数千个AI代理,在GPT-Rosalind上分析来自数百万老鼠细胞的生物数据,完成全脑CRISPR图谱分析耗时32分钟,而人工分析需数月至一年;人类专家在盲测中75%时间内更偏好分布式代理的报告;"推理图谱"已开源至GitHub,相关论文发布在bioRxiv。
米哈游联合清华北大等高校发布开源 GameScaling 游戏模型,覆盖 0.8B 至 27B 参数规模。该系列 8 个模型基于 Qwen3.5 视觉语言模型继续预训练,训练数据涉及《我的世界》《毁灭战士》等游戏。模型接收游戏画面及操作记录生成后续指令,支持实时游戏交互,4 种参数规模各有 S1、S3 两个版本,采用 Apache 2.0 许可证。
Perplexity 与 NVIDIA 联合推出 JOLT,一种语言模型后训练方法,通过联合在线学习和教学,用单一模型同时扮演师生角色,教师模型接受特权信息并接受 KL 惩罚以接近学生模型,学生模型通过教师模型的 token 级别蒸馏信号学习。
Cactus Whistle语音模型在CPU上以16.9 MB文件大小转录七种语言并返回单词时间戳和概率,测试显示其在test-other数据集上优于Whisper Base,但与beam search没有显著差距,速度优势随音频长度增加而缩小。此外还测试了30秒窗口音频处理、流式延迟、时间戳、关键词偏差、其他语言、噪音、嵌入和语音到工具调用功能。
WildAWM 通过交互合成可控的计算机环境与任务,提升通用智能体在 Web、CLI 和 GUI 基准测试中的泛化性能。该系统支持图形界面、模型上下文协议服务及命令行界面,完全基于开源模型,并引入基于执行的关卡机制解决任务合成中的可解性、难度维持和验证器可靠性问题。Qwen 模型在 WildAWM 合成环境中训练后,在 8 项跨分布基准测试中取得显著提升。
研究通过在数据规模、多样性和模型大小三个维度上进行持续预训练(CPT),提升了虚拟世界中的具身智能体学习能力,但在远距离世界泛化上存在局限。研究测试了涵盖 0.8B 至 27B 参数、50 至 1600 小时数据预算、五种数据混合的 120 种配置,发现数据量增加提升内部表现,多样性改善相关世界迁移,模型规模提升数据效率但远距离泛化更差。
PrismaForge 通过基于评分的管道合成和过滤高质量多模态代码数据,使开源模型在视觉编码任务上能与专有系统匹敌;PrismaCoder-2M 是目前最多样化和最大的开源多模态代码数据集,PrismaCoder-9B 和 PrismaCoder-35B 在此数据上训练后,性能大幅领先开源领域并媲美专有系统。
DONIC 是首个通用双臂追踪模型,通过强化学习与循环演示训练,无需微调即可在未见过物体上实现 86.79% 的成功率,超越现有双臂追踪基线 77.36 个百分点;其结合了近端策略优化与行为克隆,并采用以物体为中心的每手奖励机制。
SpatialScout 评估了 VLM 智能体在主动 3D 对象映射上的表现,揭示其在精确度量地图构建上的重大缺陷。Claude Opus 5.5 在该基准测试中平均重叠得分为 41.71%,47.23% 的目标 IoU 低于 0.5,仅 3.25% 超过 0.9,显示从恢复粗略布局到构建完整精确度量地图存在显著差距。
Deep Insight 是一个将复杂数据分析转化为自动化洞察的多智能体系统,包含 Coordinator 至 Tracker 七个层级智能体协作完成 CSV 数据分析并生成报告。
𝜏-i18n 将 𝜏-Voice 扩展至西班牙语、巴西葡萄牙语、印地语、韩语和普通话五种语言,使用航空、零售和电信任务评估跨语言性能。评估包含任务完成度、交互效果和生成质量三维度,结果显示韩语表现最弱,GPT Live 1 任务完成和生成质量最高,Grok Voice Think Fast 2.0 交互最佳但生成质量低。
Google Research 发布的 AI 模型在 JAMA Network Open 上验证,其通过盲扫超声技术评估孕期周数(gestational age)的准确性。
Microsoft 研究者与协作者结合新数学思想与人类指导 AI 证明高维几何与概率的核心问题 KLS 猜想,该猜想提出 31 年,被广泛视为该领域中心未解问题。AI 工具探索候选方法并执行详细推导,研究者评估、修剪并重新定向搜索,最终证明高维空间几何原则,使障碍随维度增加不再无界增长。独立研究者确认该成果,识别出关键标准,并完成机器检查的正式验证。
Qwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。
Wiz Research利用前沿AI模型发现PHP多个严重内存安全漏洞,允许未认证攻击者远程执行代码或泄露内存敏感数据,影响PHP 5.4至最新版本;该漏洞利用链需复杂步骤,AI大幅降低其实现难度,被视为软件史上最严重漏洞之一,PHP团队已发布修复补丁。
RFD4-Proteina 可设计八肽蛋白质序列,组合数超 25 亿种;100 肽序列可能性超可观测宇宙原子数,其中存在可开发新疗法的蛋白质;该模型通过奖励引导推理时搜索解决蛋白质设计这一搜索问题。
NVIDIA OpenShell Reference Architecture 通过定义安全边界和治理策略,在规模化中保障 AI 智能体工作负载的安全。该架构支持智能体在执行复杂任务时访问文件、工具和互联网,并能动态协作。架构通过强化访问控制、审计日志和权限管理,降低智能体长时间运行带来的风险。
生数科技Motubrain团队开启2.0训练全流程直播,持续半个月展示具身模型训练过程。直播涵盖预训练、后训练、Agent任务执行和RSI探索四个环节,向公众开放模型从训练到能力迭代的过程。此举旨在提升Physical AI研发透明度,分享规模化训练、跨任务泛化等研究经验。
NVIDIA Omniverse DSX Blueprint 通过将厂区平面图、设备资产和工程需求整合为统一模型,支持团队进行审查、修订和模拟;其智能体辅助工作流可连接这些输入,帮助团队探索设计替代方案并融入工程反馈;该平台已开源,支持 8k 上下文长度,通过 API 提供可用性。
Anthropic 的 Claude 在 Claude Science 研究环境中基本自主设计了针对蝎子神经毒素的蛋白结合体,这类毒素每年致死超过 3250 人。
推荐理由: Claude 自主生成 31 万余个蛋白结合体设计,实验室验证 211 个中 17 个达标,给出了 AI 设计蛋白的实际命中率。
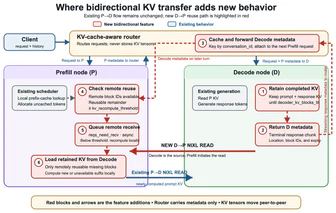
vLLM 的双向 KV 传输机制通过让解码节点在后续对话回合中返回先前计算的 KV 缓存给预填充节点,减少了重复计算,在 AWS EC2 P5en 实例上的多轮基准测试中将 Qwen3-32B 的 TTFT 提升了 1.6 倍,zai-org/GLM-5-FP8 提升了 3.3 倍。该功能通过扩展 NIXL KV 连接器实现,并利用 KV 缓存感知路由器协调跨对话回合的 KV 重用。