The Decoder6565
Runway 开源机器人控制模型 Praxis-1
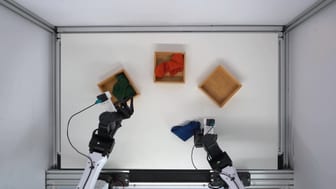
Runway 发布开源机器人控制模型 Praxis-1,该模型通过视频学习控制机器人,在自家测试中表现优异,Nvidia RoboLab-120 评测得分46.2%,领先同类模型。模型需额外训练适配新机器人系统,标准版需80GB内存GPU,已上线Hugging Face。
The Decoder6565Runway 发布开源机器人控制模型 Praxis-1,该模型通过视频学习控制机器人,在自家测试中表现优异,Nvidia RoboLab-120 评测得分46.2%,领先同类模型。模型需额外训练适配新机器人系统,标准版需80GB内存GPU,已上线Hugging Face。
 MarkTechPost
Elo排名显示Alibaba Wan 3.0(1175 T2V Elo)居首,每秒价格0.20美元;Utopai X(1170 T2V Elo)并列第二但无API;MiniMax H3(1161 T2V Elo)为首个开源视频模型,每秒0.08美元,但受地域限制。排名依据盲测人类偏好,结合每秒API价格与权重许可状态。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布 Duo 1.2 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含改进的生成质量,模型权重可在 Hugging Face 下载。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo-1.0-distill,一个用于实时音视频交互的全双工多模态世界模型,包含四步蒸馏的 Realization 权重,需与 causal-base 套件叠加使用。
 Hugging Face Daily Papers6565
PhysLoop 利用大语言模型指导视频生成、选择和修正,实现物理一致的自我改进和可控数据构建。该框架通过识别和纠正生成视频中的物理错误,推动视频生成模型有限人工干预下的递归自我改进(RSI),并发布包含 100K 视频的多样性数据集及生成工具。
Hugging Face Daily PapersBirdDreams 联合生成视角视频和鸟瞰视频(BEV),使场景布局成为预测未来的部分,通过 BEV 提供车辆位置和运动的俯视图,减少遮挡,而视角视频保留场景细节。在 PhysicalAI-AV 和 nuScenes 上,BirdDreams 比先前的驾驶世界模型更忠实地遵循输入的自身轨迹,并生成更合理的自身运动,无需 HD 地图或车辆状态输入。
The Decoder同一件事 · 2 家Anthropic 发布 Claude Meetings 功能,允许 Claude 以可见参与者身份加入视频会议,可回答问题、生成文档和白板、记录笔记和行动项,默认以文本形式响应并经授权可访问连接工具,会议结束后所有笔记、文本记录和文档均在 claude.ai 专属页面上传,隐私控制默认阻止 Claude 加入含外部参与者的会议。
 Claude · YouTube同一件事 · 2 家
Claude Meetings 开始在 Team 和 Enterprise 计划的 Google Meet 上以 Beta 版形式推出,AI 智能体作为可见参与者加入视频会议,在交谈中实时构建文档、白板等内容,并自动记录笔记和行动项,所有生成内容会保存在会议页面。其他视频会议平台支持即将到来。
 IT之家 · AI6565
荣耀 700 系列手机全系配备 1.5K 分辨率、3840Hz 零风险调光的新一代绿洲护眼屏,搭载全链路干眼守护方案;首发旗舰同款长焦增距镜,提供 5000 万像素电影感潜望长焦支持 3.5 倍光学变焦;打造“4K 电影感 Live 照片”功能,支持 1500+ 种定制化护眼建议。
IT之家 · AI同一件事 · 2 家Adobe 公布四项 AI 实验项目:Project Screen Test 通过对话设计 AI 角色;Project Sight Span 将照片转为可探索 3D 场景;Project Sound Bender 实现视频音效自由调整;Project Rinse Repeat 自动复制编辑操作。
 The Verge · AI同一件事 · 2 家
Adobe 推出实验性 AI 工具 Project Screen Test,通过对话设计 AI 角色并生成试镜动画;Project Sight Span 将照片转为可探索的 3D 环境;Project Sound Bender 允许用户像调色轮一样定制音效;Project Rinse Repeat 可复制编辑自动应用于同图其他对象
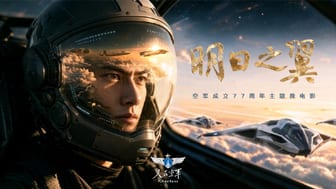
IT之家 · AI3535AI微电影《明日之翼》正式播出,采用实拍与AIGC深度融合制作方式呈现未来空战装备集群,包括统筹指挥无人僚机编组作战的“惊鸿”、发射兆瓦级激光光束的“烛龙”、集群出击的“玄蜂”,以及空天母舰、等离子护盾。
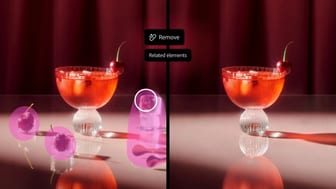
IT之家 · AIAdobe 在 Photoshop 中推出“重新调光”工具,可添加并调整光源位置、颜色和亮度,且修改不破坏原图;升级后的“移除”工具能清除物体留下的阴影、倒影、足迹和波纹,并重建背景。
 Ars Technica · AI6565
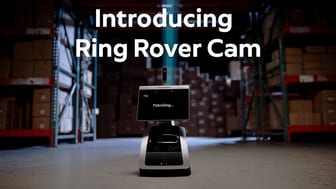
亚马逊推出 Ring 飞行无人机和 Ring Rover Cam 机器人,分别提供 148 度视场和 360 度旋转的 2K 视频功能,无人机续航 8 分钟,机器人售价 1000 美元,支持 4K 录播和云存储 180 天,两者均通过 Alexa Home Map 控制,但无人机在反光表面性能下降,机器人仅限单层室内使用。
The Verge · AIAdobe 在其 Max 事件中宣布为 Premiere、Photoshop 和 Lightroom 增加了新的自动移除对象、瑕疵和其他不需要的干扰的功能,同时推出了新的生成式 AI 工具和跨 Adobe 应用的协作体验。
 量子位
Fable 5.2 在智能体编程、软件工程测试等能力上全面超越 Opus 5.5,支持 100 万 Token 上下文,输出速度提升 30%,价格降 20%,API 每百万输入输出 Token 分别为 8 美元和 40 美元;网友实测可制作 3D 游戏、视频、交互体验,甚至从达·芬奇手稿生成 3D 模型,但高推理档位下 Token 消耗显著增加。
 AWS Machine Learning Blog5858
NVIDIA Nemotron 3.5 Super VL 已在 Amazon SageMaker JumpStart 中可用,支持图像、视频和文本输入生成文本。
IT之家 · AI6565大疆 Osmo Pocket 4P 固件更新至 V01.02.11.49,新增 18 倍变焦(不支持慢动作、延时摄影)、舞台与日落场景预设、iPhone 即拍即传(支持 iOS 26.4.1 及以上)及 LivePhoto AI 生成功能。
IT之家 · AI6565微软提交专利申请,利用AI近乎实时修改直播内容并同步嘴型,可替换口头填充词、口吃、冒犯性词汇等,支持实时翻译,延迟1至10秒,潜在应用场景包括讲座、体育赛事直播等,目前仅专利申请,技术尚未获授权。
 36氪 · AI精选同一件事 · 6 家7070
谷歌推出 AI 视频生成模型 Gemini Omni 1.2 Flash,原生支持最长 15 秒视频,时长上限较上一代的 10 秒提高 50%,用户可在 3 秒至 15 秒之间按 1 秒为单位设定生成时长。
量子位即梦短剧工作室提供从剧本到分镜的完整创作流程,支持一句话灵感或已有剧本创作,生成10集大纲及前三集剧本正文,角色动作神情标注清晰。Seedance 2.5单秒低至0.15元,支持智能预演和三维场景验证,机构伙伴计划提供IP对接和宣发支持,个人会员年包低至4.5折。
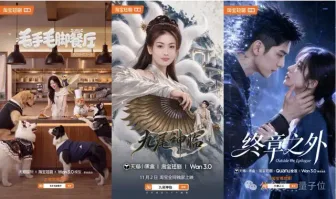
量子位阿里新一代视频生成模型 Wan3.0 通过一致性、真实质感、风格驾驭和视频编辑能力,在淘宝短剧《九尾神临》《毛手毛脚餐厅》《终章之外》中实现人物、商品与空间关系的稳定还原,助力品牌植入并推动交易转化,展现 AI 视频模型在电商领域的商业价值。
IT之家 · AI尼康 Z70 相机搭载 4,100 万像素非堆叠式传感器、EXPEED 7 图像处理器,支持 8K 60p 视频录制,具备 120fps 取景刷新率,电子取景器分辨率达 576 万点,可能内置 RED 相关技术支持 Apple ProRes RAW 录制,机身顶部新增 REC 录制按钮。
MarkTechPost精选同一件事 · 6 家7272Google 发布视频生成与编辑模型 Gemini Omni 1.2 Flash,原生支持最长 15 秒片段,720p 视频定价为每秒 0.07 美元,比 Omni 1.1 Flash 降低约 30%
IT之家 · AIAMD 下一代移动 APU Medusa Point 在联想测试系统中跑出 Geekbench 7 单核 1560 分、多核 11575 分,配备 10 核 20 线程(4 Zen 6 性能核+6 Zen 6c 能效核),16MB 三级缓存,支持 AVX-512 等指令集。
36氪 · AI精选同一件事 · 6 家8484谷歌于当地时间11月5日推出视频生成模型Gemini Omni 1.2 Flash,并在Gemini API和Gemini for Business中全面开放。该模型引入原生15秒视频创作、多轮对话式编辑和增强的参考遵循能力,价格较Gemini Omni 1.1下调30%,720p分辨率下为每秒0.07美元。
IT之家 · AI精选同一件事 · 6 家9494谷歌推出 Gemini Omni 1.2 Flash 视频生成模型,并在 Gemini API 与 Gemini for business 平台开放使用。新版原生支持最长 15 秒视频,可在 3 到 15 秒区间按 1 秒自定义时长,720p 生成价格为每秒 0.07 美元,较 1.1 版本降价 30%。
 TechCrunch · AI6565
Meta 宣布其消费者 AI 代理 Muse 的语音和视频聊天功能 Muse Realtime Avatar 和 Muse Realtime Voice 现已面向美国所有用户开放,用户可通过与可爱的动画头像 Jolly 互动进行实时对话,该头像可根据用户喜好定制,并使用与对话情绪匹配的细微表情和手势。
 Hugging Face Blog精选7171
NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
The Decoder精选同一件事 · 6 家9292Google DeepMind 将 Gemini Omni 1.2 Flash 视频生成模型开放通用,片段时长从最长 10 秒延长到 3 至 15 秒,720p 视频价格降至每秒 0.07 美元、比前代低 30%。
 Google AI Blog精选同一件事 · 6 家7878
Google 发布 Gemini Omni 1.2 Flash,并通过 Gemini API 和 Gemini for business 正式开放。原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,可按 1 秒步长指定 3 至 15 秒,720p 价格降至每秒 0.07 美元,比 1.1 下降 30%。
 Google DeepMind精选同一件事 · 6 家7878
Google DeepMind 发布了 Gemini Omni 1.2 Flash,原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,并已在 Gemini API 和 Gemini for business 全面开放。
推荐理由: 原文列出了时长、价格和参考一致性的具体变化,读者可据此判断视频生成的成本与工作流会怎样变化。
Hugging Face Daily Papers6565EmoReward 通过从实际训练运行中收集的奖励轨迹中提取证据可靠性,自适应地指导多奖励权重分配,以校准情感视频生成的奖励权重。该机制首先根据情感提示规划特定的接地线索进行评估,然后使用异构信号原语在生成阶段对视频进行评分,并通过反射奖励门控对它们的贡献进行校准。
IT之家 · AI6565Rollme 推出 AuraCam 头戴式耳机,配备 800 万像素摄像头和电子防抖,支持 OpenAI 图像识别与实时翻译功能,售价 89.99 美元。耳机具备会议录音、拍照录像功能,通过按钮同步至手机 App,支持蓝牙 5.4 和 Wi-Fi 6,续航最长 50 小时。
Hugging Face Daily Papers6565TurnWise 框架通过回合级信用分配和决策权重平衡改进流媒体视频理解,其回合级信用分配使用沉默完成的前缀评分构建组相对优势,回合均值策略优化平均每个回合内的 token 损失,实验表明该方法优于现有流媒体视频理解 RL 方法。
IT之家 · AI5858小米 REDMI K100 手机新增 3D 运镜 AI 玩法,从相册选静态照片生成大角度 3D 运镜视频,镜头可环绕推拉倾斜且人物外观保持一致。该功能基于小米的视觉生成框架 WorldCast,通过解读画面深度结构将平面照片还原成三维场景并虚拟相机轨迹。小米称 WorldCast 是可控视觉生成方向的突破,将探索更复杂运镜形态及 4D 视频生成技术。
IT之家 · AI6565小米智能摄像机 4 Pro 首发价 329 元,今日京东政府补贴后降至 252 元,新增实体通话按键支持一键微信通话,可在摄像机与手机微信、米家 App 之间实现双向通话。
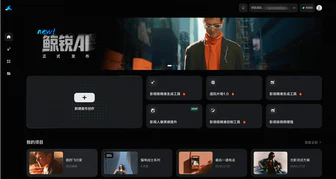
量子位5858虎鲸文娱集团打造的行业首个AI影视制作与管理平台“鲸锐AI”正式上线,集成50余个主流AI视频生成模型与10余个自研模型,通过精准控制和流程优化,AI视频单分钟成本较传统方式节省30%以上。平台官网(www.jingruiai.cn)开放全员注册,团队席位不限人数,无需订阅会员。
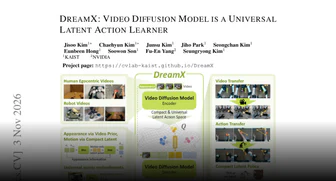
Hugging Face Daily Papers3838DreamX利用预训练视频扩散模型学习紧凑、外观不变的潜在动作,实现跨主体迁移和高效策略学习。DreamX从视频模型丰富的时空特征中提取潜在动作,将每帧压缩300倍(1200→4 tokens)。
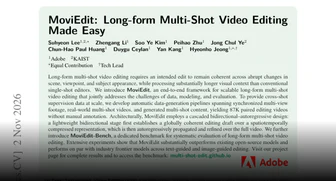
Hugging Face Daily Papers6565MoviEdit 框架通过级联双向自回归建模和新的基准测试,在减少人工数据标注的同时保持跨场景的连贯性,大幅优于现有开源模型,性能与行业前沿模型相当。该框架自动生成 87K 对配对编辑视频用于跨镜头监督,采用轻量级双向阶段建立全局编辑草稿,再进行自回归传播和细化。