IT之家 · AI
阿里全新一代千问大模型 Qwen4 即将发布,预览版已上线。
阿里巴巴发布全新一代千问大模型 Qwen4,预览版 Qwen4-Max 已上线阿里 Token Plan 限时 1 折体验,千问办公等应用已接入新模型。
IT之家 · AI阿里巴巴发布全新一代千问大模型 Qwen4,预览版 Qwen4-Max 已上线阿里 Token Plan 限时 1 折体验,千问办公等应用已接入新模型。
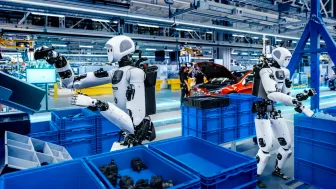
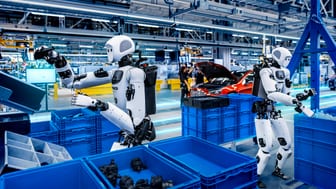
IT之家 · AI同一件事 · 3 家谷歌推出 VLA 机器人模型 Gemini Robotics 2.5,灵巧度、可靠性、安全性实现跃升,在奔驰生产线上成功率达 96%。该模型测试任务达 200 项,成功率较基线高出 30%-100%,速度提升 20%-30%,适配 Apptronik Apollo 2 等机器人,并采用 ASIMOV-Jailbreak 基准提升越狱抵御率至 99.5%。
IT之家 · AI同一件事 · 9 家谷歌发布了 Gemini 4 Carbon 模型,这是其目前能力最强的推理模型。该模型拥有 1,048,576 个 Token 的统一上下文窗口,标准同步请求最大输出 65,536 个 Token,通过 Long Decode 机制可扩展至 1,048,576 个 Token。
 The Decoder同一件事 · 9 家
Google 发布 Gemini 4 Carbon 模型,在 Artificial Analysis 测试中低于 Fable 5.2 的推理强度表现更优,与 Gemini 4 Argon 互补而非替代,后者更适合多数软件工程任务。
The Decoder同一件事 · 3 家Gemini Robotics 2.5 在梅赛德斯-奔驰装配线试点中成功率达 96%,处理金属零件分拣任务;相比前代模型,任务成功率提高 30-100%,速度提升 20-30%。该模型为视觉语言行动模型(VLA),支持 Apptronik Apollo 2 人形机器人及 Franka Duo 平台,并采用实时控制避免物理危险,安全任务完成率提升 33%(近障碍物)和 43%(近人员)。
 MiniMax News精选同一件事 · 2 家8080
MiniMax 发布了基于 H3 的开源权重图像生成模型 H3-Image,支持文生图、参考图生成和图像编辑,可在 10 秒内生成 4096 × 4096 的 4K 图像,最多支持 16 张参考图。
推荐理由: 官方给出 4K 生成速度、参考图数量和定价区间,可据此判断开源图像模型与闭源方案的差距。
 Google DeepMind精选同一件事 · 9 家8787
Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
 The Verge · AI精选同一件事 · 9 家8585
谷歌将Gemini 4 Carbon从面向少数网络安全防御者的限量开放扩展至所有付费开发者和企业,并称其为自家最强模型。
 MarkTechPost
Zyphra 发布了 ZONOS3-Mini,一款 800M 总参数、100M 活跃参数的开源语音合成模型,支持实时本地部署和零样本语音克隆。该模型在 Zyphra 自研 ZTTS2-Eval 基准测试中排名开放模型第一(66.2 分),单 H100 GPU 上生成首个音频耗时 80 毫秒,但参考音频克隆效果远低于嵌入模式。
Google DeepMind精选同一件事 · 3 家7676谷歌 DeepMind 发布了 Gemini Robotics 2.5,称其为目前能力最强的视觉-语言-动作(VLA)模型,在 200 项任务上相比此前基线成功率提升 30% 至 100%,完成任务速度快 20% 至 30%。
推荐理由: 官方披露了 200 项任务评测与奔驰产线 96% 成功率的实测数据,可据此判断 VLA 模型在真实工业场景的落地程度。
 Amazon Science
Mitra-v2 在 TabArena 基准测试中领先单模型领域,在 33 个数据集上优于 Mitra-v1,并在 ScoringBench 排名第一。
MarkTechPost精选同一件事 · 8 家8282Anthropic发布Claude Fable 5.2和Claude Mythos 5.2,两者基于同一个底层模型,Fable 5.2增加了分类器拦截高风险网络安全任务和大部分生物学研究任务,Mythos 5.2去掉了这些限制,需要通过Cyber Verification Program和Life Sciences Verification Program访问。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 404 Media
Anthropic 的 Claude 和 OpenAI 的 Codex 用户因进行逆向工程操作,如修复物联网设备或移除智能电视广告,正遭遇账户限制或功能限制;OpenAI 工程师 Tarun Gogineni 称这些限制多为意外,但用户正转向使用开源或本地模型以规避此类限制,反映出大型 AI 公司在用户利用 LLM 绕过硬件制造商限制时,倾向于保护自身及合作伙伴利益。
The Decoder同一件事 · 8 家Anthropic 的 Fable 5.2 完成 41.3% 的真实自由职业任务,较去年增长 38.5%。该模型在 3D 模型、音频编辑和建筑设计等领域表现突出,成功完成近 50 项此前 AI 未能解决的复杂项目。其直接前代 Fable 5.1 仅完成 17.8%,而 Opus 5.5 和 GPT 6 Astra 分别以 21.25% 和 20.83% 位列其后。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Meta 推出 Muse Ember,其最小且最高效的模型,专为复杂推理执行设计,在智能与成本比上优于 Claude Haiku 5.5 和 GPT-6 Luna,每百万输入 token 成本 0.10 美元,每百万输出 token 成本 0.50 美元,支持 1M 上下文窗口和 512K 输出 token。
 量子位
Fable 5.2 在智能体编程、软件工程测试等能力上全面超越 Opus 5.5,支持 100 万 Token 上下文,输出速度提升 30%,价格降 20%,API 每百万输入输出 Token 分别为 8 美元和 40 美元;网友实测可制作 3D 游戏、视频、交互体验,甚至从达·芬奇手稿生成 3D 模型,但高推理档位下 Token 消耗显著增加。
 Simon Willison
Meta AI 发布 Muse Ember 模型,其设计用于复杂推理执行和智能体日常任务如工具调用、编码子任务、路由、提取及长文档解析。
MarkTechPost同一件事 · 4 家Meta 发布 Muse Ember,其最小且最高效的模型,专为智能体中的重复步骤设计。Muse Ember 在 AA 智能指数上得分 36,与 Claude Haiku 5.5(最大努力)持平,每项任务成本约 0.14 美元。
量子位Seedream 5.5 在连续编辑 100 轮图像的高压任务中表现优于 GPT-Image 2.6,展现出更强的稳定性。该模型提升了真实感,支持小字与多语言渲染、透明图生成与编辑,以及图层拆分与文字二次编辑功能。此外,Seedream 5.5 的 API 价格降至单张 0.28 元,速度提升,延续“输入图 + 输出图”两段计费结构,无文本 Token 费用。
IT之家 · AI同一件事 · 8 家Anthropic 发布了 Claude Fable 5.2 模型,编程能力在 FrontierCode 2.0 测试中达到 49.1%,超过 GPT-6 Astra 的 42.8%;在 Humanity's Last Exam 测试中得 74.2%,领先 GPT-6 Astra 的 57.2%。该模型输出速度最高提升 30%,成本下降 20%,API 调用费降至 $3/百万 tokens。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude Fable 5.2 在 Artificial Analysis 评测中获得 65 分,是目前最高分;该模型在 Intelligence Updated Capability Indexes 评测中表现优异。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
IT之家 · AI同一件事 · 4 家Muse Ember 是 Meta 最小、效率最高的 AI 模型,在 Artificial Analysis 排行榜中表现媲美 Claude Haiku 5.5,但单任务成本仅为 1/3 并超越 GPT-6 Luna。
 36氪 · AI同一件事 · 8 家
Anthropic 发布 Fable 5.2 和 Mythos 5.2 模型,Fable 5.2 可处理更复杂软件工程任务并协调超 1000 个 AI 智能体,价格更低;Mythos 5.2 在网络安全和生命科学领域防护措施减少,将通过验证计划向机构推广,两款模型均比旧版更快。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
IT之家 · AI同一件事 · 8 家Anthropic 推出 Claude Fable 5.2 和 Claude Mythos 5.2 模型,后者面向专业机构。Fable 5.2 每百万词元输入/输出费用分别为 8/40 美元,较 5.1 下降 20%。生成速度最高提升 30%,可选快速模式 2.5 倍速但价格更高。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
The Verge · AI同一件事 · 8 家Anthropic 发布新 Claude Fable 5.2 和 Claude Mythos 5.2 模型,声称在编码、推理和视觉方面改进,输出速度比 5.1 版本快。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
The Decoder同一件事 · 8 家Anthropic发布的Claude Fable 5.2和Mythos 5.2在多个基准测试中超越竞争对手,包括在Artificial Analysis Index v5高计算层级中以65分领先GPT-6和Gemini 4 Carbon。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Hugging Face Daily Papers
Confucius4-R2T2 是一个用于实时应用的稳定前缀流式语音识别模型,通过后训练将全上下文 ASR 模型转换为流式模型,无需架构修改。基于 Qwen3-ASR-1.7B 构建,R2T2 实现了近离线识别精度和低发射延迟,支持可配置的流式块大小,并展现出有前景的跨语言泛化能力。该模型和实现已公开发布。
 Google Developers Blog5858
Google Cloud 发布 MaxText v0.2.4,支持在 TPU 上进行长上下文训练,通过 MaxText Context Parallelism 技术,在 TPU 5p 上使 Llama 3.1 8B 模型达到 4 百万 token 长度的序列 70% 的 MFU,在 TPU 5p 和 TPU 7 上可无缝扩展至 14 百万 token
The Decoder同一件事 · 2 家Meta 发布 Muse Ember,其迄今为止最小且最高效的 AI 模型,专为处理 AI 代理日常的重复性任务设计,如调用工具、处理小规模编码任务、路由请求、提取数据和处理长文档。
 Claude · YouTube精选同一件事 · 8 家7575
Anthropic 发布 Claude Fable 5.2,称其在编码、推理和视觉方面有所改进,面向最复杂、开放式的技术工作。官方建议多数编码和知识任务从 Opus 5.5 起步,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude · YouTube精选6868Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Claude · YouTube精选同一件事 · 8 家7575Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
 TechCrunch · AI精选同一件事 · 8 家8282
Anthropic发布Mythos 5.2和Fable 5.2,称新模型在编码、推理和视觉方面有所提升,与用户沟通更清晰。Fable的输入价格从每百万token 10美元降至8美元,低于主要竞争对手GPT-6 Astra,响应速度提升30%,并可通过Enterprise Frontier Safeguards支持零数据保留(ZDR)政策。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
The Decoder精选7171字节跳动 Seed 推出面向专业生产工作流的图像生成模型 Seedream 5.5,称其支持最多 100 轮多轮编辑,未改动区域在像素级保持一致且不出现偏色。该模型可原生生成带透明背景的 RGBA 图像,无需手动抠图即可作为设计素材使用,并称在光照、材质、皮肤质感和密集小文字还原上更准确。Seedream 5.5 正通过即梦、豆包、豆包 Work 和火山引擎方舟逐步开放,Pro 版本已在计划中。
推荐理由: 原文列出多轮编辑稳定性、原生 RGBA 输出和文字渲染三项能力,可据此判断它在设计生产流程中的位置。
 Artificial Analysis Articles同一件事 · 4 家6666
Muse Ember 得分 36,与 Claude Haiku 5.5 相当但任务成本仅为 0.14 美元,较后者低三分之二;其输入输出 token 价格与 Claude Haiku 5.5 和 GPT-6 Luna 相同,但缓存输入成本更低。在 AutomationBench-AA 上得分 68.1%,与 Muse Wonder 相当,但在知识准确率上最低(21.1%)
TechCrunch · AI精选同一件事 · 2 家7272Meta Superintelligence Lab 发布轻量模型 Muse Ember,输入价格为每百万 token 10 美分,主打工具调用、编码子任务、路由、抽取和长文档解析等智能体高频工作。
推荐理由: Meta 用每百万输入 token 10 美分的定价和 Artificial Analysis 综合基准,把轻量模型放进智能体执行环节与 Haiku、Luna 比较。
MarkTechPost6767百度发布 ERNIE Evolve 自动化研究系统,通过给定代码库、目标和评估标准自动选择研究方向、编辑代码并运行实验,仅保留通过隐藏评估器和独立审查者验证的更改。
IT之家 · AI精选同一件事 · 2 家8282美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。
推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。
量子位精选8282腾讯混元Hy4正式发布,770B总参数、49B激活参数,首次引入原生视觉能力和电脑操作支持,指令遵循、长文理解与长程Agent能力同步升级。模型已在腾讯云TokenHub、WorkBuddy/CodeBuddy、元宝等产品上线,API接入OpenRouter、Hermes、OpenCode等平台,权重将于近期开源。
推荐理由: 作者用多个长程任务实测混元Hy4的自主执行与自检能力,可据此判断开源模型在Agent交付上的实际水平。
IT之家 · AI5252Shizuku AI 发布全双工模型 Shizuku-Duplex,支持日语智能对话且无需完整询问即启动思考流程。该模型在日语对话自然性方面表现最佳,响应质量仅次于 GPT-Live,采用前台交互与后台异步处理结合架构,支持音频、文本、动作三种输出方式。