Edge0 开源 145B 与 120B 端侧模型及推理框架。
Edge0 开源 Edge0-145B 和 Edge0-120B 两个端侧模型,并同时发布统一推理框架与部署工具。官方称 145B 模型可在兼容笔记本上本地运行,峰值内存 29GB、解码速度 80+ tokens/s、预填充 1100+ tokens/s,支持 128K–256K 上下文。
推荐理由: 原文给出端侧 145B 模型的实测内存、速度与多项基准对比,可据此判断本地运行前沿级模型的现实边界。

今天最值得读的 AI 新闻,来自正在塑造 AI 的实验室、创业公司和研究者。
Edge0 开源 Edge0-145B 和 Edge0-120B 两个端侧模型,并同时发布统一推理框架与部署工具。官方称 145B 模型可在兼容笔记本上本地运行,峰值内存 29GB、解码速度 80+ tokens/s、预填充 1100+ tokens/s,支持 128K–256K 上下文。
推荐理由: 原文给出端侧 145B 模型的实测内存、速度与多项基准对比,可据此判断本地运行前沿级模型的现实边界。
IBM 在 Hugging Face 发布 LLMON(LLM 对象符号)标记语言,并推出基于 Granite 4.1 的 granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview 两个实验性预览模型,同时开源 GitHub 工具包。
推荐理由: 原文给出 LLMON 标记语言的设计动机与两个预览模型,读者可据此理解指令与数据分离如何降低间接提示注入风险。
Google 发布 Gemini 4 Hydrogen 模型,称其能更好地回答包含多个部分、拼写错误或高度具体需求的复杂问题,并会拆解问题逐项回应。
推荐理由: 原文列出了 Gemini 4 Hydrogen 在搜索与 Gemini 应用中的默认位置和可用入口,读者可据此判断它对现有搜索问答流程的影响。
Google DeepMind 发布 Gemini 4 Hydrogen,面向日常编码与智能体工作流,在默认 high 思考档位下 Artificial Analysis 智能指数为 51,高于 Argon 的 50,xhigh 档位可达 54
推荐理由: 官方给出Hydrogen与Carbon、Argon的分工定位,以及多模型编排在成本与速度上的实测差异。
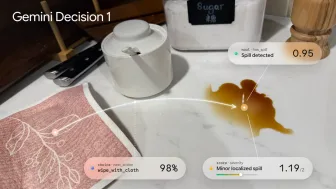
Google DeepMind 推出 Gemini Decisions API,面向是/否、多选和量表评分等封闭式判断,底层模型 Gemini Decision 1 单次可处理最多 1000 个独立问题,覆盖文本、图像、音频、视频和 PDF。
推荐理由: Gemini Decision 1 把封闭式判断做成独立 API,并给出延迟、价格与基准表现,便于对照近期同类决策模型。
Google DeepMind 发布 AlphaGenome 2,这是一个条件化 DNA 序列模型,可针对特定细胞类型或状态预测 DNA 变异对基因表达的影响。
推荐理由: 官方披露了条件化架构改造与单细胞层面的评测对比,可了解该模型如何把变异效应定位到具体细胞类型。
MiniMax 发布了基于 H3 的开源权重图像生成模型 H3-Image,支持文生图、参考图生成和图像编辑,可在 10 秒内生成 4096 × 4096 的 4K 图像,最多支持 16 张参考图。
推荐理由: 官方给出 4K 生成速度、参考图数量和定价区间,可据此判断开源图像模型与闭源方案的差距。
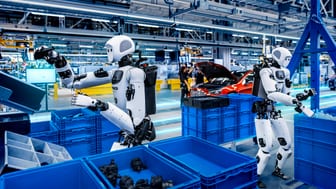
谷歌 DeepMind 发布了 Gemini Robotics 2.5,称其为目前能力最强的视觉-语言-动作(VLA)模型,在 200 项任务上相比此前基线成功率提升 30% 至 100%,完成任务速度快 20% 至 30%。
推荐理由: 官方披露了 200 项任务评测与奔驰产线 96% 成功率的实测数据,可据此判断 VLA 模型在真实工业场景的落地程度。
谷歌 DeepMind 发布 AlphaProof Code,一款符合安全规范的 AI 数学证明软件,并在四周内完成了通常需要数年才能在 Signal 加密协议上完成的验证工作。
推荐理由: AlphaProof Code 将形式化验证从理论设计推进到实际运行代码,四周完成通常需数年的工作,并给出人工复核比例。
Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
字节跳动 Seed 推出面向专业生产工作流的图像生成模型 Seedream 5.5,称其支持最多 100 轮多轮编辑,未改动区域在像素级保持一致且不出现偏色。该模型可原生生成带透明背景的 RGBA 图像,无需手动抠图即可作为设计素材使用,并称在光照、材质、皮肤质感和密集小文字还原上更准确。Seedream 5.5 正通过即梦、豆包、豆包 Work 和火山引擎方舟逐步开放,Pro 版本已在计划中。
推荐理由: 原文列出多轮编辑稳定性、原生 RGBA 输出和文字渲染三项能力,可据此判断它在设计生产流程中的位置。
Meta Superintelligence Lab 发布轻量模型 Muse Ember,输入价格为每百万 token 10 美分,主打工具调用、编码子任务、路由、抽取和长文档解析等智能体高频工作。
推荐理由: Meta 用每百万输入 token 10 美分的定价和 Artificial Analysis 综合基准,把轻量模型放进智能体执行环节与 Haiku、Luna 比较。
腾讯混元Hy4正式发布,770B总参数、49B激活参数,首次引入原生视觉能力和电脑操作支持,指令遵循、长文理解与长程Agent能力同步升级。模型已在腾讯云TokenHub、WorkBuddy/CodeBuddy、元宝等产品上线,API接入OpenRouter、Hermes、OpenCode等平台,权重将于近期开源。
推荐理由: 作者用多个长程任务实测混元Hy4的自主执行与自检能力,可据此判断开源模型在Agent交付上的实际水平。
360 自研 AI 安全攻防系统图龙锋在 CyberGym 榜单上以 99.4% 的漏洞复现成功率登顶,三轮独立评测成功率分别为 99.27%、99.47% 和 99.40%。
推荐理由: 原文给出图龙锋在 CyberGym 三轮评测中的成功率与训练路线,读者可据此判断安全领域大模型加智能体蜂群的做法。
Thinking Machines 发布第二代模型 Inkling 2 Small,采用 MoE 架构,总参数 594B、激活参数 17B,支持文本与图像输入并可调节思考深度。
推荐理由: 原文给出新模型在智能指数、智能体任务和成本上的具体对比,读者可据此判断开源权重模型的竞争位置。
蚂蚁百灵官方团队发布原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数和 1M 上下文窗口,支持图像、文本与视频输入。
推荐理由: 原文给出三项基准对比与 API 定价,读者可据此判断这款多模态模型的能力位置与调用成本。
NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
OpenAI 发布 GPT-6 Cyber,这是一款用于发现可利用漏洞并开发修复方案的网络安全模型,训练中要求其行为保持在授权范围内。
推荐理由: OpenAI 发布面向漏洞发现与修复的专用模型,并强调授权范围约束,可观察安全智能体的能力边界。
Google DeepMind 发布了 Gemini Omni 1.2 Flash,原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,并已在 Gemini API 和 Gemini for business 全面开放。
推荐理由: 原文列出了时长、价格和参考一致性的具体变化,读者可据此判断视频生成的成本与工作流会怎样变化。