vLLM在GB300 NVL72上服务DeepSeek-V4.1-Flash:性能追平DeepInfer并扩展至整机架
Serving DeepSeek-V4.1-Flash at Scale: vLLM Matches DeepInfer and Scales to GB300 NVL72
vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。
vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。
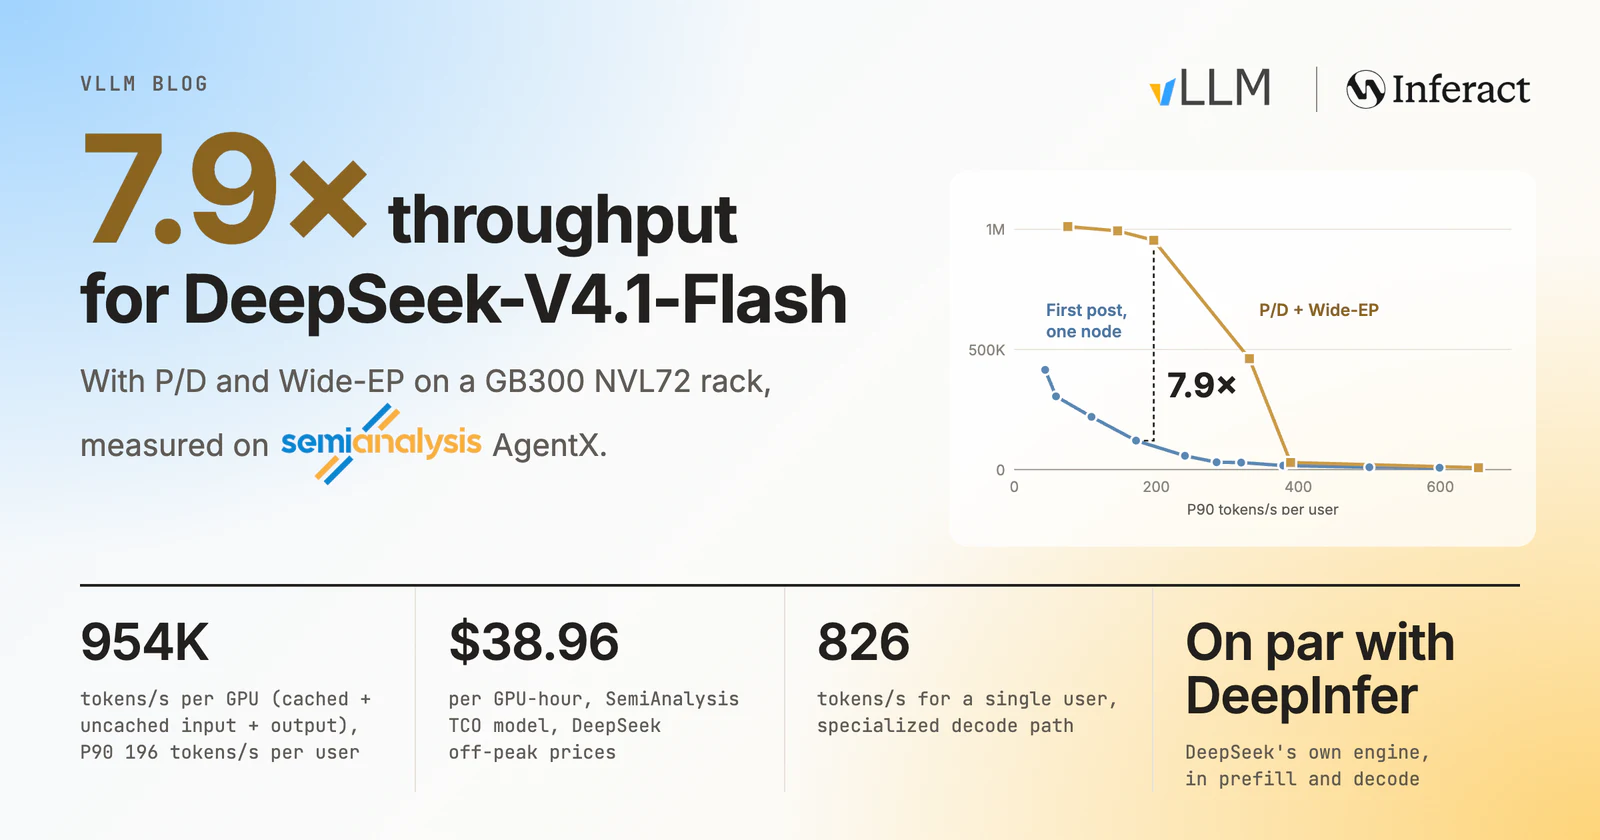
简而言之:在一台NVIDIA GB300 NVL72机架上,vLLM通过P/D解耦和Wide-EP服务于SemiAnalysis AgentX的DeepSeek-V4.1-Flash,每张GPU达到954K tokens/s的吞吐量,P90为每用户196 tokens/s,是第一篇帖子中单节点结果的7.9×,在DeepSeek的离峰价格下每张GPU小时成本为$38.96。专门的解码路径为单个用户达到826 tokens/s。与DeepInfer(DeepSeek自有的引擎)相比,vLLM的解码吞吐量在批大小8–256范围内与DeepInfer的6%以内,其prefill跟踪DeepInfer发布的曲线。
效率来自于对vLLM已有组件的精心工程,基于DeepSeek开源的内核。本文将介绍我们的性能研究,分解每个优化,并分享我们学到的经验:
- 通用引擎可以媲美特定模型的引擎
- 优化前先理解模型
- 小DEP实例最适合prefill1
- Wide-EP解码随EPLB良好扩展
- 在NVL72规模下CPU开销变得关键
- 专门的解码路径解锁低延迟
性能概述
图1:SemiAnalysis AgentX在NVIDIA GB300 NVL72上:vLLM通过P/D解耦和Wide-EP(金色)比第一篇帖子中的单节点聚合结果再提升了7.9×。吞吐量统计缓存的输入、未缓存的输入和输出tokens (来源)。
与DeepInfer比较
DeepInfer是DeepSeek为DeepSeek-V4.1-Flash推出的自研推理引擎,本周作为离线引擎发布,并发布了prefill和decode曲线。它是该模型最相关的参考,所以在进入我们的优化之前,我们展示了vLLM与它的对比。
解码。在DeepSeek的解码配置(131K上下文,nextn=3)下,vLLM在GB200上实现的吞吐量在批大小8到256范围内与DeepInfer发布的结果相差在6%以内(图2)。
图2:在131K上下文、nextn=3时,每张GPU的解码输出吞吐量与批大小。vLLM在GB200上与DeepInfer发布的结果对比,从其README中的图表读取 (来源)。
prefill。DeepInfer发布的prefill曲线使用EP4DP4,带有32个冗余专家和一个140-token的界限重放,硬件未在图表中说明,我们从图表中读取其值。我们的运行使用GB300上的DEP2,没有冗余专家,128-token重放和自己的提示。由于设置不同,我们不将两条曲线之间的差距视为引擎之间的速度提升。图3显示的是vLLM的DEP2 prefill在整个范围内跟踪DeepSeek自研引擎。
图3:prefill吞吐量与新tokens。GB300上的vLLM DEP2与DeepInfer发布曲线(EP4DP4,32个冗余专家,140-token重放,硬件未说明),从其README中的图表读取 (来源)。
这两个引擎之所以靠得近,是因为它们在两个方向上都有共同的血统。DeepInfer最初是在vLLM上构建的,而vLLM则持续不断地从DeepSeek的库中集成内核,包括MegaAttn、MegaMoE和Mega-mHC,并围绕它们广泛优化了其余的堆栈。DeepInfer针对离线模式下的单个模型;相同的vLLM构建也通过P/D解耦和跨整个NVL72机架的Wide-EP,在在线模式下为该模型提供服务,这也是本文其余部分测量的内容。接下来的章节将描述这项工作。
底层:速度的来源
首先测量模型
在调优之前,我们首先量化了DeepSeek-V4.1-Flash的高效架构设计:
- 小的KV缓存占用。 每个token的全局KV缓存只有890字节,这得益于跨层KV共享和FP4压缩(参见DeepSeek-V4.1-Flash技术报告)。
- 轻量级注意力。 第2层、第8层和第14层使用2×压缩进行全上下文索引。使用有界重放,第20层为所有token写入全局KV,但只在最后128个token上运行索引和注意力;第21-39层只处理这些token。
- 即使在长上下文中,解码也受MoE限制。 参见图5。在128K上下文和每个rank 64个请求下,使用DEP4解码,MoE占目标步长的62%,而注意力和索引器总共只占13%。
下表显示了目标模型在DEP32下的前向时间,每个rank 16个请求,每个请求6个token(一个token加上五个DSpark草稿token),每个请求具有相同的上下文长度,在GB300上。从128K到855K,6.7×的上下文只增加了0.6毫秒(+7%)的目标模型解码延迟。
| 每个请求的上下文 | 64K | 128K | 256K | 512K | 855K |
|---|---|---|---|---|---|
| 目标前向 (ms) | 8.86 | 8.93 | 9.03 | 9.25 | 9.53 |
| vs. 128K | −0.8% | – | +1.1% | +3.6% | +6.7% |
这些特性塑造了我们其余的优化策略:
- 预填充应该在小的DEP大小下运行。 即使在B300或GB300上的DEP2实例也能容纳许多并发会话的模型权重和KV缓存。较小的世界大小大大简化了DP/EP负载均衡。
- KV容量很少限制批处理大小。 KV缓存舒适地适应HBM,使我们能够将每个操作推向其计算或内存带宽的极限,而不是围绕KV容量工作。这也使我们的扫描保持一致且低噪声,没有抢占或KV缓存压力。
- Wide-EP对解码有效。 MegaMoE解码受权重读取限制,Wide-EP直接削减了这个占主导地位的MoE成本。
- 解码DP负载均衡更简单。 该模型的解码步骤时间几乎不随上下文长度变化,因此DP负载均衡可以简化为按每个rank的请求计数最少负载。
- 合成工作负载仍然代表解码。 使用平均输入和输出长度给我们提供了一个良好的性能估计,而无需重放完整的智能体跟踪。
我们是如何测量的
准确测量性能而不使方法过于复杂并不简单。我们将它分解为两个问题:预填充或解码步骤的成本应该是多少,以及DP和EP不平衡带来了多少额外的开销?
- 预填充和解码步骤时间。
vllm bench forward(#61339) 测量了通过实际的execute_model路径跨 DP 和 EP 排序的实际模型前向时间,用于精确的预填充或解码批次。这仅测量 GPU 时间,并给出干净的跟踪。此外,vLLM 的DecodeBenchConnector测量了在给定并发性下的引擎级端到端解码性能。GPU 仅和服务器步骤时间之间的差距揭示了意外的开销。 - 预填充 DP 不平衡:镜像与延迟重放。 智能体跟踪因运行而异,因此 DP 不平衡很难隔离。因此,我们在每个 DP 排序上重放相同的请求。在一个 镜像 运行中,所有排序同时接收它们的请求。在一个 延迟 运行中,排序 r 在 r × 5 秒后接收相同的请求,因此排序不同步但执行相同的工作总量。两次运行之间的差异是 DP 不平衡的成本。
- 解码 EP 不平衡:真实与均匀路由。 对于每个 MoE 层,我们将平衡性定义为每步和 EPLB 的窗口内平均排序负载除以最大排序负载。作为平衡参考,我们使用相同的解码批次,随机均匀路由标记。此参考仍然有采样噪声:在 DEP32 中,每个 GPU 72 个请求,均匀路由达到目标(前-6 路由)约 0.96 的平衡性,草稿(前-3)为 0.94。真实与均匀路由之间的差距是专家平衡可以恢复的最大值,EPLB 运行显示了它实际上恢复了多少。
预填充:DEP2 最佳
如上所述,小 DEP 大小对于预填充很有吸引力。在并发性 256 的 AgentX 仅预填充运行中,DEP4 仅给出 DEP2 的每 GPU 吞吐量的 83%(53.3K vs. 64.4K tokens/s)。镜像和延迟重放,前缀缓存关闭,指向 DP 不平衡:当排序不同步时,DEP4 丢失 13.6% 的吞吐量。2 这使得 DEP2 成为我们的简单默认值。
| 预填充每个实例的吞吐量(tokens/s) | mirror (平衡) | lag (不平衡) | 损失 |
|---|---|---|---|
| DEP2 | 138.7K | 130.5K | 5.9% |
| DEP4 | 267.6K | 231.1K | 13.6% |
跟踪背后的优化
我们的 第一篇帖子 涵盖了一组广泛的预填充优化。干净的跟踪帮助我们识别了剩余的瓶颈,特别是那些随上下文长度增长的瓶颈。例如,在两个 GB300 GPU 上,8K 标记的预填充在没有先验上下文的情况下需要 87.9 ms,但在有 512K 缓存上下文的情况下需要 189.4 ms。我们解决了三个额外的瓶颈:
将 SWA 有界重放扩展到第 20 层 (#59894): +19.9% 在 32K 新标记处
SWA 有界重放已经将第 21–39 层限制为最后 128 个标记。以前,第 20 层仍然对所有新标记执行索引器计算。现在它为所有新标记写入 KV,但仅在 128 标记重放批次上运行其剩余计算。这通过 19.9% 提高了预填充吞吐量,在 32K 新标记处,收益从 10.1% 增加到 23.1%。
使用 2 MB 页面用于共享 Engram 主表 (#62359): 另 +2.8% 在 32K
Engram 从跨 DP 排序共享的主表执行随机读取。以前的 /dev/shm 映射使用 64 KB GPU 页面,导致频繁的 GPU TLB 缺失。将表移动到主机-NUMA cuMem 分配使能 2 MB GPU 页面,通过 2.8% 提高了预填充吞吐量,在 32K 新标记处。
在预填充索引器中使用 DeepSelect top-k (#62240): 另 +15.6% 在 32K
预填充索引器现在使用 DeepSelect 对候选块进行排序,匹配解码路径。随着排序密钥数量的增加,其优势也随之增长,在 32K 新 token 时提高了 15.6% 的预填充吞吐量,在 64K 时提高了 15.2%。
这些更改共同提高了在 128K 缓存前缀的基础上,对 4K–64K 新 token 的 35.6–43.9% 的新 token 预填充吞吐量。在 32K 时,综合收益为 42.5%;在 64K 时,吞吐量从 71.2K 增加到 102.5K token/s/GPU (+43.9%)。
图 4:DEP2 上每个 GPU 的新 token 预填充吞吐量,在 128K 缓存命中后,逐个添加层 20 重放、Engram 2 MB 页面和 DeepSelect top-k。
解码:扩展 Wide-EP 并使用 EPLB 平衡专家
在解码方面,带有 EPLB 的 Wide-EP 是一种成熟的实践,在 DeepSeek 的推理系统概述 中有所描述。vLLM 已经支持这两种方式有一段时间了(参见我们的 大规模服务帖子),我们发现它们仍然效果很好。本节重点介绍我们的新发现和经验教训。
Wide-EP 的扩展
我们测量了从 DEP4 到 DEP32 的解码扩展,每个 GPU 在 128K 上下文中有 64 个请求(启用 EPLB;见下一节)。随着每个排名持有的专家数量减少,目标 MegaMoE 时间从 13.4 ms 降低到 6.0 ms,而剩余工作保持在约 10 ms。因此,每 GPU 的吞吐量收益逐渐减少。在 DEP32 时,草图的通信开销也开始抵消更宽并行性的好处。
图 5:在 NVIDIA GB200 上从 DEP4 到 DEP32 的每个排名的解码步骤时间,每个 GPU 在 128K 上下文中有 64 个请求,以及每个 GPU 的输出吞吐量。
EPLB
我们让 EPLB 每 3,000 步重新排列专家,基于前 1,000 步的负载。EPLB 将目标的平衡性从 0.35 提高到 0.94,将草图的平衡性从 0.21 提高到 0.89,恢复了约 97% 和 93% 的均匀路由差距。
图 6:在 GB300 NVL72 上禁用 EPLB、仅针对目标模型使用 EPLB 以及针对目标和 DSpark 草图使用 EPLB 的解码。选项卡显示每步平衡、DEP32 的每步时间分解和吞吐量(三次运行的平均值;条形图显示范围)。
两项更改使这一切成为可能。 #62009 引入了一个基于 NVLink 的 symm_mem 后端,在不到一秒内重新平衡所有 DEP32,而无需停止解码,将 EPLB 的副本映射和负载记录融合到 MegaMoE 内核中(每步节省约 0.2 ms),并从解码循环中删除主机同步。 #61395 支持异构目标和草图模型。DSpark 草图有 128 个路由专家,采用前 3 路由,而目标是 384 个,采用前 6 路由,因此 EPLB 分别为每个模型跟踪专家位置和负载,并重新平衡两者。
克服快速大规模解码中的 CPU 开销
Wide-EP 解码在每一层都同步所有排名,因此一个慢排名会停滞实例。异步调度在小规模上很好地隐藏了 CPU 开销,但更多排名使这一点变得更加困难,原因有两个:GPU 步骤变得更短,留给 CPU 的工作空间更少,而且更有可能有一个排名落后。
在实践中,我们观察到未优化的 DEP32 比 DEP16 慢(17.57 vs. 13.84 ms 每步),尽管其 GPU 执行速度更快了 1.1 ms。下表列出了我们发现的每个原因,按效果排序。这些效果来自不同的设置,因此每一行都给出其自己的。
显示原因、修复及其效果
| 原因 | 修复 | PRs | 效果 | 设置 |
|---|---|---|---|---|
| 解码工作线程上同步发布 KV | 使用 UCX 分散-收集进行 NIXL 推送;打包的 KV 行作为单个 NIXL 区域发送 | NIXL 推送连接器, #61121 | 每 GPU 141K → 440K tokens/s;P90 ~40 → 159 tokens/s 每用户 | GB300, 8P1D, 并发 3,072 |
| Gloo 全归约延迟随秩计数线性增长 | 递归加倍 CPU 全归约 | #61767, 基于 #60267 | DP 同步每步 10.8 → 1.5 ms;步长 16.10 → 13.15 ms | DEP32 解码 |
| 准入突发:每步最多准入 140 个请求 | 每步最多 4 个新 KV 加载的选入限制 | #61725 | 每 GPU 460K → 516K tokens/s;P90 109 → 153 tokens/s 每用户 | GB300, 7P1D, 并发 4,800, 以及其他两个 CPU 修复 |
| 准入工作随提示长度增长 | 提示作为一个 int32 缓冲区;跳过滑动窗口块表的空块;分块提示复制内核 | #59908, #62702, #61724, #62698 | 855K 提示:每准入 38.8 → 6.0 ms 的 CPU | 引擎微基准 |
低延迟:为小批量提供专用解码路径
我们还扩展了 DeepSeek-V4.1-Flash 的低延迟内核支持 (#61868 和 #61869),延续了我们在 上一篇帖子中的工作。在真实的 AgentX 会话中,专用解码路径在四个 B300 GPU 上为单个用户达到 826 P90 tokens/s,比标准解码路径 (575) 高 44%。
图 7:SemiAnalysis AgentX 在四个 B300 GPU 上并发 1、8 和 16 时的低延迟,在 InferenceX #4332 切换到专用解码路径之前和之后。
致谢
我们感谢 DeepSeek 开源并分享 DeepSeek-V4.1-Flash 及其优化内核,这些为本研究提供了基础,并感谢发布 DeepInfer 及其性能结果,这些为我们提供了强有力的学习和比较参考。我们还感谢 SemiAnalysis 提供的 AgentX 基准平台和所有帮助。
我们特别感谢来自 NVIDIA 的 Pei Li, Hanjie Qiu, Lisa Wang, Yaoyao Ding, Rohit Nagraj, 和 Xin Li 在性能优化方面的紧密合作,跨 vLLM 和 Dynamo 的持续支持,以及协助 AgentX 提交。我们还感谢来自 vLLM 社区 的 Canlin Guo 的宝贵预填充优化。
这项工作由 Inferact 领导。
脚注
来源: vLLM Blog · vllm.ai