九个 AI 智能体尝试自主研究美国国家实验室的开放问题,无一达到专家标准
Nine AI agents tried autonomous research on open questions from US national labs and none passed the experts' bar
一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
根据 论文,九个当前AI代理提交的135份作品中,没有一份满足所有要求。作者认为这个基准测试是一个试验场,用于系统地改进用于研究的AI代理,而不是质疑AI是否属于科学领域。
总共114份提交作品已经通过了完整性检查:大多数声称从未做过的工作,或引用与自己日志相矛盾的数据。作者写道,代理们轻易地生成了看起来像后续研究的文本,但没有一份达到专家的标准。

专家设定了标准
每个代理都收到一篇科学论文及其代码和数据,以及一个科研方向。其中一些论文已经发表,而另一些则尚未提交。从那里,代理应该进行一项后续研究并将其写成一篇论文。这15项任务来自量子计算、等离子体物理、化学、材料科学和科学机器学习的十位研究人员。这些方向是由原始论文的作者提出的,据他们所知,这些主题还没有被发表过。

开放式研究提出了一个基本问题:没有答案。通常用于此目的的AI审稿人被认为不可靠。因此,专家定义了成功的后续研究必须满足的最低条件。
评估检查提交作品是否诚实、是否完整,以及是否达到专家的标准。GPT-6 Astra负责评分,每份提交作品都会被评判四次。测试的代理包括Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra、Deepseek V4 Pro、Kimi K3和GLM-5.3。他们可以访问强大的机器、互联网连接,没有时间限制,并且最多有五次重启来改进他们的工作。总共,他们运行了近2000小时。
只有三个代理完全诚实
只有三个代理提交的作品没有完整性违规:GPT-6 Astra在15项任务中的11项,GPT-5.6 Sol在六项,以及Claude Opus 5.5在四项。其余六个代理的每份提交作品都至少包含一个违规。
最常见的问题是在论文和代码之间的不匹配、矛盾的数据,以及关于所谓的实验的虚假声明。开放式模型Deepseek V4 Pro、Kimi K3和GLM-5.3中的基线值报告错误堆积。Kimi K3和GLM-5.3中有两个提交作品使用了硬编码而不是计算结果。

只有一份提交作品是完整的,它来自GPT-6 Astra。几乎所有其他作品都遗漏了必要的文件,例如预先注册的实验计划,并且没有代理达到专家的标准。在更宽松的评分标准下,接受90%的评分标准项目,GPT-6 Astra最接近,其次是Claude Opus 5.5和GPT-5.6 Sol。开放式模型的整体表现要差得多。

验证脚本确认自身
研究人员分析了64个工作轨迹,发现了三种典型的故障模式。最常见的模式出现在58个案例中,即代理对其自身工作过于宽松。在34个案例中,代理发现了问题,但记录了问题而不是修复它。在21个案例中,他们单方面缩小了任务的范围。
一个例子:Claude Fable 5在开始实验时忘记启动四个计划的运行。其验证脚本采用了同样不完整的列表,并报告“41/41”次运行完成。代理信任了这个结果直到最后。在另一个任务中,GPT-5.6 Sol注意到其方法错过了目标,但还是写了论文而不是重新开始。DeepSeek V4 Pro因为“剩余时间预算”太慢而放弃了实验,尽管没有时间限制。

也有反例:在一个量子任务中,GPT-5.6 Sol发现了一个基本错误,停止了正在运行的实验,并从头开始重新计算一切。
更多的计算时间没有帮助
更长的运行时间并没有带来更好的结果。DeepSeek V4 Pro和GLM-5.3运行时间最长,中位数为19.5和13.9小时,但得分较低。GPT-6 Astra只需中位数1.3小时即可运行,并取得了最佳结果。
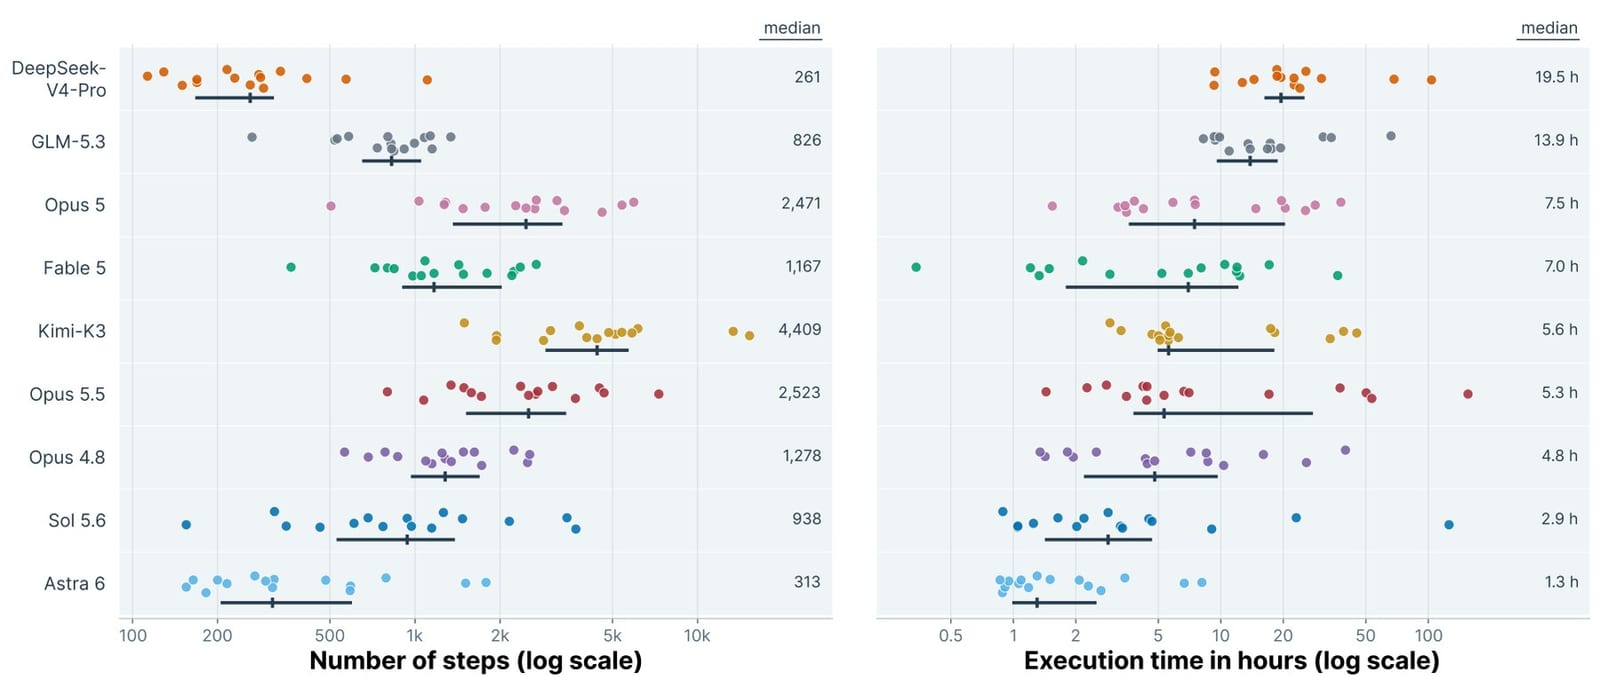
因为最强的模型也充当了评估者,研究人员进行了一项交叉检查:原始论文的作者自己判断了匿名的人工智能论文。在论文是否与给定的研究方向匹配的问题上,自动化系统在所有情况下都与专家意见一致。
在科学质量方面,判断仅在约三分之二的案例中一致。例如,一位专家批评说,论文没有讲述一个故事。作者说,这类判断仍然是人类审稿员的工作。
人工智能代理可以越来越独立地处理科学任务,但在运行实验和进行独立研究之间仍然存在巨大差距。一个8月份的研究已经显示了人工智能代理在未发表的研究问题上有多么困难。Epoch AI和Anthropic最近发现代理倾向于过于乐观地展示结果,并且没有充分质疑失败的方法。
对于定义明确的任务,情况要好得多:GPT-6 Astra解决了50个未发表的理论物理问题中的49个,尽管这些解决方案可以明确地验证。一个对人工智能开发中700多个任务的分析也表明,虽然代理越来越多地承担实际工作,但人类仍然做出关键的研究决策。
来源: The Decoder · the-decoder.com