跳到正文
实时
10月23日周五
  1. Hugging Face Daily Papers65

    Cola2:自适应分层语言模型通过持续语义压缩和平衡离散生成改进分层语言生成。

    Cola2 通过动态跨度分割、掩码扩散解码和流匹配先验联合优化持续语义压缩、重建-生成平衡和编码器-解码器自适应,在五个下游任务上验证了其核心设计,使用 2100 亿训练 token 显示出有竞争力的非饱和扩展性,3460 亿源 token 的未收敛检查点在八个任务上平均达到 60.10 分,并在 HellaSwag 和 StoryCloze 上超越 Llama-3-8B。


  2. Hugging Face Blog66

    微软与 Hugging Face 用 ThinkingBox 数据库校验作 RL 奖励训练智能体

    微软与 Hugging Face 发布 ThinkingBox-Training,把 ThinkingBox 对数据库终态的确定性校验直接当作强化学习奖励,用 GRPO 对 Qwen3.8-27B 训练 50 步。
    推荐理由: 微软与 Hugging Face 把数据库终态校验直接当作强化学习奖励,并公开了任务筛选与训练代码,可迁移到其他有状态智能体训练。

  3. Modal Blog

    Modal 发布开源 Tinker 兼容训练服务器 Spindle

    Modal 发布开源 Tinker 兼容训练服务器 Spindle,支持在 Modal 工作空间运行,通过 GPU 时间计费替代 token 计费,可自定义配置并支持数百个并发训练任务。Spindle 支持 full-parameter 训练和多 LoRA 在多种开源模型上运行,其底层采用分布式控制平面和容器自动扩展,适用于需要自定义训练循环和降低成本的团队。

  4. Databricks Blog60

    Databricks 谈 AI 账单:如何把编码智能体单位成本降低九成

    Databricks 高管 Patrick 复盘公司全面采用 AI 编码智能体后成本指数级上升、再通过控制层把单位成本最多降低 90% 的过程。他提到把流量迁到更便宜的新模型贡献了 50% 以上降幅,Smart Router 在接近最贵模型质量下把平均任务成本降低 30% 以上。这套内部方案后来产品化为 Unity Gateway,目前已有数千家客户使用。

    推荐理由: Databricks 高管复盘自家 AI 编码成本从失控到单位成本降九成的过程,给出网关、路由与自建评测的可迁移做法。

  5. Hugging Face Daily Papers65

    Quant-Arena:基准量化交易研究的大语言模型代理

    Quant-Arena 通过评估语言模型能否在历史A股数据上构建盈利交易策略,并验证其在封闭未来年份数据上的表现,进行基准量化研究。该平台让模型构建特征和股票评分代码,仅基于2022-2023年反馈,冻结策略并在2024年评估。GPT-6 Astra 在九个前沿模型中得分最高,但无模型超越2024年等权市场表现。Quant-Arena 对所有模型或智能体开放。

  6. Microsoft Research58

    Flint-interactive:一种用于创建交互式数据可视化的语言

    Flint-interactive 使 AI 生成的图表具有丰富的交互性,用户可通过点击、筛选、缩放、高亮和跨图表交互来探索数据。它通过高级语义事件和更新操作简化复杂交互的构建,并利用 Flint 编译器处理交互逻辑和视觉依赖,提高可靠性和开发效率。Flint-interactive 支持创建交互式数据故事、仪表板和连接体验,AI 代理可使用其生成带交互功能的图表,帮助用户更高效地分析数据。

10月22日周四
  1. Google DeepMind

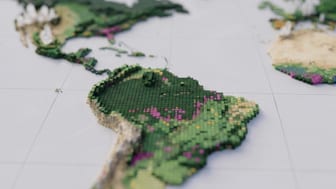
    谷歌DeepMind发布Forest Typology (ForTy) 2020全球森林类型地图

    Google DeepMind 与 Google Research 联合发布 Forest Typology (ForTy) 2020 全球地图,将地球每 10x10 米土地分类为六种森林和土地利用类型,并追踪 2017-2025 年变化。该地图基于联合国粮农组织定义,准确区分原生林、人工林、单一物种林浆、经济作物林和其它土地,支持欧盟防砍伐法规,准确率达 90%。

    同一件事 · 2 家

    各家口径不同:谷歌 DeepMind 表示地图将土地分为六种类型;The Decoder 提到只有四种类型(原始森林、木材种植园和树作物农场)。

  2. The Verge · AI40

    投资研究公司尝试用 Anthropic 的 Claude 生成蝎子抗毒血清但未成功

    投资研究公司 Citrini 与 Anthropic 合作尝试让未发布的 Claude 模型生成蝎子抗毒血清,该模型生成了约 211 个候选蛋白质设计,其中 17 个能结合部分蝎子毒素,但专家指出这仅是药物开发的早期阶段,将候选分子转化为有效药物仍面临巨大挑战。Citrini 承认实验未成功制造出药物,但称其展示了 AI 辅助药物发现的潜力

  3. ChinaTalk

    中国Talk报道:人形机器人训练的第三波数据收集浪潮——以NVIDIA EgoScale项目为例

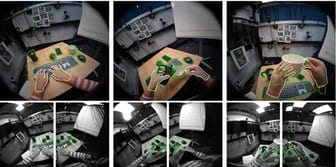
    NVIDIA EgoScale 项目通过将摄像头安装在 1000 名参与者的前额和手腕,收集了 20,854 小时的第一人称视频数据,用于训练人形机器人手部技能;这种被称为“以自我为中心的数据收集”的新方法,标志着人形机器人数据收集进入第三代,旨在解决传统远程操控和同构外骨骼方法的疲劳、成本和精度问题。

  4. MIT Technology Review · AI75

    AI隐性存储成本:推理背后被忽视的数据存储开销

    在企业 AI 推理成本中,数据存储开销常被忽视。每次模型响应后,会产生大量需存储的后端数据,包括日志、缓存、备份等,其体积是用户所见输出文件 130 倍。麦肯锡预测 AI 推理需求到 2030 年将达数据中心总需求的 40%,近 95% 的 IT 决策者报告过去一年因生成式 AI 导致数据量增长。

  5. Hugging Face Daily Papers60

    WildAWM 在真实场景中合成可控计算机环境用于通用智能体训练

    WildAWM 通过交互合成可控的计算机环境与任务,提升通用智能体在 Web、CLI 和 GUI 基准测试中的泛化性能。该系统支持图形界面、模型上下文协议服务及命令行界面,完全基于开源模型,并引入基于执行的关卡机制解决任务合成中的可解性、难度维持和验证器可靠性问题。Qwen 模型在 WildAWM 合成环境中训练后,在 8 项跨分布基准测试中取得显著提升。

  6. Hugging Face Daily Papers65

    Hugging Face Daily Papers:多样化虚拟世界中的具身智能体持续预训练研究

    研究通过在数据规模、多样性和模型大小三个维度上进行持续预训练(CPT),提升了虚拟世界中的具身智能体学习能力,但在远距离世界泛化上存在局限。研究测试了涵盖 0.8B 至 27B 参数、50 至 1600 小时数据预算、五种数据混合的 120 种配置,发现数据量增加提升内部表现,多样性改善相关世界迁移,模型规模提升数据效率但远距离泛化更差。

  7. Hugging Face Blog78

    NVIDIA 发布 Kumo Relational 关系型基础模型,无需训练即可预测

    NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。

    推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。

  8. Baseten Blog58

    Baseten 发布全球顶尖决策模型 mammoth-1 和 elephant-1

    Baseten 发布全球顶尖决策模型 mammoth-1(27B)和 elephant-1(9B),分别位列 Jev 决策指数 0.4 第 1 名和 9B 决策模型第 1 名。两者均开源,可在 Baseten 模型 API 上免费试用一周(默认零数据保留)。

10月21日周三
  1. AWS Machine Learning Blog58

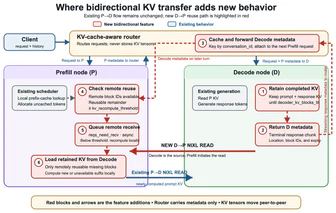
    vLLM 通过双向 KV 传输提升多轮智能体工作负载的 TTFT 性能

    vLLM 的双向 KV 传输机制通过让解码节点在后续对话回合中返回先前计算的 KV 缓存给预填充节点,减少了重复计算,在 AWS EC2 P5en 实例上的多轮基准测试中将 Qwen3-32B 的 TTFT 提升了 1.6 倍,zai-org/GLM-5-FP8 提升了 3.3 倍。该功能通过扩展 NIXL KV 连接器实现,并利用 KV 缓存感知路由器协调跨对话回合的 KV 重用。

10月20日周二
  1. Hugging Face Blog58

    ALTK-Evolve如何通过学习记忆在τ²-bench客户服务任务中超越前沿模型

    ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。

10月19日周一
  1. O'Reilly Radar65

    《周一早晨代理》项目通过美式橄榄球数据训练AI分析师。

    《周一早晨代理》项目每两周使用NFL公开数据集分析一个美式橄榄球争议话题,逐步为AI智能体赋予分析能力。该项目使用25万个比赛片段和当前赛季数据,每期让AI解释特定战术(如“建立进攻线”)并验证其分析结果。AI在分析时需说明数据局限性,并拒绝超出任务范围(如预测比赛结果)的请求。

  2. IBM Research Blog22

    Coursera 新课程《AI 数据流架构:从原理到实践》教授现代加速器运行原理

    Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。