Hacker News · AI 热帖精选8080
Unemployment Labs 报告称 DeepSeek、Kimi、MiniMax、蚂蚁六款模型权重带有 Blackwell 硬件指纹
Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。

推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
今天最值得读的 AI 新闻,来自正在塑造 AI 的实验室、创业公司和研究者。
Hacker News · AI 热帖精选8080Unemployment Labs通过分析公开模型权重中的随机数初始化布局,发现DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3。
推荐理由: 通过模型权重中的随机数布局反推训练硬件,为出口管制争议提供了可复现的技术取证路径。
 Databricks Blog精选6060
Databricks 发布 Lakehouse//RT,用于在湖仓上直接承载 AI 智能体带来的高并发实时查询,目前处于 beta 阶段。官方称可在 12,000 QPS 下提供低于 100 毫秒的延迟,并通过高并发、快速执行、小步扩容和单一系统四条路径让成本增速低于查询量增速。
推荐理由: 原文给出四个降本机制和三家客户的迁移数据,可据此判断实时分析层是否值得替换。
Databricks Blog精选6666Databricks 宣布 Genie Ontology 正式可用,由智能体从仪表盘、SQL 查询、notebook 和语义模型中持续学习业务上下文,再由人通过 Unity Catalog 治理关键定义。
推荐理由: 原文给出与 Turing 共建基准的通过率、耗时和 token 对比,可据此判断企业上下文层对智能体准确率的影响。
 Google DeepMind精选同一件事 · 5 家6666
Google DeepMind 发布 AlphaGenome 2,这是一个条件化 DNA 序列模型,可针对特定细胞类型或状态预测 DNA 变异对基因表达的影响。
推荐理由: 官方披露了条件化架构改造与单细胞层面的评测对比,可了解该模型如何把变异效应定位到具体细胞类型。
 Claude · YouTube精选6868
Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
 IT之家 · AI精选7575
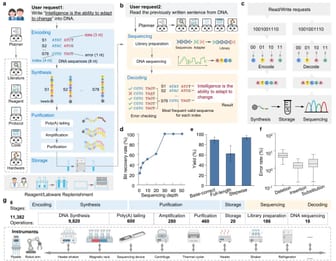
上海交通大学陈海波、王肇国团队与樊春海、王飞团队合作构建 AI 原生科学实验室 AutoDNA 装置(思源一号),实现自主分子生物学实验操作,成果发表于《自然》并获官网首页头条报道。
推荐理由: 该研究把多智能体架构与仪器原子服务结合,让 AI 自主完成分子生物学实验,可作为 AI 原生实验室架构的参考。
 The Decoder精选7272
Nous Research 使用约 5300 万 token 对阿里 Qwen3.8-27B 进行监督微调,得到开源权重模型 Arete-27B,其宣传性回答占比从 22% 降至 0.9%,事实准确率从 2.32 升至 2.98。
推荐理由: 原文给出了微调前后的宣传率与事实准确率对比,读者可据此判断中文开源模型的政治倾向是否只停留在表层。
The Decoder精选7878一项研究让 Claude Opus 4.8、Claude Opus 5、Claude Fable 5、Claude Opus 5.5、GPT-5.6 Sol、GPT-6 Astra。
推荐理由: 这项基准用 15 个未发表的研究问题检验 9 个智能体,并给出 135 份提交中常见的失败模式,可作为评估自主科研能力的参照。
The Decoder精选7171Google Research 的 AI 无需血压袖带校准,仅凭智能手表已有的脉搏和运动传感器即可检测高血压迹象,相关研究已发表于 Nature。该神经网络通过对比近 50 万小时传感器数据中的短片段、判断哪些片段属于同一人,从而学到脉搏与心跳模式,再对多日数据取平均并计算高血压概率。
推荐理由: 读者可了解一项无需袖带校准的智能手表血压检测研究,及其在 196 人试验中与传统测量的对比结果。
 Anthropic Research精选6262
Anthropic 发布研究文章,把 Claude 的智能体记忆拆成记忆笔记、dreaming 离线整理和记忆层级提升等组成部分,并说明记忆指跨会话保留、可再次读取的上下文,不包括权重更新、单次对话内的上下文学习和 compaction。
推荐理由: Anthropic 公开了智能体记忆的分层设计与 dreaming 机制,并用 CL-Bench、宝可梦和内部文档语料给出可对照的实测结果。
 TechCrunch · AI精选7171
Ramp报告显示,8月至9月企业token支出仅增长1.5%,而7月环比增长42%,同期token用量仍在上升。Ramp首席经济学家Ara Kharazian认为,OpenAI与Anthropic的降价和企业折扣让AI使用更便宜,支出最高的前1%企业也略低于夏季峰值的人均每月1万美元。 Ramp数据显示AI支出停滞,正值Anthropic临近IPO。 Ramp的支出数据给出一个与用量增长相反的价格信号,可用来观察模型公司收入与IPO估值之间的张力。
推荐理由: Ramp的支出数据给出一个与用量增长相反的价格信号,可用来观察模型公司收入与IPO估值之间的张力。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 Google Research精选同一件事 · 2 家7272
Google Research 在 Nature 发表多模态 AI 系统 AI-PPG-ACC-HTN,无需袖带校准,仅用消费级智能手表的 PPG 与加速度计数据被动识别高血压状态。
推荐理由: 研究用智能手表 PPG 与加速度计数据被动识别高血压,并以 24 小时动态血压监测为金标准给出筛查与确认两阶段的量化结果。
IT之家 · AI精选同一件事 · 3 家7474百度文心发布 ERNIE-5.5-Flash-Base 并开放 ERNIE 5.5 Flash 预训练终点权重,这是一个总参数 280B、每 token 激活 14B 的稀疏 MoE 语言模型,在 33.5T tokens 上从零预训练,微调与推理支持 1M tokens 上下文。
推荐理由: 原文给出 280B 稀疏 MoE 基座的参数、训练数据量与开源权重,读者可据此判断其作为微调起点的适配空间。
 Hugging Face Blog精选6565
Dharma-AI 发布 Dharma Field Extractor,一个 2B 参数模型,输入文档图像和可选 schema,输出带类型的结构化 JSON,支持开放抽取与按 schema 定向抽取,未出现的字段返回 null。
推荐理由: 原文给出自建基准上的质量与成本对比,读者可据此判断小模型专精路线在字段抽取任务上的可行性。
 OpenHands Blog精选7171
OpenHands与Snowflake AI Research合作,让开发者用现有的OpenHands Agent harness直接进行强化学习后训练,无需在训练框架中重建harness。
推荐理由: 原文给出了用现有 Agent harness 直接做 RL 后训练的具体配置方式和代码定位实验,读者可据此判断训练与部署能否共用一套 harness。
 量子位精选同一件事 · 3 家8080
MIT的实验让GPT-6 Astra直接读取并编辑Qwen3.5-0.8B的权重,仅改动0.016%的参数、不做训练和梯度下降,MATH-500得分从7.9%升到48.1%,指令执行能力也提高3倍。
推荐理由: MIT 实验显示前沿模型可直接读写小模型权重,为免梯度训练的性能修复提供了一条可复现路径。
IT之家 · AI精选8383美满电子(Marvell)11 月 2 日宣布以约 1150 亿美元全股票交易收购光通信企业 Lumentum,隐含企业价值约每股 1132 美元,较 10 月 28 日股价溢价约 23.9%。
推荐理由: 这笔交易把光互连和激光器产能纳入同一家公司,读者可据此理解AI数据中心连接层的竞争格局变化。
 36氪 · AI精选7272
美团发布新一代大模型 LongCat-2.5,这是一款面向长程智能体任务的原生多模态模型,总参数 1.6 万亿。该模型全程在国产算力上训练,美团称这是目前国产算力上完成的最大训练任务。评测结果显示,LongCat-2.5 在多项主流基准评测中的成绩介于 Claude-Opus-4.8 与 Claude-Opus-5 之间,并在部分评测中超过 Claude-Opus-5。
推荐理由: 美团新一代大模型全程在国产算力上训练,读者可据此了解国产算力承载超大规模训练任务的进展。
IT之家 · AI精选7272据彭博社报道,Alphabet、Meta、微软、亚马逊和甲骨文承诺未来数年在数据中心等领域投入超过 3 万亿美元,其中租赁付款承诺合计 1.3 万亿美元、其他采购承诺合计 1.9 万亿美元。
推荐理由: 五家巨头的合同承诺规模与口径差异被一并列出,可看清 AI 数据中心投资的资金结构与回收压力。