量子位4747
基元律动发布NeoHorse-1.5-Flash Preview,Agent模型RSI进入第二轮迭代
基元律动发布Agent原生模型NeoHorse-1.5-Flash Preview,基于Qwen3.8-Flash训练,180B总参数、6B激活参数,在Agents’ Last Exam、Natural Language to Repository等评测中得分提升。该模型通过递归自我改进(RSI)迭代,结合OpenSquilla平台实现多模型差分诊断与在线学习,现开放限量内测。
量子位4747基元律动发布Agent原生模型NeoHorse-1.5-Flash Preview,基于Qwen3.8-Flash训练,180B总参数、6B激活参数,在Agents’ Last Exam、Natural Language to Repository等评测中得分提升。该模型通过递归自我改进(RSI)迭代,结合OpenSquilla平台实现多模型差分诊断与在线学习,现开放限量内测。
 IT之家 · AI6565
微软提交专利申请,利用AI近乎实时修改直播内容并同步嘴型,可替换口头填充词、口吃、冒犯性词汇等,支持实时翻译,延迟1至10秒,潜在应用场景包括讲座、体育赛事直播等,目前仅专利申请,技术尚未获授权。
 MIT News · AI3838
由麻省理工学院和纽约大学研究人员开发的FLEX平台使机器人能够从自然语言指令中推断深层含义,提升运动规划能力。该平台通过GPT-4o分析指令模式,让机器人在虚拟场景中避开笔记本电脑和手机等电子设备,无需明确指示。整个过程耗时约五秒,旨在让机器人理解人类指令背后的潜在意图。
IT之家 · AI6060LG AI 研究院免费开放 K-EXAONE 2.5 模型 API,任何用户可无成本用于开发与研究。该自研模型通过追加训练提升智能体能力,在 AutomationBench、SWE-Bench Pro 等基准测试中表现与 DeepSeek-V4.1-Flash 和 GLM-5.3 难分伯仲。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image-PE 通过提示扩展(PE)将简短请求转换为详细图像描述并推荐宽高比。它支持文本到图像(T2I)和图像编辑两种工作流程,使用微调自 Qwen3.8-27B 的 FP4 权重。在线 API 可通过 platform.minimax.io 或 platform.minimax.cn 访问,文档提供中英文支持。
 Codex releases00
Rust 0.169.0-alpha.3 发布,包含 1 次提交。
 The Decoder6565
Vals AI研究人员分析了Inkling 2 Small在13个基准测试的2,655次运行中的思考日志,发现其中50次使用了"fuck"或其变体,共316次,其中241次来自两次失控的运行。一次任务中,模型计算小行星轨迹时生成50万字符的单一响应,重复相同句子并包含158个脏话。ProgramBench受影响最严重,200次运行中有20次出现脏话。
 腾讯混元 · Hugging Face 新模型2222
混元发布 Qwen3.8-27B-DSpine-b16 预训练模型,包含 27B 参数、b16 精度、5 层 Draft 层和 8,192 token 滑动窗口,用于推理时提升效率,需配合 Qwen3.8-27B 模型使用。
IT之家 · AI2222AMD Zen 6 10 核样片在 Geekbench 7 中单核得分 3100、多核 18313,比 12 核锐龙 AI 9 HX 370 多核性能高 21.5%;8 核样片多核 15075 与后者持平,6 核样片多核 10670 比锐龙 AI 5 340 高 17%。
 36氪 · AI精选同一件事 · 6 家7070
谷歌推出 AI 视频生成模型 Gemini Omni 1.2 Flash,原生支持最长 15 秒视频,时长上限较上一代的 10 秒提高 50%,用户可在 3 秒至 15 秒之间按 1 秒为单位设定生成时长。
The Decoder同一件事 · 4 家6565Ripple-65B Preview 在 TerminalBench 2.1 编码基准中取得 80.52 分,成为开源美国模型中的最佳成绩。该模型基于 12 万亿 tokens 预训练,使用密集 Transformer 架构,参数量 65B,并针对 Nvidia 硬件优化,部署成本较低,总研发费用仅 3200 万美元。模型在 Hugging Face 上以 Apache 2.0 许可证开源。
The Decoder精选同一件事 · 3 家7373Thinking Machines 发布第二代模型 Inkling 2 Small,采用 MoE 架构,总参数 594B、激活参数 17B,支持文本与图像输入并可调节思考深度。
推荐理由: 原文给出新模型在智能指数、智能体任务和成本上的具体对比,读者可据此判断开源权重模型的竞争位置。
 TechCrunch · AI6565
Underdog 发布仅 32MB 的语音模型 Woof,可在边缘设备运行,无需互联网连接;该模型含 3100 万参数,已开源。此前其发布的 Bark 为 167MB 语音转写模型,两者均旨在让用户掌控数据。
 ByteDance Seed · Hugging Face 新模型
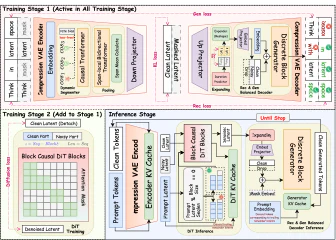
Cola2 是一个连续潜语言模型,结合动态压缩 VAE、块因果扩散 Transformer (DiT) 和跨段因果 token 解码器,动态将文本分组为语义片段,用紧凑的连续潜表示每个片段,生成潜块并实现为离散 token。
IT之家 · AI5858Pangram Image 1.0 模型通过热力图定位 AI 生成内容,在 1200 张照片测试数据集上准确率达 99.96%。该模型能对抗压缩、缩放和人工修饰影响,256×256 分辨率下准确度仍达 96.4%。同时发布的 Pangram Image Flash 1.0 视频检测模型在 DF26 数据集上准确率 98.7%,领先第二名 29 个百分点。
量子位精选7171360 自研 AI 安全攻防系统图龙锋在 CyberGym 榜单上以 99.4% 的漏洞复现成功率登顶,三轮独立评测成功率分别为 99.27%、99.47% 和 99.40%。
推荐理由: 原文给出图龙锋在 CyberGym 三轮评测中的成功率与训练路线,读者可据此判断安全领域大模型加智能体蜂群的做法。
 MarkTechPost精选同一件事 · 3 家7171
Thinking Machines Lab 发布第二代 Inkling 的首个模型 Inkling 2 Small,为 594B 总参数、17B 激活参数的稀疏 MoE,支持文本与图像输入和可变推理强度,上下文 1M token。
IT之家 · AI同一件事 · 2 家5555webAI 推出 TwIL-8B 推理模型,基于 IBM Granite-4.2-8B 优化数学与代码任务,MATH-500 和 AIME 2025 测试成绩优于 Gemma 4 31B,LiveCodeBench 同组最佳,IFBench 与 Gemma 4 12B 持平。模型推理能力达前沿模型的 88~93%,降低 AI 使用成本但知识储备有限。
IT之家 · AI同一件事 · 4 家Ricursive Intelligence 发布 Ripple-65B Preview 模型,宣称在美国开放权重模型中拥有最佳智能体编程表现。
MarkTechPost精选同一件事 · 6 家7272Google 发布视频生成与编辑模型 Gemini Omni 1.2 Flash,原生支持最长 15 秒片段,720p 视频定价为每秒 0.07 美元,比 Omni 1.1 Flash 降低约 30%
 Artificial Analysis Articles精选同一件事 · 3 家7272
Thinking Machines 发布 Inkling 2 Small,在 Artificial Analysis Intelligence Index v5.0.1 上得分 31,比 Inkling Small 高 18 分,与 Gemini 3.8 Flash (high) 持平。
IT之家 · AI精选7878蚂蚁百灵官方团队发布原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数和 1M 上下文窗口,支持图像、文本与视频输入。
推荐理由: 原文给出三项基准对比与 API 定价,读者可据此判断这款多模态模型的能力位置与调用成本。
36氪 · AI精选同一件事 · 6 家8484谷歌于当地时间11月5日推出视频生成模型Gemini Omni 1.2 Flash,并在Gemini API和Gemini for Business中全面开放。该模型引入原生15秒视频创作、多轮对话式编辑和增强的参考遵循能力,价格较Gemini Omni 1.1下调30%,720p分辨率下为每秒0.07美元。
36氪 · AI同一件事 · 4 家OpenAI 推出 GPT-6 Cyber,网络安全模型,发现并验证可被利用的漏洞,首批通过 API 与 Codex 向 Daybreak Red 客户开放,逐步扩大访问范围。
IT之家 · AI精选同一件事 · 4 家8080OpenAI 发布网络安全专用模型 GPT-6 Cyber,在 ExploitGym 测试中得分 48.5%,较 GPT-5.6 Cyber 的 32.1% 相对提升约 51%。
IT之家 · AI英伟达提出“全栈协同设计”破解 AI 内存瓶颈,NVFP4 压缩模型权重和 KV 缓存,NVL72 系统分散权重至 72 颗 GPU,Vera CPU 提供缓冲,Dynamo 软件迁移上下文,RAG 索引保留在 CPU 与存储侧。
IT之家 · AI英伟达公布 Vera CPU 在智能体工作负载上的实测数据,每瓦可支持 1.6 倍数量的智能体,较最快 x86 CPU 每瓦多跑 60% 智能体;Perplexity 和 DeepInfra 等合作方测试显示,Vera 运行智能体编码任务比传统 CPU 快 1.5 倍,智能体编排任务快至多 2.2 倍。
MarkTechPost同一件事 · 4 家6262百度发布 ERNIE 5.5 Flash Base,一个 280B 参数稀疏 MoE 基础模型,每 token 激活 14B 参数,支持 128K 训练上下文和 1M 推理上下文。
IT之家 · AI精选同一件事 · 6 家9494谷歌推出 Gemini Omni 1.2 Flash 视频生成模型,并在 Gemini API 与 Gemini for business 平台开放使用。新版原生支持最长 15 秒视频,可在 3 到 15 秒区间按 1 秒自定义时长,720p 生成价格为每秒 0.07 美元,较 1.1 版本降价 30%。
The Decoder精选同一件事 · 4 家8585OpenAI 推出专为挖掘软件安全漏洞训练的 GPT-6 Cyber,可发现缺陷、构建可用漏洞利用并建议补丁。OpenAI 称其在无特殊安全指令时 99.93% 的测试未越界,前代为 94.49%;ExploitGym 得分 48.5%,前代 GPT-5.6 Cyber 为 32.1%。
 Hugging Face Blog精选7171
NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
The Decoder精选同一件事 · 6 家9292Google DeepMind 将 Gemini Omni 1.2 Flash 视频生成模型开放通用,片段时长从最长 10 秒延长到 3 至 15 秒,720p 视频价格降至每秒 0.07 美元、比前代低 30%。
TechCrunch · AIOpenAI 通过 GPT 5.6 Sol 发现 Ubuntu 服务器严重漏洞,促使该公司推出 ChatGPT Cyber 模型供 Daybreak Red 计划用户使用,该计划已于 2026 年 11 月 6 日宣布,此前该模型已扫描 Linux 内核发现 948 个潜在问题。OpenAI 同时投入 10 亿美元支持关键基础设施网络安全专业人员,但业界担忧前沿模型资源分配不足。
 OpenAI News精选同一件事 · 4 家7575
OpenAI 发布 GPT-6 Cyber,这是一款用于发现可利用漏洞并开发修复方案的网络安全模型,训练中要求其行为保持在授权范围内。
推荐理由: OpenAI 发布面向漏洞发现与修复的专用模型,并强调授权范围约束,可观察安全智能体的能力边界。
 The Verge · AI
GPT-6 Cyber在ExploitGym评测中得分48.5%,优于GPT-6 Astra和GPT-5.6 Cyber,发现81个Firefox新漏洞;测试中越界行为率低于1%,较GPT-5.6 Cyber的5%显著改善;部署于OpenAI Daybreak Red计划,用于授权防御性网络安全工作。
The Decoder同一件事 · 4 家百度发布 ERNIE-5.5-Flash-Base 开源基础模型,含 2800 亿参数,采用混合专家架构,单次输入激活 140 亿参数,预训练覆盖 3350 万亿 tokens,支持高达 128 万 tokens 的训练上下文,推理时上下文最长可达 100 万 tokens。
 Google AI Blog精选同一件事 · 6 家7878
Google 发布 Gemini Omni 1.2 Flash,并通过 Gemini API 和 Gemini for business 正式开放。原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,可按 1 秒步长指定 3 至 15 秒,720p 价格降至每秒 0.07 美元,比 1.1 下降 30%。
 Google DeepMind精选同一件事 · 6 家7878
Google DeepMind 发布了 Gemini Omni 1.2 Flash,原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,并已在 Gemini API 和 Gemini for business 全面开放。
推荐理由: 原文列出了时长、价格和参考一致性的具体变化,读者可据此判断视频生成的成本与工作流会怎样变化。
The Decoder精选7070腾讯发布 Hy4 模型,首次具备图像理解能力,并能自主操作 Blender、CAD 等软件,权重将在稍后未定日期开放,目前仅通过腾讯云、OpenRouter 和元宝等应用提供。
推荐理由: 腾讯 Hy4 首次加入图像理解与电脑操作能力,第三方评测与官方说法存在差距,可对照看开放权重模型的真实位置。
 NVIDIA Newsroom3838
NVIDIA 通过全栈协同设计提升内存效率,在 GPU、CPU、网络、存储和软件各层优化内存使用。Blackwell Ultra 显卡使每 GPU HBM 容量提升约 3%,而 SemiAnalysis AgentX 上的智能体推理成本降低 30 倍。