NVIDIA 发布 Cosmos 3 四个开源世界模型检查点
New NVIDIA Cosmos 3 Open Models for Interactive World Simulation
NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
TL;DR
NVIDIA Cosmos 世界模型开发平台为其 Cosmos 3 模型家族新增了四个开放权重检查点,用于生成交互式世界模拟和多传感器多视角驾驶场景:
- 🌦️ Cosmos3-Nano-Transfer-Auto : 生成具有不同天气、光照和一天中时间的多视角驾驶数据。
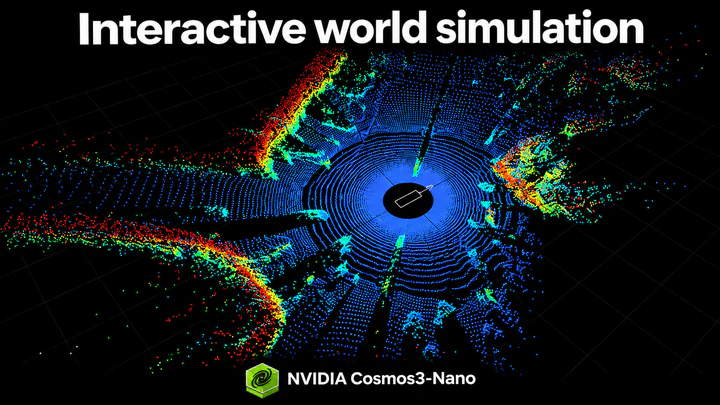
- 🚗 Cosmos3-Nano-Sim-Auto : 流式传输同步的相机和 LiDAR 观察,用于驾驶模拟。
- 🎨 Cosmos3-Nano-Sim-Transfer : 将模拟器控制和文本提示转换为照片级真实视频。
- 🤖 Cosmos3-Nano-Sim-Bimanual : 根据机器人或相机动作预测视频。
这四个模型都是 Cosmos 3 Nano 的后训练示例,具有 16B 可训练参数。这些模型使用 OpenMDW1.1,根据其条款允许商业和非商业使用。
为什么需要这些检查点?
🦾 机器人技术需要能够回答在不同场景和视点下问题的环境。这些检查点提供了构建它们的补充方法:Sim-Bimanual 根据动作预测视觉后果,而 Sim-Transfer 将物理模拟器的控制转换为生成的观察结果。
🚦 对于自动驾驶,外观和几何形状必须一致。同步相机和 LiDAR 生成将视觉观察与 3D 传感连接起来。场景和交通信号控制允许研究人员改变道路布局和信号状态,然后研究驾驶策略如何响应。
🔄 每个观察结果都可以塑造下一个动作。流式传输生成将视频预测与持续交互连接起来,为世界模型研究人员提供了一种探索动作和观察结果如何共同展开的方法。
🌐 为他人提供构建基础的开源基础。NVIDIA 的愿景是帮助研究人员和开发人员创建更丰富、更具响应性的模拟世界。开放权重和后训练配方为适应模型、比较方法和贡献改进提供了共同的起点。这些问题仍然很困难:未来的工作在于衡量模型在多大程度上支持策略学习和评估,了解它们的局限性,并在它们不足之处进行改进。
使用 Cosmos3-Nano 构建自动驾驶汽车世界
🌦️Transfer-Auto: 驾驶场景 → 多传感器数据
Cosmos3-Nano-Transfer-Auto 是一个用于离线合成驾驶数据生成的双向模型。它可以生成最多 11 个相机视图的同步视频,包括鱼眼视图,并支持 RGB–LiDAR 联合生成。每个相机的世界场景地图 (WSM) 控制指定场景结构和交通运动,而文本提示则指导外观。
开发者可以改变环境条件以扩展训练和评估范围,并提供可选的初始RGB图像来锚定场景外观。联合LiDAR生成还使用对齐的高清地图范围图控制。 Transfer-Auto也作为Cosmos适应您自己的传感器配置和驾驶领域的基石。从在您的数据上进行后训练开始,以适应您的相机布局、LiDAR配置和目标环境。适配后的模型可以直接用于离线数据生成,或进行因果训练和少步蒸馏以实现快速流式模拟——这是创建Cosmos3-Nano-Sim-Auto所使用的开发路径。
将您的代理指向开放技能 : 使用Cosmos3-Nano-Transfer-Auto运行推理
更喜欢笔记本吗?打开 Transfer-Auto。
🚗Sim-Auto: 驾驶控制 → 流式观察
Cosmos3-Nano-Sim-Auto是Transfer-Auto的因果蒸馏流式变体。它仅通过少数去噪步骤生成连续的小块同步相机视频和LiDAR,使用生成的历史记录和更新的驾驶控制来支持快速流式和长时间交互式运行。
为每个相机提供标题和同步的WSM控制,可选地添加初始RGB图像。对于LiDAR生成,包括与相机控制对齐的高清地图范围控制。蒸馏模型使用其滚动历史记录生成连续块。闭环交互需要一个模拟运行时和WSM渲染器来从驾驶输入更新这些控制。对于新的传感器配置或领域,首先适配Transfer-Auto,然后将其蒸馏为Sim-Auto。
将您的代理指向开放技能 : 使用Cosmos3-Nano-Sim-Auto运行推理
更喜欢笔记本吗?打开 Sim-Auto。
🎨 Sim-Transfer: 模拟器控制 → RGB
您的模拟器计算运动、接触和物理状态。Sim-Transfer使用其空间控制和文本提示来渲染策略可以消费的彩色观察结果。
动作 → 模拟器更新 → 空间控制 → 生成的RGB → 下一个策略动作
深度:相机相对于的距离。
分割:区域和对象边界。
边缘:场景轮廓。
模糊:粗糙的外观和布局。
文本指导外观;物理和真实状态保持与模拟器。
深度控制到视频
分割控制到视频
将您的代理指向开放技能 : 使用Cosmos3-Nano-Sim-Transfer运行推理
更喜欢笔记本吗?使用 Transfer。
🤖 Sim-Bimanual: 动作 → 视频
输入帧
来自Sim-Bimanual模拟检查点的输出视频
Cosmos3-Nano-Sim-Bimanual模拟环境如何响应双臂机器人的动作而演变。它支持YAM和AgiBot实体的交互式双臂模拟,由策略或人类操作的操纵杆控制。
从一个图像开始,移动机器人或相机,并生成下一个观察结果。一个控制序列可以在视点变化和操作之间切换。
混合动作示例使用59个控制值,在训练期间填充到64个。其架构定义了坐标系、旋转、夹爪校准、有效性掩码和控制域。遵循这些约定,以便每个值描述预期的运动。
保持时间同步:T转换需要T+1个观察值。训练将原始捕获转换为模型的动作表示;释放的推理动作已经归一化。
在这里,Sim-Transfer从物理模拟器的更新状态生成视觉效果;Sim-Bimanual直接从场景和机器人动作生成下一个观察值。
要求:Linux、NVIDIA GPU、Docker和NVIDIA容器工具包。发布的vLLM-Omni设置在一个GB200上进行了测试;这不是一个最小内存规范。服务器下载权重;客户端获取样本输入。
将您的代理指向开放技能:使用Cosmos3-Nano-Sim-Bimanual运行推理
更喜欢笔记本吗?打开 双臂
流式生成的工作原理
Cosmos 3的Mixture-of-Transformers主干通过注意力连接独立的文本处理和视觉生成网络。生成器根据提示、可用的控制和生成的历史记录预测每个短片段。
控制+历史→生成块→解码图像→更新历史
去噪将噪声、压缩的视频表示细化为一个片段。时间因果注意力让它读取可用的历史记录和控制,同时阻止未来的目标观察。键/值缓存保留注意力信息以供下一次预测。
该模型在称为潜伏变量的压缩视频表示上运行。在初始图像之后,每个潜伏时间步表示四个RGB帧。迁移预测每个块一步;报告中优化的Bimanual设置预测两步。较小的块允许新的控制更频繁地影响生成。
四阶段训练配方
阶段0 — 双向适应:从完整的记录片段学习域及其控制到视频的关系。
阶段1 — 教师强制:根据早期的记录观察和可用的控制预测每个块,同时屏蔽干净的答案和未来目标。
阶段2 — 一致性蒸馏:使用冻结的教师来训练一个学生,该学生以四个去噪步骤生成每个块。
阶段3 — 自我强制:在学生的生成历史记录上训练。冻结的教师和辅助分数模型提供分布匹配信号。
为什么最后阶段很重要:一个稍微预测错误的物体成为后续帧的上下文,因此错误会累积。自我强制让训练暴露于生成的历史记录。蒸馏和缓存降低了生成每个观察值的成本。
🛠️ 使用您的数据适应
训练后配方从Cosmos3-Nano或兼容的基权重开始,涵盖所有四个阶段。保留完整训练检查点以继续;导出的推理权重省略优化器和其他训练状态。
Transfer-auto:在您的驾驶数据上进行后训练,以适应您的传感器配置和域,并生成离线合成数据。
Sim-auto:将因果训练和蒸馏应用于适应的Transfer-Auto模型,以进行快速流式模拟。
Sim-Transfer : 使用本地数据准备、阶段配置,并在您的环境中对检查点进行后训练,然后继续。
Sim-Bimanual: 为您的实体进行后训练,包括数据验证、阶段配置、检查点交接和导出。
为您的编码代理提供技能和数据集位置。遵循环境检查,验证样本,并在长时间运行之前测试培训和重启。在保留的情节上评估质量:成功的短运行验证执行,而不是收敛。
更多资源
来源: Hugging Face Blog · huggingface.co