腾讯发布 Hy4 模型,首次支持图像理解与电脑操作
Tencent releases Hy4 with vision and computer use, claims second place among Chinese AI models
腾讯发布 Hy4 模型,首次具备图像理解能力,并能自主操作 Blender、CAD 等软件,权重将在稍后未定日期开放,目前仅通过腾讯云、OpenRouter 和元宝等应用提供。
腾讯 Hy4 首次加入图像理解与电脑操作能力,第三方评测与官方说法存在差距,可对照看开放权重模型的真实位置。
腾讯发布了其AI模型Hy4。这是该模型首次能够理解图像并独立运行软件。该公司将其视为最好的公开可用模型之一,但模型权重将在稍后公布。
在预览大约两个月后,腾讯发布了完成的语言模型Hy4。据腾讯称,该模型在其前身的基础上训练了更多的数据,并且“首次”跻身最强的公开权重模型之列。在权重尚未在未指明的日期发布之前,Hy4只能通过腾讯云、OpenRouter以及腾讯的Yuanbao聊天机器人等应用程序获得。
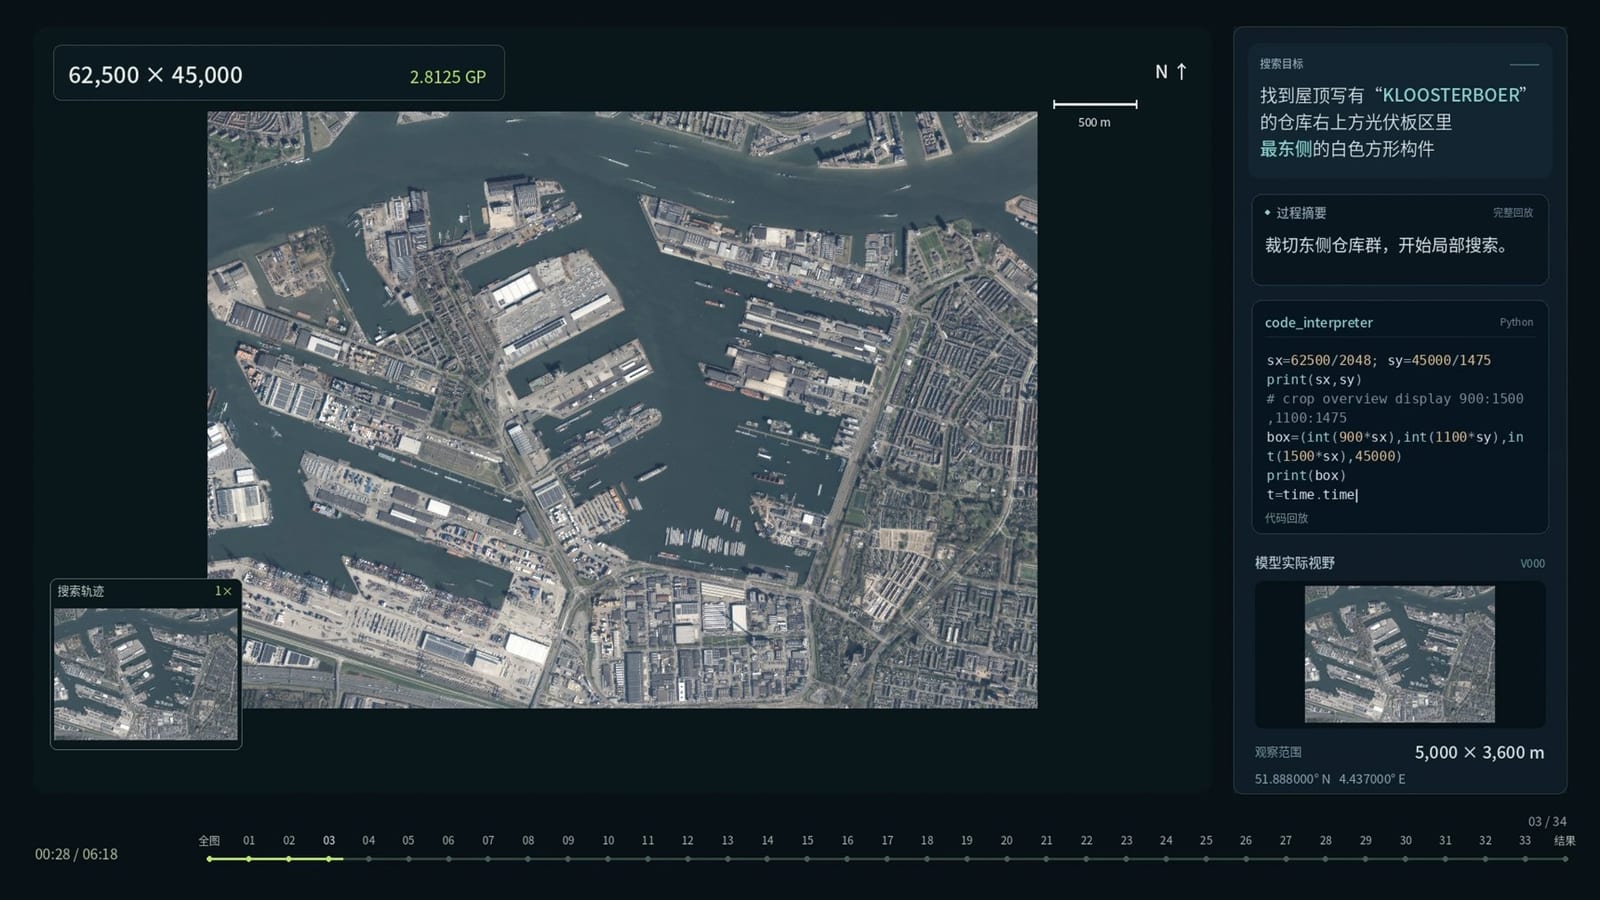
最大的新功能是图像理解。Hy4应该能够识别照片中的细微细节和复杂图表。在一个演示中,它在一张巨大的航空图像中找到了屋顶上大约两米的一个组件。该模型还首次能够独立操作计算机,控制软件。腾讯专门针对专业工具如Blender和CAD程序以及需要依次使用多个应用程序的任务对其进行了训练。
图像理解也旨在帮助编程,例如构建网站和游戏。在游戏开发方面,腾讯与其自己的游戏工作室合作,并针对流行的游戏引擎如虚幻引擎、Unity和Godot调整了该模型。根据开发团队的说法,在《王者荣耀》这款手机游戏中,Hy4几乎完美地处理了配置任务,并且比以前更频繁地找到了错误的根本原因。
金融作为关键的测试领域
腾讯在金融和办公应用程序方面付出了特别努力。据腾讯称,在超过200名金融专业人士对Hy4在近600项实际任务上进行评估的测试中,该模型排名优于中国竞争对手Deepseek V4.1 Flash、Kimi K3.1 Pro和GLM-5.3 Flash。据腾讯称,Hy4在网页研究时产生的幻觉也大大减少。由于搜索功能的改进,内部测试中的幻觉率从近16%降至约5%。该模型还能够实时与人类协作处理Word、Excel和PowerPoint文件。
合作伙伴公司报告了类似的进展,尽管它们也依赖于自己的内部测试。金融平台Comein认为Hy4是与Anthropic的Claude Opus 5.5(第二位)相当的唯一中国模型,并且明显优于OpenAI的GPT-6.1 Sol在数据查询方面。代理平台Manus报告说,Hy4成功地完成了几乎所有文档任务。

来自Artificial Analysis的初步独立评估描绘了一幅略有不同的画面。在其结合知识工作、编程、科学和一般知识的智能指数上,Hy4得分为35分,高于中位数30分。这使其与Grok 4.7持平,并将其置于中国实验室模型中的第二位,仅次于得分为46分的Kimi K3.1 Pro。在腾讯自己的金融测试中,Hy4仍然排名优于Kimi。
如果没有网络搜索,情况就会改变。在 AA-Omniscience 事实准确性测试中,Hy4 根据其训练数据正确回答了大约一半的问题。当它不知道答案时,89% 的时间会编造一个答案,而不是承认知识空白。

帮助构建下一代自身的 AI
在一次涵盖七个领域的内部研究任务测试中,腾讯称 Hy4 在公开可用的模型中排名第一。与代理系统 Hyra 2.0 一起,Hy4 还优化了腾讯为较小模型设计的训练流程。
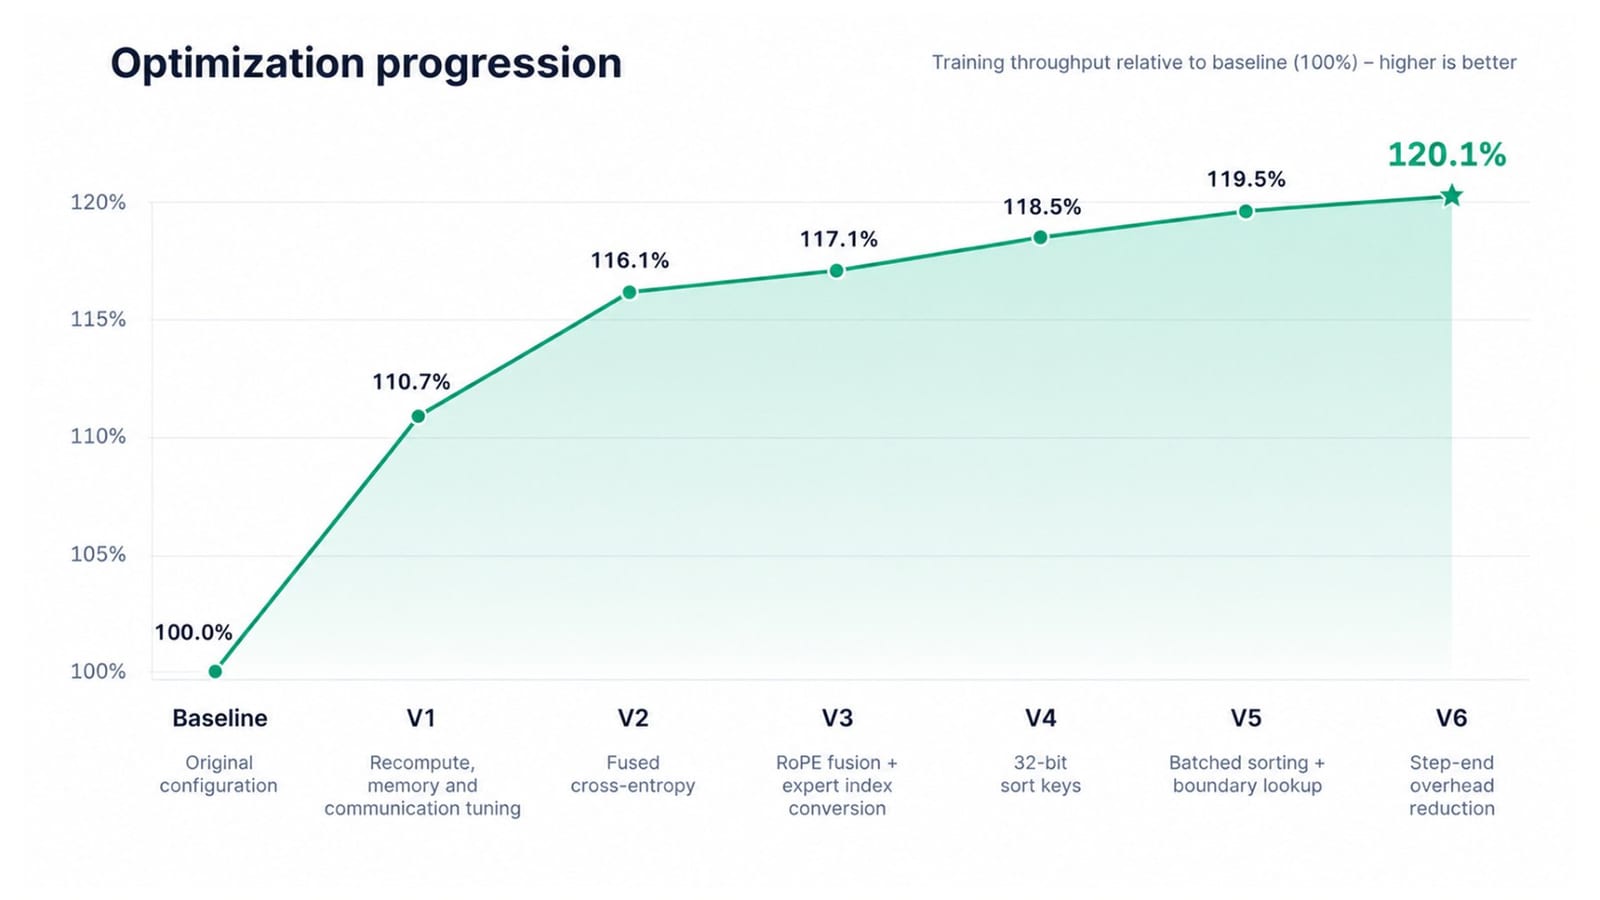
然后,它独立训练了自己的 Jev 版本,这是一个来自美国初创公司 TypeSafe AI 的决策模型。该版本在几个未命名的测试中表现优于原始版本。腾讯以开源模型的形式发布了两个这样创建的生物学和物理学专用模型。
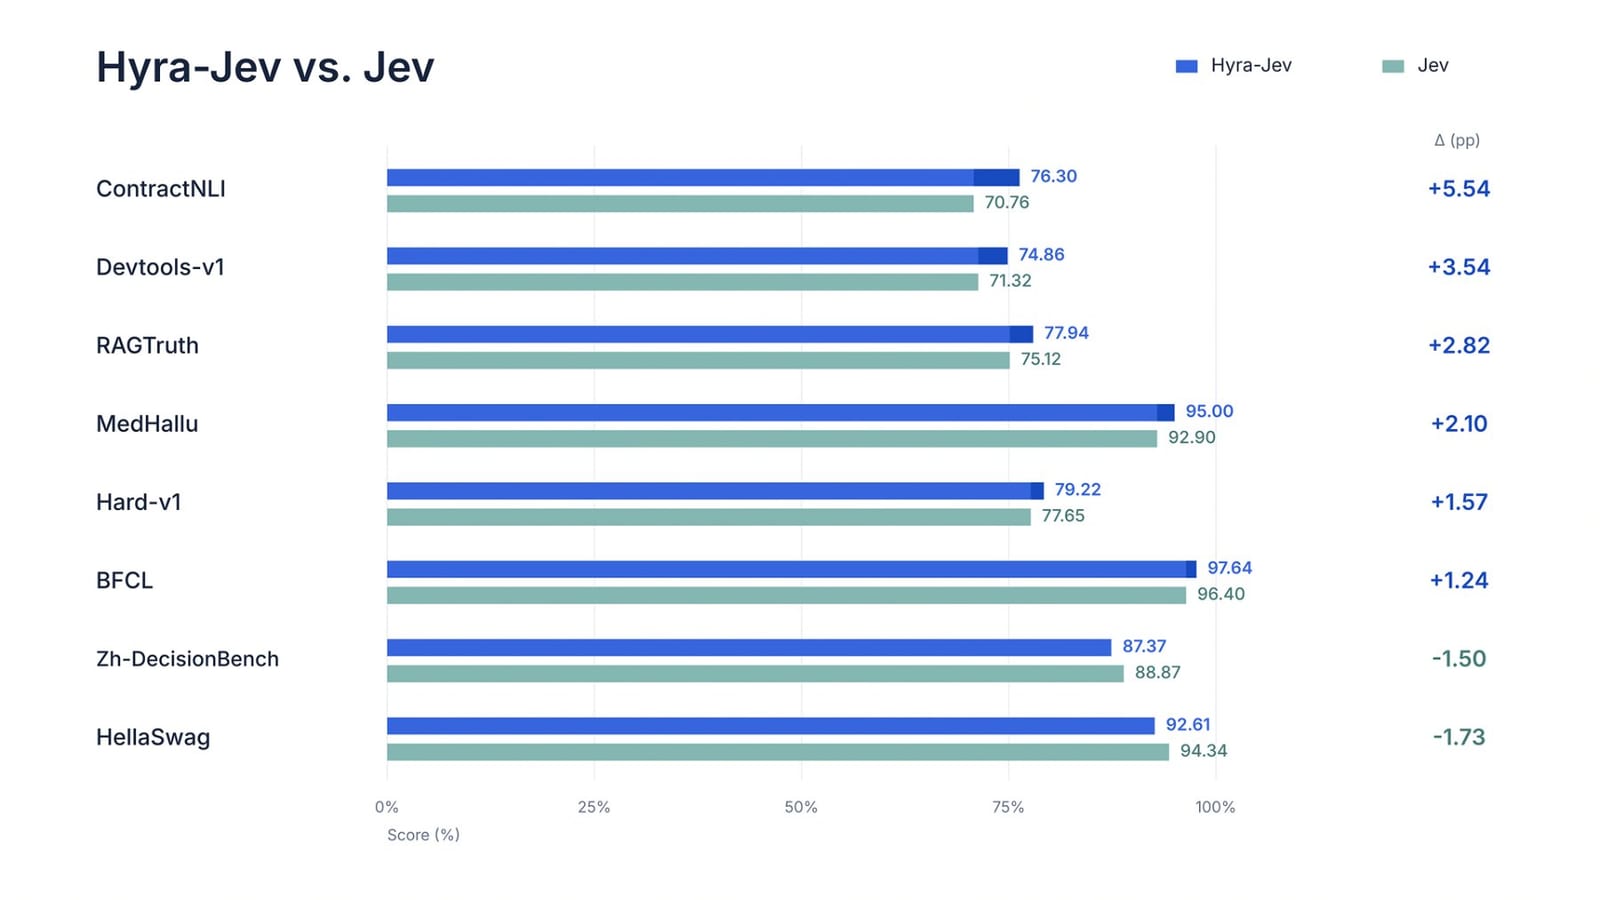
未来,Hy4 的目标是支持并加速公司内部的进一步 AI 开发。
安全性、定价和承认的弱点
考虑到计划的权重发布,腾讯强调了安全性。该公司表示,在训练过程中有意过滤掉了与黑客相关的材料,腾讯自己的安全实验室发现没有滥用风险增加。该模型也远低于腾讯对生物危害的风险阈值。详细的 safety 报告将与模型权重一起发布。
尽管有所改进,但腾讯的收费与预览版相同。一百万个输入 token 的成本约为 0.83 美元,一百万个输出 token 的成本约为 2.50 美元。然而,该公司承认,Hy4 在高级数学、较长的编码项目和复杂的图像分析等复杂任务上仍然远远落后于最好的商业模型。下一个计划是推出一个更快、更便宜的 Hy4 flash 版本。
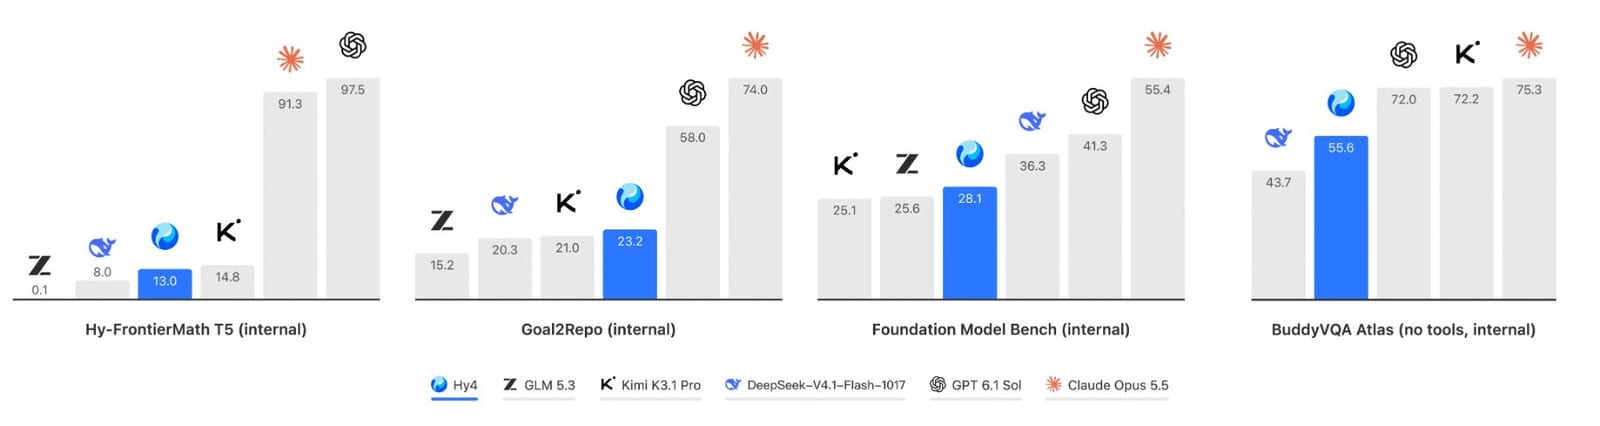
腾讯去年七月在 Apache 2.0 许可下发布了拥有 2950 亿参数的 Hy3。自那时以来,中国竞争对手已经取得了进展。智谱 AI 发布了 GLM-5.3,深求发布了 V4.1-Flash-1017,而摩尔线程推出了 Kimi K3.1 Pro。人工智能分析 在十月底进行了更新,其中 60% 的内容基于私有测试集。开源模型与顶尖模型的差距从 3 分扩大到 12 分。
Hy4 权重的计划发布正值规则收紧之际。中国商务部和科技部去年十月发布了一个 草案出口管制框架,该框架将涵盖全球排名前 10 的任何模型或超过 2 万亿参数的模型权重。然而,对于开源发布,草案包括一个快速通道流程,可自动批准。
AI 新闻,无浮夸之词 – 由人类编辑
订阅 THE DECODER 以享受无广告阅读、每周一份的 AI 新闻简报、我们独有的每年六次的 "AI 雷达" 前沿报告、完整档案访问权限以及访问我们的评论区。
来源: The Decoder · the-decoder.com