跳到正文
实时

开源生态 · 页 2

11月5日周四21–40
  1. IT之家 · AI74

    百度文心开源发布 ERNIE 5.5 Flash Base 基座模型,总参数 280B

    百度文心发布 ERNIE-5.5-Flash-Base 并开放 ERNIE 5.5 Flash 预训练终点权重,这是一个总参数 280B、每 token 激活 14B 的稀疏 MoE 语言模型,在 33.5T tokens 上从零预训练,微调与推理支持 1M tokens 上下文。

    推荐理由: 原文给出 280B 稀疏 MoE 基座的参数、训练数据量与开源权重,读者可据此判断其作为微调起点的适配空间。

  2. AWS Machine Learning Blog60

    生产级 AI 智能体的四层上下文工程:Deep Insight 在可运行代码中的实践

    AWS 团队以开源多智能体数据分析方案 Deep Insight 为参考实现,把生产级 AI 智能体的上下文工程拆成四层:多智能体架构隔离上下文、用提示词限制输出、把重内容外置到文件系统、用验证智能体与兜底机制把关。

    推荐理由: AWS 团队把上下文工程拆成四层,并给出开源参考实现中的具体代码与 token 节省数据,可直接对照改造自家 Agent。

  3. vLLM Blog75

    vLLM 为 Kimi K3.1 Pro 提供 Day-0 支持

    vLLM 宣布在 NVIDIA、AMD、Google TPU 和阿里平头哥真武 PPU 上 Day-0 支持月之暗面开源的 Kimi K3.1 Pro,该模型为 2.8T 参数(104B 激活)多模态 MoE,上下文 1M token。

    推荐理由: vLLM 团队详述为 Kimi K3.1 Pro 做 Day-0 适配的工程取舍,含稀疏注意力、KV 缓存打包与 DCP 的具体数字。

11月4日周三
  1. OpenHands Blog71

    OpenHands 与 Snowflake 推出用自有 Agent harness 后训练模型的工作流

    OpenHands与Snowflake AI Research合作,让开发者用现有的OpenHands Agent harness直接进行强化学习后训练,无需在训练框架中重建harness。

    推荐理由: 原文给出了用现有 Agent harness 直接做 RL 后训练的具体配置方式和代码定位实验,读者可据此判断训练与部署能否共用一套 harness。

11月3日周二
  1. Anthropic Research62

    Anthropic 发布可验证推理系统 FlashProve,单张 H100 上约 110 tokens/秒生成证明

    Anthropic 公布可验证推理原型 FlashProve,用 zkSNARK 证明响应确实来自所承诺的模型权重。对 400B 参数的 Llama 4 Maverick(4-bit 量化),单张 H100 生成证明约 110 tokens/秒,每 1,024 token 请求的证明约 19 MB,验证在 24 核 CPU 上约 17 秒。

    推荐理由: Anthropic 公开可验证推理原型 FlashProve 的实测数据与 Lean 形式化证明,可与既有 zkML 方案横向比较。

  2. The Decoder73

    50 个 AI 智能体在 Minecraft 中自发形成官僚式协作

    研究团队将 50 个 GPT-6.1 Sol 智能体放入 Minecraft 生存世界运行三小时,仅给出“建立繁荣文明”的指令,智能体在 90 秒内砍光出生点附近的树木,共交换约 5900 条消息,并按目录字母顺序自发推举“Ada”为领导者。

    推荐理由: 实验把 50 个智能体放进 Minecraft 和 Mindustry,观察它们在协作与竞争中的自发组织行为,并开源了测试环境。

11月1日周日
10月31日周六
  1. MarkTechPost72

    Vercel Labs 开源 agent-desktop,让智能体通过系统无障碍树操作桌面应用

    Vercel Labs 发布开源 CLI 工具 agent-desktop,让 AI 智能体在 macOS、Windows 和 Linux 上通过操作系统无障碍树读取并操作原生应用,而非依赖截图。

    推荐理由: 原文对比了基于无障碍树的 agent-desktop 与截图式 computer use 在 token 消耗和光标占用上的差异,并给出自报数据。

  2. 量子位78

    面壁智能 ForgeKernel 直播从零生成算子,比 DeepSeek FlashMLA 快 9.8% 并宣布开源

    面壁智能的算子生成系统 ForgeKernel 在英伟达 B200 上从零生成 DeepSeek-V4.1 的 FlashMLA Prefill 算子,最终耗时 472 微秒,比 FlashMLA 的 518 微秒快 9.8%,全程 22.5 小时、42 轮迭代、32 个版本,使用 1 张 B200 和 22 个 GPU 小时。

    推荐理由: 原文给出直播全程的迭代数据与昇腾三榜成绩,可据此判断算子生成从人工调优转向智能体自进化的路径。

  3. 量子位72

    智元发布GO-3 Preview与WITA-OMNI双模型并推出Worken工时单位

    智元在创新日发布具身基座模型GO-3 Preview和全模态交互大模型WITA-OMNI,前者在RoboDojo、RoboTwin、RoboColiseum三榜登顶,后者在Daily-Omni、TimeLens-Bench、EmbSpatialBench、MMAU四榜居首。

    推荐理由: 智元一次性给出双模型榜单成绩、三智合一硬件与开源OS计划,可对照其产线实测数据判断落地程度。

10月30日周五
  1. IT之家 · AI78

    小米开源 0.8B 文档理解模型 Xiaomi-OCR-0,支持 Markdown 与 JSON 输出

    小米开源轻量级文档理解模型 Xiaomi-OCR-0,参数规模 0.8B,权重与推理代码已上线 Hugging Face 和 GitHub,单一模型覆盖文档解析、关键信息抽取与 OCR 视觉问答三类任务。

    推荐理由: 0.8B 参数在 OmniDocBench v1.6 上位列总榜第二,且权重、MCP 服务与 Skill 工具包一并开放,可据此判断小模型做文档解析的边界。

  2. IT之家 · AI74

    Qwenputer 问世:把 RISC-V CPU 指令集塞进模型,AI 算数不再靠外部工具

    开发者 Divyansh Agrawal 于 10 月 22 日发布实验性模型 Qwenputer,基于阿里 Qwen3.5-4B 构建,在神经网络内部实现 32 位 RISC-V CPU 与内存功能,无需调用 Python 等外部工具即可执行程序和精确计算。

    推荐理由: 开发者将 RISC-V 指令集编译进 Qwen3.5-4B 权重,用具体基准数字展示了模型内计算的精度提升与体积、速度代价。

  3. IT之家 · AI78

    智元发布具身模型 GO-3 Preview,登顶三大榜单并计划 2026 年底开源

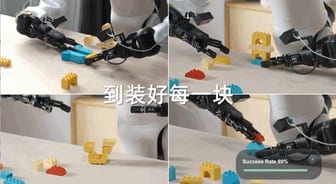
    智元于 10 月 29 日推出具身模型 GO-3 Preview,采用具身原生的 WRAM 架构,把任务推理、未来预测与动作生成连接起来,并已登顶 RoboDojo、RoboTwin、RoboColiseum 三大评测榜单,计划 2026 年底全面开源。

    推荐理由: 原文给出便利店真机任务成功率从 28.6% 到 85.7% 的部署后数据,可观察具身模型在线自我改进的路径。

  4. Epoch AI88

    Epoch AI:GLM 5.3 可利用补丁空窗期攻破多个 Firefox 版本

    Epoch AI 实验显示,Z.ai 于 8 月发布的开源权重模型 GLM 5.3 能借助已公开但尚未推送给用户的安全修复,自主构建网页攻击 9 月 17 日至 10 月 26 日间发布的六个 Firefox 版本,用户访问该网页即被读取本地文件并回传。

    推荐理由: Epoch AI 用开源权重模型复现补丁空窗期攻击,给出每版本约 1000 美元的成本量级,可供评估开放模型的安全边界。