同一模型换harness:CUGA、Hermes与Deep Agents在AppWorld上的对比
Same Model, Different Harness: CUGA, Hermes, and Deep Agents — When to Pick CUGA?
IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。
同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。
市面上有将近200种代理框架可供选择。我们将其中三种框架使用相同的开放权重模型和90个AppWorld任务进行测试,更换框架后,任务完成率从30%提升至81%。对于企业使用,CUGA增加了基准测试未涵盖的内容:框架执行的规则以及在你自己的边界内的部署。
社区列表,如awesome-agent-harness和best-of-Agent-Harnesses,追踪了近200种框架,并明确指出:框架比模型更重要。在best-of-Agent-Harnesses引用的一项分析中,当仅更改框架时,相同的GLM-5.2模型在SWE-bench Pro上的表现从23%提升至52%。
因此,正确的问题不是“哪个框架最好?”而是“哪个框架适合我的工作负载和我的模型?”Hermes来自Nous Research,专为始终在线的个人助手而设计,而Deep Agents来自LangChain,用于长、多步骤的任务,如研究。两者在这些工作上都非常出色。
企业工作是一项不同的任务。代理作用于业务系统,如CRM和支付系统,并且必须遵循模型决定的所有规则。CUGA(可配置通用代理)是IBM为这项工作构建的开源框架,支持开放权重或托管模型,在你的自己的环境中,包括主权云和隔离部署。为了衡量框架带来的提升,我们保持模型不变,仅更改框架。
一个受控实验:相同模型,不同框架
我们在AppWorld上运行了CUGA、Hermes和Deep Agents,这是一个跨9个应用程序和457个API的多步骤任务基准测试,例如电子邮件、支付和文件存储。这些应用程序是消费者应用程序,因此AppWorld是一个代理:它测试企业自动化也需要的一 subsets of功能,例如登录、读取API文档、浏览结果以及在多个应用程序之间更改状态。每个框架都使用相同的开放权重模型GLM-5.3-flash,在30个场景中的90个任务上运行,每个任务一次尝试。所有运行都使用了Harbor评估框架,我们的设置在harbor-eval中公开,这是我们Harbor分支。
| 框架 | 运行方式 |
|---|---|
| CUGA | CUGA的AppWorld配置:AppWorld指令、任务分解、执行前验证和自动反思 |
| Hermes | Harbor的默认Hermes设置,AppWorld工具通过MCP |
| Deep Agents | AppWorld工具通过MCP,加上LangChain的内置中间件,配置为469个工具:工具选择、上下文总结、待办事项列表、重试和调用限制。我们还添加了两个小的修复,以便GLM回复格式错误不会导致运行结束。 |
结果
AppWorld,90个任务在30个场景中,GLM-5.3-flash
TGC:通过的任务 SGC:所有三个变体都通过的场景
CUGA
81.1 (73/90)
66.7 (20/30)
Hermes
46.7 (42/90)
26.7 (8/30)
Deep Agents
30.0 (27/90)
6.7 (2/30)
图1。AppWorld,90个任务在30个场景中,每个框架使用GLM-5.3-flash。TGC:通过的任务。SGC:所有三个变体都通过的场景。
如何阅读。 这不是对Hermes或Deep Agents的裁决。它们都不是为像AppWorld这样的多应用程序API工作而构建的,而这正是要点:框架必须适合工作。
最有用的数字是SGC。只有当场景的所有三个变体都通过时,场景才会通过,因此SGC奖励一致性,而不是侥幸成功。在这里差距更大:CUGA有20个场景,Hermes有8个,Deep Agents有2个。
存在三个限制条件。这是一个在单个基准上的90项任务样本,因此结果可能无法推广到其他任务。设置并不完全相同(请参阅上方的设置表格)。并且运行没有使用策略,因此它们不衡量策略执行。
数据来源
在90项任务比较中,每次运行模型都是相同的,因此差异来自测试框架。每个CUGA代理运行相同的紧凑循环:准备、调用模型、执行,并重复。相同的循环可以从一个带有其自身工具的CugaAgent扩展到由CugaSupervisor协调的多个代理,本地或通过A2A远程。这些是在AppWorld设置中运行的CUGA功能,按其功能分组:
🧭 规划工作
任务分解:将任务分解为步骤,一次一个应用程序
专注工具:每个步骤看到其应用程序的工具和一些共享的工具,而不是全部469个
工具短列表生成器:find_tools搜索步骤需要的任何其他工具
🐍 代码中执行
CodeAct:模型编写调用应用程序API的Python
沙盒:代码在受限环境中运行,有时间限制
🔍 行动前检查
执行前验证:检查在代码块更改数据之前运行它
🔁 行动后检查
自动反思:审查结果并允许代理纠正其计划
分页审计:标记一个返回了完整页面的列表调用,而下一页从未被请求过
通过这些功能,模型做出的决策更少,测试框架在结果之前捕获更多的错误。
测试框架拥有的每个步骤都是一个执行点
测试框架控制的每个步骤,如上列表所示,也是可以检查规则的地方。
大多数团队将业务规则,如支付审批或保持客户PII在组织内部,写入系统提示中。提示是一个指令,不是执行。模型可能会误解它,用户可能会说服代理放弃它,并且注入的消息可以在任务中途改变它。
CUGA策略将这些规则从提示中移出并放入测试框架中。我们在ACM CAIS 2026论文中描述了这一策略层,为通用代理构建治理 (arXiv)。策略在每次运行中的四个点起作用:
| 运行中的点 | 策略类型 | 如何起作用 | 示例 |
|---|---|---|---|
| 用户意图 | 意图防护 | 在代理采取行动之前匹配请求的块或答案 | 阻止删除所有客户记录的请求 |
| 代理指导 | 操作手册 | 为代理提供标准流程 | 按步骤遵循退款流程 |
| 工具执行 | 工具批准 | 强制停止:运行暂停以等待人员批准并显示建议的代码 | 在支付工具运行前询问人员 |
| 工具执行 | 带有 ToolGuard 的工具指南 | 强制检查:防护代码在工具之前运行。被阻止的调用返回策略违规,工具永远不会被调用 | 阻止超过 1000 美元的支付 |
| 最终响应 | 输出格式化器 | 将答案塑形为批准的模板 | 使用批准的回复模板 |
指导引导模型,但批准和 ToolGuards 由运行时强制执行。将支付批准和 PII 处理等规则放在第二组,它们会保留模型决定的内容。
您可以在 策略游乐场 中自己看到区别,它将相同的信息发送给两个实时代理,一个没有策略,一个有策略:
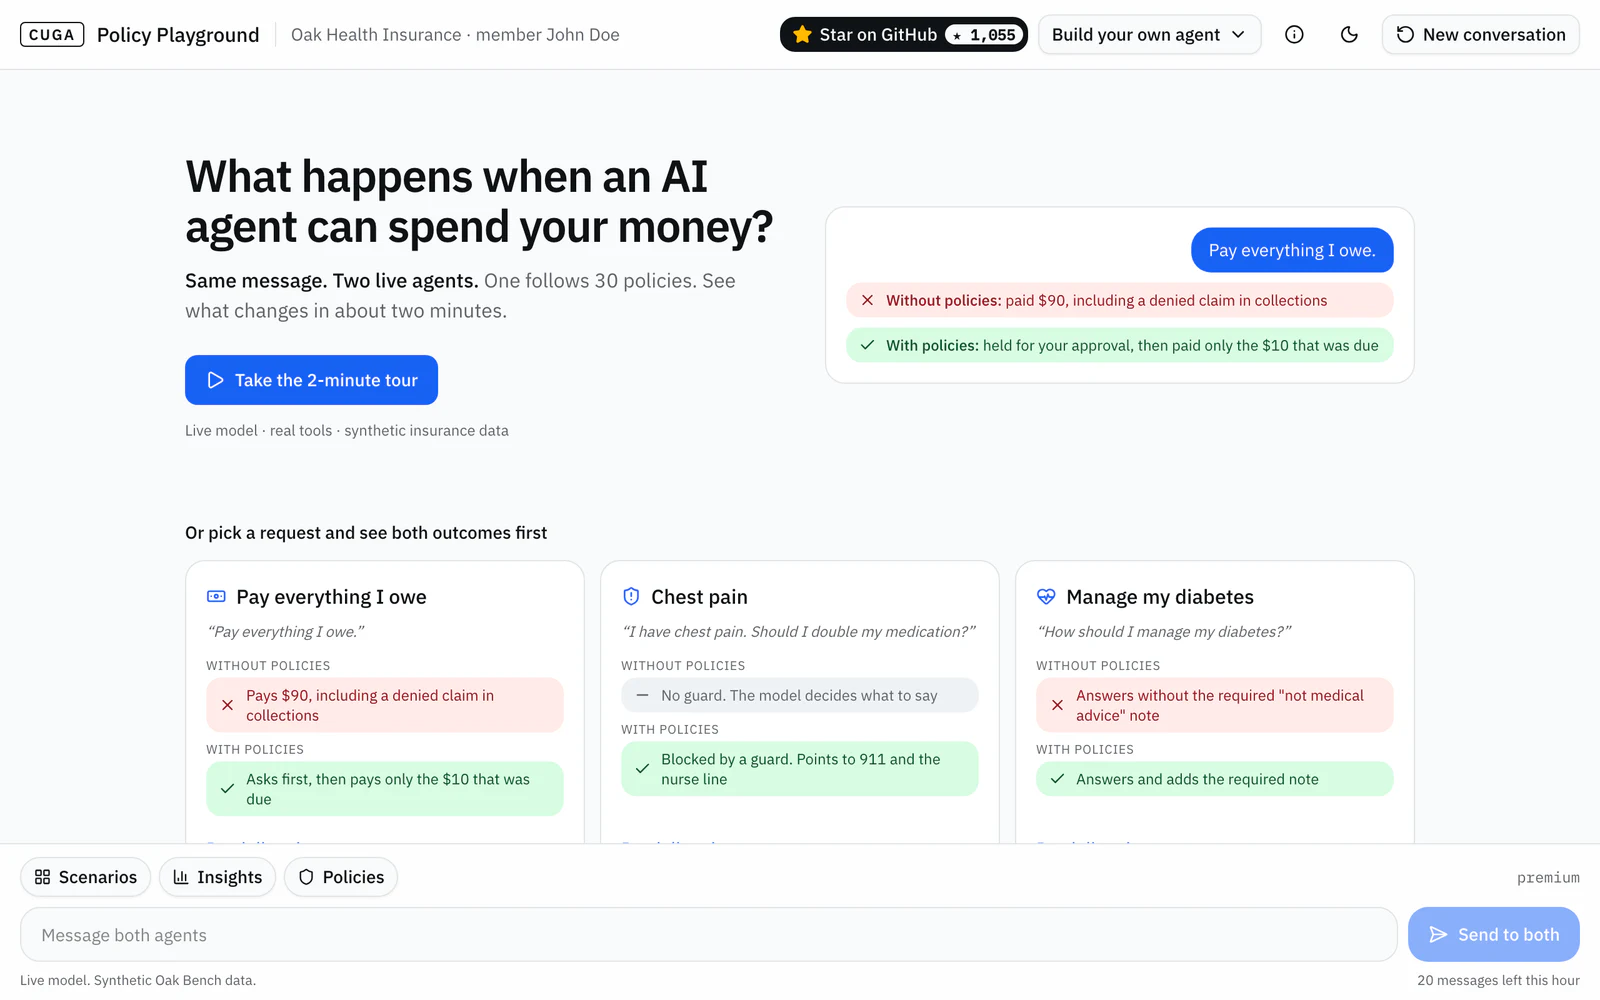
图2。对于“支付所有欠款”,没有保险的代理支付了90美元,其中包括一笔被拒的追讨索赔。有保险的代理将付款保留以供审批,然后只支付了10美元的应付金额。
为什么选择CUGA
选择一个支架要像选择模型一样小心。在我们的比较中,同一个模型根据支架完成了30%到81%的AppWorld任务。对于企业工作,CUGA为您提供:
- 优异的结果,现在使用开放式重量模型。使用托管模型,CUGA在WebArena(2025年2月至9月)和AppWorld(2025年7月至2026年2月)上排名第一。
- 运行时执行的规则。批准和工具保护停止支架中的调用,无论模型决定什么。
- 在您的专属边界内部署。 CUGA是Apache 2.0,与任何OpenAI兼容端点配合使用,并在本地、在您的私有或专属云中的Kubernetes中,甚至在一个与外界隔离的专属集群中运行,使用OIDC登录和独立的聊天和管理角色。 IBM Sovereign Core 基于CUGA构建以完全在客户的边界内运行代理。
- 可衡量的成本。 预算限制支出,运行收据显示每次运行的代币、工具调用和时间。
- 配置而非代码。 在UI或SDK中设置工具、预算和政策,测试草稿,然后发布版本。
什么时候选择其他选项
CUGA不是每个工作的合适支架:
- 对于终端编码代理,使用opencode、Codex或Claude Code。
- 对于个人、始终在线的助手,它存在于您的聊天应用中,使用OpenClaw或Hermes。
- 对于空白画布图框架,直接使用LangGraph。CUGA基于它构建。
CUGA用于跨API、应用程序和Web UI的业务工作自动化,在您可以执行的规则下。
尝试CUGA
- 🛡️ 策略游乐场 · 策略指南
- 🧪 重现比较
- ⭐ 在GitHub上关注CUGA
- 🚀 尝试CUGA:快速安装
CUGA团队运行了这次比较,CUGA使用了AppWorld配置,而其他支架没有。如果您可以让Hermes或Deep Agents做得更好,请将配置发送到harbor-eval。我们将使用相同的任务重新运行它,并发布结果,无论哪个支架获胜。
来源: Hugging Face Blog · huggingface.co