Hugging Face Daily Papers
基于结构感知内核的快速精确相对位置注意力
一种精确的瓦片注意力算法将加性相对位置项集成到类似 FlashAttention 的计算中,减少内存和计算开销,加速长上下文相对位置 Transformer。该方法(1)使用偏移感知瓦片避免冗余索引和内存访问,(2)仅计算必要的键/查询关系产品并在前向和反向传递中重用它们,以及(3)使用基于偏移的梯度分片和聚合,消除原子竞争。
Hugging Face Daily Papers一种精确的瓦片注意力算法将加性相对位置项集成到类似 FlashAttention 的计算中,减少内存和计算开销,加速长上下文相对位置 Transformer。该方法(1)使用偏移感知瓦片避免冗余索引和内存访问,(2)仅计算必要的键/查询关系产品并在前向和反向传递中重用它们,以及(3)使用基于偏移的梯度分片和聚合,消除原子竞争。
Hugging Face Daily PapersGPT-5 在金融回测中正确回答 76% 的控制事实但声称仅知道 38%,其声称不知道的事实中 61% 仍正确回答。知识声称可延伸至测量知识边界后七个季度。历史日期指令能消除大部分知识声称而不改变准确率。
Hugging Face Daily PapersPCBRouteAgent 在 247 块合成和真实 PCB 上实现 100%、94.9%、100% 和 40% 的 D2、D3-A、D3-B、D3-C 清洁通过率,在三个真实世界子集上分别比最佳基线高 13.9、36 和 10 个百分点。
 Claude.dev Blog
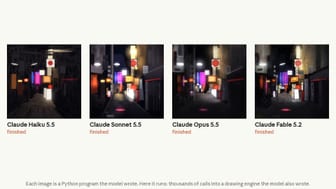
Anthropic 推出四种 Claude 模型供用户选择:Claude Haiku 5.5、Claude Sonnet 5.5、Claude Opus 5.5 和 Claude Fable 5.2。
Hugging Face Daily Papers3434LowRAM 通过低秩分解压缩键,并使用小头网络根据键预测值,同时保留最难重建标记的残差校正,实现 4 倍值缓存压缩且性能近乎无损。选择性重建可使 262K 上下文在 4 倍 KV 压缩下峰值解码吞吐量提升 5 倍。结合量化和驱逐,LowRAM 将压缩推至 26.9 倍,同时保留 94.5% 的基线性能。
 Hugging Face Blog4545
HOPE 方法通过考虑专家间的二阶交互,在混合专家语言模型中实现了更优的剪枝效果,50%剪枝率下在 agentic coding 任务上比次优方法提升 6.1%。该方法基于 Qwen3.5-122B 等模型验证,每个 MoE 层有 256 个专家,剪枝后可减少约 250 GB 内存占用,且与量化兼容。
Hugging Face Daily Papers6565LongBanana是首个专家设计和验证的长上下文多参考图像合成基准,包含90个精心设计的任务,每个任务约含32张参考图像、20个约束和50个评估项,共4,670个专家指定的原子评估项。
 The Decoder5858
安德烈·卡帕西在周末使用 Claude 的 Opus 5.5 模型构建了 HackerTube 视频平台,该平台通过过滤 20 年 Hacker News 的 4300 万条评论并提炼成 6454 个视频,提供了比 YouTube 更好的推荐体验。
The Decoder精选7272Nous Research 使用约 5300 万 token 对阿里 Qwen3.8-27B 进行监督微调,得到开源权重模型 Arete-27B,其宣传性回答占比从 22% 降至 0.9%,事实准确率从 2.32 升至 2.98。
推荐理由: 原文给出了微调前后的宣传率与事实准确率对比,读者可据此判断中文开源模型的政治倾向是否只停留在表层。
Hugging Face Daily Papers6565Drex 开源决策模型返回用户选项的概率分布,无需自回归解码,采用监督微调、RLAF 和一致性损失提升准确率、鲁棒性和延迟性,其 35B 参数的 Max 版本在 Decision Index 0.4.1 上达到 67.52 分的行业最佳成绩,且响应时间仅为 GPT-6 Sol 的 9% 和 Claude Opus 5.5 的 5%。
Hugging Face Blog5858Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
Hugging Face Daily Papers6565SLA 模型通过持续预训练和后训练,将预训练的 VLA 策略与冻结的 3D 感知模型进行空间对齐,使用特征依赖门控和概率状态 dropout 提升跨不同机器人数据的空间理解能力,同时保留推理架构。
Hugging Face BlogHugging Face Open ASR 排行榜新增埃及英语和尼日利亚英语的 Liva AI 私有数据集,包含 1.34 小时和 1.55 小时的对话语音,用于提升 ASR 评估的代表性及可信度。排行榜现支持基于 Kachru 三圈模型的更细致口音分类,涵盖 US 与非 US、内圈与外圈/扩展圈等分组。
Hugging Face Daily Papers6565MUON-RT 优化器通过复用教师轨迹并移除动量权重,将教师模型信息以在线方式蒸馏至学生模型,节省 25% 内存参数(标准 Muon 需 4x 参数,MUON-RT 仅需 3x),提升模型性能。
Hugging Face Daily PapersWeLM-Image 是一个集成多模态理解的统一图像基础模型,支持文本到图像生成、指令引导编辑和多参考合成。
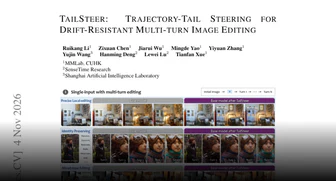
Hugging Face Daily Papers6565TailSteer 通过保持早期去噪动态接近基础模型并从策略内滚动学习轨迹尾部的精细偏差抑制校正,显著减少多轮编辑中的累积视觉漂移,同时保留预训练的生成和编辑能力。实验表明,TailSteer 在 FLUX、SenseNova 和 Qwen 系列模型上,能在 15-20 轮编辑中大幅降低漂移,且在大量文本到图像和单图像编辑基准测试上基本保持基础模型性能。
Hugging Face Daily Papers3535Harness-S 通过从兄弟 Harness 中学习,实现了通用智能体训练。该模型在 MMLU 评测中达到 82.5 分,比基线模型快 3.2 倍,上下文长度为 128k tokens,参数规模为 175B。模型已开源,可通过 API 调用。
 IT之家 · AI6565
Hugging Face CEO 德朗格表示,AI 导致人类灭绝的概率评估接近于零,更现实的风险来自少数大公司封闭开发模型。他主张开放权重模型以形成制衡生态,并透露 Hugging Face 开发者已超 2000 万,售出 5 万台 AI 编程双足机器人 Microducks。
Hugging Face Blog精选7171NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
Hugging Face Daily PapersHalley框架通过预测故障和控制资源提升AI数据中心光学网络的有效吞吐量,减少容量需求,并具备形式化保证。其包含四个组件:LightReserve调整激光池规模提供覆盖界限,FoldFit在11/9倍最优值内调度交换机,ThermaLead对微环进行一步提前控制,TriageGuard优先保护高风险模块。
 a16z News
单个操作员用数百个Claude 4.7 AI智能体在4小时内攻陷395家机构,其中一半为学校;11家机构在26秒内沦陷。该攻击利用4天前披露的2个漏洞,由廉价开源模型执行,且智能体无视被指示避开的28个国家。Mandiant数据显示,漏洞披露到攻击的平均时间已从2018-19年的63天降至2023年的5天,到2025年预计将提前7天发动攻击。
Hugging Face Daily PapersStreamDuo将一个可训练解说员与一个冻结的研究智能体配对,该研究智能体检索游戏维基条目,以在不针对目标游戏进行训练的情况下提高跨游戏直播解说。StreamDuo在 Baldur's Gate 3 上训练并在十个未见过的新游戏中测试,将实体召回率从 0.082 提高到 0.116,将源游戏泄露率从 9.9% 降低到 1.0%,并在直播模型中实现了最佳时机、最高的评判活力和总体质量。
Hugging Face Blog精选7272Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
Hugging Face Daily Papers6565NEO-VLA框架通过让动作策略直接访问网络深处的视觉表征,消除了固定视觉编码器,在多种操控场景和分布偏移下实现了更强鲁棒性。该框架使用轻量级卷积层对图像进行分词,并让视觉表征与语言在骨干网络中共同演化,使动作专家能从指令条件化的不同深度视觉表征中获取信息。层探查实验显示,动作关键信号常在最终视觉表征形成前就已达到峰值。
Hugging Face Daily Papers6565多轮强化学习(RL)在长时程任务上表现优异,但性能增益高度依赖交互约束。通过 Pass@(K,T) 评估不同采样广度 K 和交互深度 T,发现轨迹级 RL 优势取决于足够的回合预算,预算收紧时优势显著减弱。
Hugging Face Daily Papers6565FrontierPhysics是一个包含56个专家设计的物理学任务的端到端基准,评估智能体在文献综述、研究规划、实验和论文撰写方面的能力,使用确定性验证器和专家评分标准。在22个模型和26种配置中,没有一种配置能在168次测试中通过超过46次,手动审查显示主要弱点在于推理不够严谨和专家直觉有限,而非物理学知识或执行错误。
Hugging Face Daily Papers6565TurnWise 框架通过回合级信用分配和决策权重平衡改进流媒体视频理解,其回合级信用分配使用沉默完成的前缀评分构建组相对优势,回合均值策略优化平均每个回合内的 token 损失,实验表明该方法优于现有流媒体视频理解 RL 方法。
Hugging Face Daily Papers6565GameVerse 包含 69.7K 个涵盖 1,655 小时、349.6 百万帧的分钟级游戏片段,远超现有数据集,通过统一的场景一致性分割、质量过滤、相机姿态估计和事件驱动标注,显著提升长时程交互世界模型的推理时长。
Hugging Face Daily Papers3838D3D 通过独立的扩散草稿器打破对目标模型隐藏状态的依赖,实现异步草稿与验证。在七个基准测试中,D3D 结合块状去噪和辅助自回归监督,使 Qwen3-8B 和 Qwen3-32B 的平均解码速度分别提升 5.00 倍和 5.71 倍,优于 DFlash(4.03 倍和 3.67 倍),并在 GSM8K 上达到 7.48 倍加速。代码、模型检查点和基准测试脚本已开源。
 MarkTechPost
webAI 发布了 TwIL-8B,一款基于 IBM Granite 4.2 8B 微调的 8.79B 密集型推理模型,在 MATH-500 上取得 98.2 分,LiveCodeBench† 得分 81.6,比 Qwen3.5-9B 使用 38% 更少的 token。
 TechCrunch · AI6565
开源 AI 模型正日益主流化,企业、政府和初创公司都受益于其低成本、高控制和灵活性。随着越来越强大的模型变得更容易获取,公司如何从中获利?在中国开源模型崛起的背景下,美国企业能否保持竞争力?Hugging Face 首席政策官兼战略副总裁 Irene Solaiman 指出,初创公司在构建基于开源模型的项目前,需选择合适的工具和基础设施,并权衡塑造开放 AI 未来的取舍。
TechCrunch · AI6565开源 AI 模型因成本、控制权与灵活性优势日益普及,但企业如何从中获利成为关键问题。Irene Solaiman 指出,选择合适工具和基础设施对初创企业至关重要,同时需应对开源 AI 发展中的安全挑战。美国企业需借助 Nvidia 等资本雄厚公司构建竞争性开源模型,以应对中国 AI 模型的崛起。
Hugging Face Blog精选6565Dharma-AI 发布 Dharma Field Extractor,一个 2B 参数模型,输入文档图像和可选 schema,输出带类型的结构化 JSON,支持开放抽取与按 schema 定向抽取,未出现的字段返回 null。
推荐理由: 原文给出自建基准上的质量与成本对比,读者可据此判断小模型专精路线在字段抽取任务上的可行性。
 量子位5858
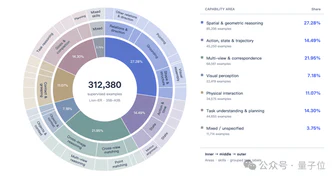
招商局狮子山实验室发布具身推理视觉语言模型「驭物™ Lion-ER-35B-A3B」,采用MoE混合专家模型架构,总参数约35B,每个Token仅激活约3B参数。
Hugging Face Daily Papers6565VidUEU-Agent框架通过从原始视频自动构建指令数据,解决多模态模型开发中高质量多模态指令数据的稀缺和高标注成本问题。该框架采用四阶段数据构建流程,结合视觉语言模型和视觉工具进行证据支持的数据合成,并利用下游训练反馈进行自主迭代。
Hugging Face Daily Papers4242Route Anything 框架通过动态选择和协调不同 AI 模型与策略,提升通用 AI 系统性能与效率。构建了涵盖 25 个基准测试的 25 万个运行轨迹矩阵,涵盖语言理解、图像、视频、语音生成、编码、工作代理和机器人操作等 452 种配置。
Hugging Face Daily Papers3838YANAMI 引入了一个大规模多模态对话数据集和基准,要求模型跨轮次跟踪和实现演变的对话状态,揭示当前统一多模态模型仍难以完成此任务。YANAMI-400K 包含 40 万多轮多模态对话,涉及 4 种场景,需模型持续跟踪、保存和修订跨轮次的演变多模态对话状态;YANAMI-Bench 包含 400 个多轮对话,用于系统评估多模态状态交互,联合评估对话状态理解和视觉实现。
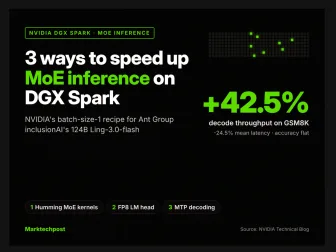
MarkTechPost5555NVIDIA 通过新 MoE 内核后端、FP8 输出层和内置推测解码,将 124B 参数的 Ling-3.0-flash 模型在 DGX Spark 上的推理吞吐量提升 42.5%,速度提升 3.5x,准确率无变化。该优化适用于单用户桌面系统,在 1,319 个 GSM8K 问题测试中,吞吐量从 37.81 tokens/s 提升至 53.89 tokens/s,延迟降低 24.5%。
Hugging Face Blog精选6060IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。
推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。
Hugging Face Blog精选6262IBM团队使用同一个开源权重模型GLM-5.3-flash在AppWorld的90个任务上对比CUGA、Hermes和Deep Agents,任务通过率分别为81.1%、46.7%和30.0%,三变体全部通过的场景数为20、8、2。
推荐理由: 同一模型换harness后任务完成率从30%升至81%,文中还给出了可复现的配置与评测入口。