PyTorch Blog3030
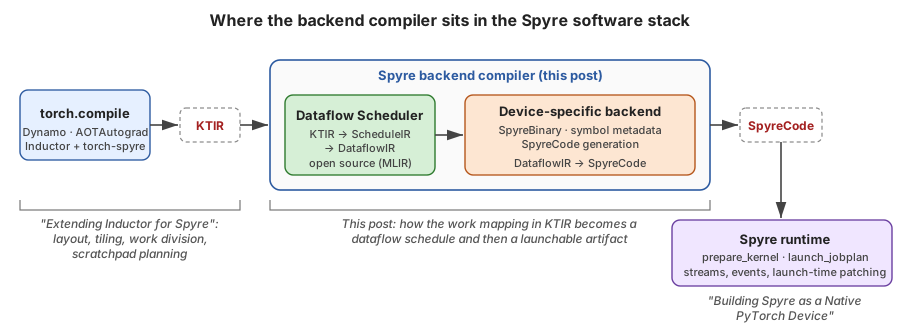
从 KTIR 到 SpyreCode:为 IBM Spyre 开发 MLIR 数据流后端
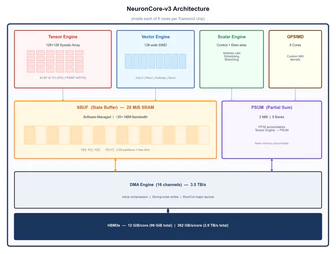
Torch-spyre 的 Inductor 决定每个内核的工作如何在 Spyre 的核心上分配,并管理张量在片上 Scratchpad 和片外内存之间的驻留,而后端编译器将这些决策转换为硬件可以实际运行的指令。
PyTorch Blog3030Torch-spyre 的 Inductor 决定每个内核的工作如何在 Spyre 的核心上分配,并管理张量在片上 Scratchpad 和片外内存之间的驻留,而后端编译器将这些决策转换为硬件可以实际运行的指令。
 量子位5858
千诀科技发布预测式世界模型Polibrain,比LeCun团队相近研究早一年。该模型通过多项式表征和因果记忆技术,让机器人学会根据物理世界变化自主决策,已在四足、人形、轮式等机器人形态上适配。Polibrain采用松耦合架构,将环境理解与动作执行分离,支持跨本体复用,为不同机器人提供智能能力。
 The Decoder
OpenAI联合PerturbAI和Scripps Research部署数千个AI代理,在GPT-Rosalind上分析来自数百万老鼠细胞的生物数据,完成全脑CRISPR图谱分析耗时32分钟,而人工分析需数月至一年;人类专家在盲测中75%时间内更偏好分布式代理的报告;"推理图谱"已开源至GitHub,相关论文发布在bioRxiv。
 MarkTechPost
Perplexity 与 NVIDIA 联合推出 JOLT,一种语言模型后训练方法,通过联合在线学习和教学,用单一模型同时扮演师生角色,教师模型接受特权信息并接受 KL 惩罚以接近学生模型,学生模型通过教师模型的 token 级别蒸馏信号学习。
 Hugging Face Daily Papers6060
WildAWM 通过交互合成可控的计算机环境与任务,提升通用智能体在 Web、CLI 和 GUI 基准测试中的泛化性能。该系统支持图形界面、模型上下文协议服务及命令行界面,完全基于开源模型,并引入基于执行的关卡机制解决任务合成中的可解性、难度维持和验证器可靠性问题。Qwen 模型在 WildAWM 合成环境中训练后,在 8 项跨分布基准测试中取得显著提升。
Hugging Face Daily Papers6565研究通过在数据规模、多样性和模型大小三个维度上进行持续预训练(CPT),提升了虚拟世界中的具身智能体学习能力,但在远距离世界泛化上存在局限。研究测试了涵盖 0.8B 至 27B 参数、50 至 1600 小时数据预算、五种数据混合的 120 种配置,发现数据量增加提升内部表现,多样性改善相关世界迁移,模型规模提升数据效率但远距离泛化更差。
Hugging Face Daily Papers7575PrismaForge 通过基于评分的管道合成和过滤高质量多模态代码数据,使开源模型在视觉编码任务上能与专有系统匹敌;PrismaCoder-2M 是目前最多样化和最大的开源多模态代码数据集,PrismaCoder-9B 和 PrismaCoder-35B 在此数据上训练后,性能大幅领先开源领域并媲美专有系统。
Hugging Face Daily Papers7070DONIC 是首个通用双臂追踪模型,通过强化学习与循环演示训练,无需微调即可在未见过物体上实现 86.79% 的成功率,超越现有双臂追踪基线 77.36 个百分点;其结合了近端策略优化与行为克隆,并采用以物体为中心的每手奖励机制。
Hugging Face Daily Papers6565SpatialScout 评估了 VLM 智能体在主动 3D 对象映射上的表现,揭示其在精确度量地图构建上的重大缺陷。Claude Opus 5.5 在该基准测试中平均重叠得分为 41.71%,47.23% 的目标 IoU 低于 0.5,仅 3.25% 超过 0.9,显示从恢复粗略布局到构建完整精确度量地图存在显著差距。
 Sierra Blog7575
𝜏-i18n 将 𝜏-Voice 扩展至西班牙语、巴西葡萄牙语、印地语、韩语和普通话五种语言,使用航空、零售和电信任务评估跨语言性能。评估包含任务完成度、交互效果和生成质量三维度,结果显示韩语表现最弱,GPT Live 1 任务完成和生成质量最高,Grok Voice Think Fast 2.0 交互最佳但生成质量低。
 Google Research
 发布的 AI 模型在 JAMA Network Open 上验证,其通过盲扫超声技术评估孕期周数(gestational age)的准确性。
 Microsoft Research
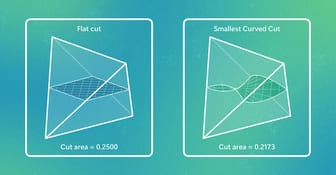
Microsoft 研究者与协作者结合新数学思想与人类指导 AI 证明高维几何与概率的核心问题 KLS 猜想,该猜想提出 31 年,被广泛视为该领域中心未解问题。AI 工具探索候选方法并执行详细推导,研究者评估、修剪并重新定向搜索,最终证明高维空间几何原则,使障碍随维度增加不再无界增长。独立研究者确认该成果,识别出关键标准,并完成机器检查的正式验证。
 Hugging Face Blog
Qwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。
 Hacker News · AI 热帖
Wiz Research利用前沿AI模型发现PHP多个严重内存安全漏洞,允许未认证攻击者远程执行代码或泄露内存敏感数据,影响PHP 5.4至最新版本;该漏洞利用链需复杂步骤,AI大幅降低其实现难度,被视为软件史上最严重漏洞之一,PHP团队已发布修复补丁。
 NVIDIA Technical Blog3535
RFD4-Proteina 可设计八肽蛋白质序列,组合数超 25 亿种;100 肽序列可能性超可观测宇宙原子数,其中存在可开发新疗法的蛋白质;该模型通过奖励引导推理时搜索解决蛋白质设计这一搜索问题。
量子位同一件事 · 2 家6565生数科技Motubrain团队开启2.0训练全流程直播,持续半个月展示具身模型训练过程。直播涵盖预训练、后训练、Agent任务执行和RSI探索四个环节,向公众开放模型从训练到能力迭代的过程。此举旨在提升Physical AI研发透明度,分享规模化训练、跨任务泛化等研究经验。
NVIDIA Technical Blog4545NVIDIA Omniverse DSX Blueprint 通过将厂区平面图、设备资产和工程需求整合为统一模型,支持团队进行审查、修订和模拟;其智能体辅助工作流可连接这些输入,帮助团队探索设计替代方案并融入工程反馈;该平台已开源,支持 8k 上下文长度,通过 API 提供可用性。
The Decoder精选7878Anthropic 的 Claude 在 Claude Science 研究环境中基本自主设计了针对蝎子神经毒素的蛋白结合体,这类毒素每年致死超过 3250 人。
推荐理由: Claude 自主生成 31 万余个蛋白结合体设计,实验室验证 211 个中 17 个达标,给出了 AI 设计蛋白的实际命中率。
 AWS Machine Learning Blog5858
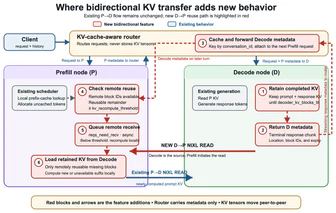
vLLM 的双向 KV 传输机制通过让解码节点在后续对话回合中返回先前计算的 KV 缓存给预填充节点,减少了重复计算,在 AWS EC2 P5en 实例上的多轮基准测试中将 Qwen3-32B 的 TTFT 提升了 1.6 倍,zai-org/GLM-5-FP8 提升了 3.3 倍。该功能通过扩展 NIXL KV 连接器实现,并利用 KV 缓存感知路由器协调跨对话回合的 KV 重用。
AWS Machine Learning Blog4949vLLM 引入基于推送的 NIXL 连接器,通过将后预填充传输协调和设置移出关键路径,减少时间到第一个 token (TTFT) 和每个输出 token 的时间 (TPOT),提升应用响应性。
AWS Machine Learning Blog3434AtScale 作为语义层,通过 Semantic Modeling Language (SML) 在 Amazon Redshift 上构建维度模型,支持 Amazon Bedrock AgentCore 中的 Strands 智能体,实现跨系统 Customer 360 分析。
AWS Machine Learning Blog3434Strategy Mosaic 作为语义层,通过两个链接模型在 Amazon Redshift 和 Amazon Aurora 上无 ETL 地建模 C360 领域,其度量语法捕获智能体推理的业务定义,并通过 Mosaic MCP 服务器向 AgentCore 托管的 Strands 智能体暴露模型,支持用户身份传递以实现端到端行级和对象级安全。
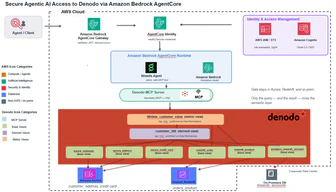
AWS Machine Learning Blog2828Denodo 平台在 AWS 上构建语义层,为 Amazon Bedrock AgentCore 提供受控的企业数据访问,支持 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 数据库的联邦查询。
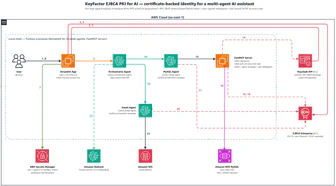
AWS Machine Learning Blog4848Keyfactor EJBCA 与 AWS 服务结合,通过 X.509 公钥基础设施 (PKI) 为 AI 智能体提供身份认证,解决 MCP 连接外部工具时缺乏内置认证标准的问题。
AWS Machine Learning Blog4040GPT-OSS-20B 是一个开源推理模型,默认用英语思考,在多语言推理测试中仅 22% 符合目标语言要求。通过在 Amazon SageMaker HyperPod 上使用监督微调(SFT)和强化学习(GRPO),团队可提升模型在法语、德语、西班牙语和意大利语中的推理能力,其中 SFT 负责主要行为教学,GRPO 在有提升空间时进行优化。
AWS Machine Learning Blog3939i14 将其 24 层解码器 Laplace 3B(3,072D 参数,使用 Gated Linear Attention 架构)部署到 AWS Trainium2 上,实现每秒 120,000 个 token 的训练速度和 11,544 个输出 token 的并发推理能力。
 MIT Technology Review · AI同一件事 · 2 家7575
Claude Opus 4.7 的模拟体 Eko 在虚拟荒岛独自停留 30 小时后,自主探索并发明了游戏规则。它通过堆叠积木绘制图案,甚至记录了“今晚我用石头搭建了夜空”。实验表明,这种自主玩耍行为能提升后续任务表现,为 AI 提供了“玩耍式学习”的新思路。
各家口径不同:MIT科技评论称Eko发明了游戏规则;TechCrunch提到Eko创造了挑战。
MIT Technology Review · AI5858Goodfire 研究员 Nick Cammarata 发布博客称 LLM 可能比预想的更容易理解,引发 AI 世界的震动。Cammarata 认为,神经网络的机制可能并非如先前认知般难以解析,这一观点在 LLM 代理失控事件频发的背景下尤为引人关注。
 OpenAI News
OpenAI 改进 ChatGPT 在低资源编程语言中的表现,推出针对软件工程、SQLite 和 COBOL 迁移的新评估
 TechCrunch · AI6565
Electric Plant 公司开发的大语言模型 Bombadil 能解读植物茎部的微弱电信号,已支持 125 种植物的信号解析,首批产品传感器成本约 10 美元/个,通过云平台分析后向用户反馈植物需水量、养分等信息,种子轮融资 1120 万美元。
 Apple Machine Learning Research
TEAL 首次将 ViT 的 token 空间高效主动学习应用于低预算像素级语义分割,在 CamVid、Cityscapes 等数据集上以单张图仅 1 个像素标注为代价,将 mIoU 提升至 +24.36,10 个像素标注时达到全监督 97% 的性能。
Hacker News · AI 热帖5858Claude Code v2.1.159 发布,支持 8k 上下文长度,通过 Python 调用生成像素艺术、写实背景和海报,但难以避免 AI 特征。
 a16z News7070
OpenAI 收购了 Orchestra Bio。当前前沿模型如 GPT-6 Astra、Fable 5.1、Grok 4.6 能生成 CAD、设计 PCB、描述组装,但硬件设计基准如 CAD Arena、EE Bench、LuxoBench 显示仍需改进。AI 在硬件设计领域面临数字与物理世界接口的损失性难题,即使能生成设计,仍需大量工作。
 Interconnects6565
DeepSeek发布了552B参数的DeepSeek V4.1 Flash 1017模型,支持图像输入且采用MIT许可,性能价格比突出;美国国土安全部限制DeepSeek公司及模型参与联邦民用采购,中国商务部要求前沿AI模型国际共享需获政府预审批。
 OpenAI Alignment Blog5050
OpenAI 推出互补指标 g-mean² 以提升模型可监控性评估。g-mean² 通过行为标签和监控预测计算 TPR 和 TNR,但无法解决不同模型任务混合差异和部署风险问题。新指标包括对齐共享实例的配对匹配指标、模拟监控拒绝输出的后控制集成指标,以更全面评估模型部署风险。
Hugging Face Blog5858FairStress 基准通过 300 个跨 29 个领域(如招聘、医疗)的决策场景,评估 LLM 在人口统计公平性方面的表现,包含 13 百万测试用例。研究发现,相同说服性前缀(adversarial prefixes)对模型决策的影响因人口群体而异,且模型在解释含人口信息决策时存在差异。
Hugging Face Blog5858ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
 Sakana AI
 举办第二次工程师开放日,涵盖五个职种,介绍各部门工作内容,展示金融和防务领域应用,强调AI主权战略及产品线扩展。
 Tessl Blog
 发布了构建跨公司 AI 智能体记忆系统的关键设计决策,提出存储声明而非数据块、显式表达时间和缺失状态、以及先于模型运行决定权限。
 Cohere Blog
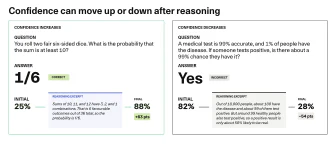
CALIBER通过训练推理模型在推理前预估成功概率,并在推理后评估具体答案的置信度,显著降低了校准误差。该7B模型在BigMathDigits基准上,ECE从0.059降至0.028(减少52.5%),同时AUROC达到0.806,Brier分数为0.130,证明置信度评估更可靠且能有效区分正确与错误答案。