Hugging Face Daily Papers6060
Youtu-Parsing-Omni:统一多模态解析器,单编码器单架构覆盖所有模态
Youtu-Parsing-Omni 将文档、图像、音频和视频编码为时空结构化记录,通过自进化策略蒸馏实现最优解析效果。单模态编码器共享权重并融合跨模态信息,单架构统一十种解析任务输出,5B参数版本在 OmniDocBench v1.6 和 OmniParsingBench 上取得 96.96 和 75.08 的顶尖成绩,代码和权重开源。
Hugging Face Daily Papers6060Youtu-Parsing-Omni 将文档、图像、音频和视频编码为时空结构化记录,通过自进化策略蒸馏实现最优解析效果。单模态编码器共享权重并融合跨模态信息,单架构统一十种解析任务输出,5B参数版本在 OmniDocBench v1.6 和 OmniParsingBench 上取得 96.96 和 75.08 的顶尖成绩,代码和权重开源。
Hugging Face Daily Papers3131SpecSlot 通过使用局部频谱槽和限制全局注意力来改进像素空间生成 Transformer,在不增加计算成本的情况下提高图像细节。SpecSlot 将每个空间锚点扩展到多个槽,每个槽分配一个不同的 DCT 系数带,这分离了锚点密度和频谱细分;每个锚点只有最低频的槽参与全局注意力,而所有槽都进行局部交互。
 Microsoft Research4040
Microsoft Research 开源了产业评估数据生成平台,通过基于 O*NET 职业数据、在线招聘和 SEC 文件的合成企业环境,模拟真实业务流程测试 Copilot AI,确保评估不接触客户数据且符合安全隐私标准。该平台包含自动化查询生成管道和结构化质量框架,支持制药、资本市场和 IT 软件等行业的真实场景测试。
 36氪 · AI同新闻7272
法国 Mistral AI 发布 Large 4 模型(ML4),具备编程和网络防御能力,企业可部署在自有计算机和服务器上运行。该模型在欧洲数据中心训练,使用 3800 颗英伟达 Grace Blackwell GPU,总参数量 1.05 万亿,每次执行任务实际激活约 520 亿参数。
 蚂蚁 inclusionAI · Hugging Face 新模型3838
inclusionAI 发布 ZwZ2-9B GGUF 格式权重,属于 Zooming without Zooming v2 项目,包含语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),需搭配 llama.cpp Qwen3.5 多模态支持使用,支持 CLI 推理和 Web Chat 部署。
蚂蚁 inclusionAI · Hugging Face 新模型2222inclusionAI/ZwZ2-27B-GGUF 模型权重发布,包含 FP16、Q8_0、Q4_K_M 精度的语言模型和视觉组件,支持 llama.cpp 多模态推理。
 MarkTechPost5959
Samaya AI 发布 Sterling 模型,基于 30B 混合专家模型 Nemotron 3.5 Lightning 微调而成,拥有 3B 活跃参数。在 FrontierFinance 基准测试中,Sterling 得分 58.9%,高于 Claude Fable 5.1 的 55.9%,且每问题成本仅为 $0.61(Fable 5.1 为 $6.89)。
 量子位
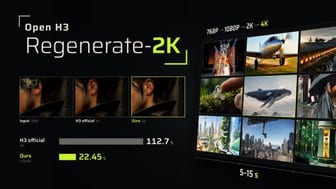
英伟达与麻省理工学院团队开源视频增强方案 Open-H3-Regenerate-2K,基于 MiniMax H3 模型将低分辨率视频重生成 2K(2560×1440)或 4K(3840×2160)视频。
Hugging Face Daily Papers4242WorkFactory通过信息规划与修复构建连贯的专业任务,产出WorkPilot模型,在专业工作基准测试中提升专家级智能体表现。该框架从专业意图出发,构建信息支持图指导任务实例化,并通过探测执行识别支持失败并指导修复,同时保留预期工作。
Hugging Face Daily Papers6565LOWN在扩散视觉语言模型解码时自适应跳过图像处理,当预测一致时减少计算量同时保持准确率。由于视觉标记在所研究基准中占89-97%输入,大多数解码计算用于重复处理相同图像。
 IT之家 · AI精选7474
开发者 Divyansh Agrawal 于 10 月 22 日发布实验性模型 Qwenputer,基于阿里 Qwen3.5-4B 构建,在神经网络内部实现 32 位 RISC-V CPU 与内存功能,无需调用 Python 等外部工具即可执行程序和精确计算。
推荐理由: 开发者将 RISC-V 指令集编译进 Qwen3.5-4B 权重,用具体基准数字展示了模型内计算的精度提升与体积、速度代价。
MarkTechPost5858Edge0 发布开源文本转语音模型 Audio8-TTS-Realistic,0.6B 参数量支持 23 种语言零样本语音克隆,在 CV3 基准测试中平均误差率 4.86% 优于 Qwen3-TTS-1.7B 和 VoxCPM2,但低于 4B 级别的 Higgs TTS 3。模型采用双自回归架构,包含 24 层宽度 896 的慢分支和 4 层并行预测快分支,并使用学习型真实感评论家进行训练。
IT之家 · AI5858谷歌推出“睡眠框架”持续学习方案,通过“清醒-睡眠”循环解决大模型知识固化与遗忘问题;模型在清醒时处理输入,睡眠时整合记忆并自我改进,实验显示可处理千万级 token 上下文并保持性能稳定,AIME 基准准确率提升
IT之家 · AI同一件事 · 2 家5050Meta 推出 AI 穿搭应用 Style Sketch,用户可关联 Instagram 生成虚拟衣橱并推荐穿搭组合,还能在虚拟模特身上试穿。应用支持 iOS 与安卓系统,已在印尼、新加坡和泰国上线。
 OpenRouter Blog5858
Claude Sonnet 5.5 是默认选择,Claude Haiku 5.5 适用于高容量和子智能体工作,Claude Opus 5.5 用于任务长、模糊或错误代价高的场景。
OpenRouter Blog5858Claude Code 安装免费,费用取决于调用的模型。在 OpenRouter 上,使用 API 密钥,Claude Opus 5.5 的 2-9 轮会话中位数费用为 0.31 美元,10-49 轮为 1.39 美元;Claude Sonnet 5.5 对应费用为 0.16 美元和 0.60 美元。
Hugging Face Daily Papers3838Soft-MTP 通过 KL 恢复技巧去除多标记预测(MTP)中的噪声梯度残差,在不增加成本的情况下提升困惑度、推测解码和推理能力。
 Databricks Blog4747
Databricks 宣布 Spark Declarative Pipelines Real-Time Mode 正式可用,该模式通过持续流式处理、并行查询阶段和即时数据传递实现毫秒级端到端延迟。
MarkTechPost同一件事 · 2 家Baseten 发布了 joey-1,一款 2B 参数决策模型,返回标签和校准概率而非生成文本,用于高容量路由、分类和护栏检查,每百万输入 token 价格为 0.01 美元,权重在 Hugging Face 上以 MIT 许可证开源。
各家口径不同:Baseten Blog 表示模型在参数量≤3B时表现最佳,而 MarkTechPost 提到的是 2B 参数模型。
 Cohere Blog3434
使用 Cohere Embed、Rerank 和 Parse 与 Amazon SageMaker AI、OpenSearch Serverless 和 Amazon Bedrock 结合,搜索金融报表并生成带页面级引用的答案。
MarkTechPost4747Prime Intellect发布Prime Mega MoE,在DeepSeek融合Mega MoE内核基础上增加快速重叠反向传递,使其可用于训练。
 TechCrunch · AI同一件事 · 2 家5555
Meta 静默推出 AI 时尚应用 Style Sketch,该应用通过连接 Instagram 或手动上传照片构建虚拟衣橱,为用户推荐基于已有衣物的穿搭组合,并提供与体型肤色匹配的虚拟试穿功能。应用目前仅在印尼、新加坡和泰国推出,支持 iOS 和 Android 平台。
 AWS Machine Learning Blog5555
Kiro 将 AI 代理与代码库结合,通过可重复的八阶段工作流程将 PHP 应用迁移至 Java,支持开发者交互式审核或 AWS Transform 自动化处理,共享技能文件实现方法论统一。
AWS Machine Learning Blog3434Epsilon 通过 Amazon Nova Act 和 Amazon Bedrock AgentCore Browser Tool 构建了意图驱动型 UI 测试平台,实现自然语言测试用例(如“确认奖励余额可见”)与现有 Playwright 回归测试套件的结合。
 Baseten Blog同一件事 · 2 家6060
Base Labs 发布 joey-1 决策模型,参数量≤3B时表现最强,单请求P50延迟20ms,成本仅0.01美元/百万token,支持文本和图像输入。该模型适合高决策量、低延迟敏感场景,可通过Baseten Model APIs使用或部署,权重已开源至Hugging Face。
各家口径不同:Baseten Blog 表示模型在参数量≤3B时表现最佳,而 MarkTechPost 提到的是 2B 参数模型。
Baseten Blog2222Postman 的智能体栈包含 Passport、Fabric、Astropods 和 Fern 四个产品,用于准备 API、控制系统访问和治理智能体行为。Baseten 作为 Postman 推荐的企业团队推理伙伴,提供快速、可靠且经济高效的推理基础设施,支持多种模型,如 Beam 1.0 和 DeepSeek V4.1 Flash,在吞吐量和延迟方面排名靠前。
 Codex releases4545
Codex 0.166.0 发布,新增键盘驱动转录选择(支持词、行、页操作)、集成搜索和可配置快捷键,以及 Markdown 在异步问题、选项、答案和转录回复中的一致性渲染。同时支持 GPT-6.1 Terra,并添加 codex queue --resume 功能以恢复卸载线程。
 Amazon Science
 结合知识蒸馏(KD)和 Medusa 框架优化旅行平台 LLM。经过微调、KD 训练及 Medusa 头部改造后,TinyLlama 1.1B 模型在 AI 旅行规划、智能筛选和住宿描述生成等场景中,性能接近 70B 参数 Llama-3.1 教师,成本降低三分之二,速度提升 10-20 倍。
AWS Machine Learning Blog4242MoEngage 通过 Amazon Bedrock AgentCore Gateway 将 400 个内部 API 转换为受权限控制的智能体工具,解决多团队 API 集成难题。该方案无需搭建 MCP 服务器或配置网络,将新 API 上线时间从数天缩短至数小时,同时满足 API 保留在 VPC 内部、身份由服务端控制、工具定义不占用推理上下文窗口的约束。
TechCrunch · AI6565由前Palantir高管创立的Dream公司获得a16z领投的1700万美元,开发基于真实物理和建筑标准的AI世界模型,用于自动化建筑设计和工程,已向AEC专业人士销售并在10个项目中部署,声称是唯一能即时设计整栋建筑的初创公司。
AWS Machine Learning Blog4242NVIDIA 在 AWS 上推出 120B 参数的 Nemotron 3.5 Super VL 模型,该模型每激活 12B 参数处理一个 token,结合推理和工具使用,支持文本、图像、文档和视频理解。
IT之家 · AI6565映泰推出无风扇边缘 AI 系统 MS-U320,搭载英特尔酷睿 5 处理器 320,提供 40TOPS 本地 AI 算力。设备尺寸 310×202×72mm,质量 1.2kg,含 1 个 DDR5 SO-DIMM 插槽和 3 个 M.2 插槽,支持 Windows 与 Ubuntu 24.04。
 vLLM Blog精选同一件事 · 2 家7878
vLLM 宣布在发布当天支持 Mistral Large 4,这是一个 1 万亿参数、每 token 激活 49B 的 MoE 原生多模态模型,采用 MLA 加 DSA 稀疏索引器,并内置 DSpark 投机解码草稿模型。
 Hugging Face Blog精选同一件事 · 2 家8585
Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Hugging Face BlogHugging Face 发布 Granite Switch 4.1.1,在 4.1 基础上增量更新,保留完全向后兼容性。新增多语言语音转写模型(支持 10 种语言带原生标点)和 Jev 决策指数测试集性能提升的决策适配器。团队通过仅更新适配器未重新计算基础模型,实现快速部署,未来将支持第三方自定义适配器。
IT之家 · AI5858微软推出 DirectX 12 Agility SDK 1.620 正式版和 1.722 预览版,为 DXR 带来集群几何体、PTLAS 等更新以降低光追计算开销。在 AMD RX 9070 上,集群几何体将性能从 1.2 FPS 提升至 79 FPS,约 66 倍提升,内存占用减少近 90%。新功能需显卡厂商驱动支持,目前涵盖英伟达 RTX、AMD RX 9000 系列及英特尔 Arc 显卡。
Hugging Face Blog5050Hugging Face 发布开源语音识别 AnySpeechRecognizer 和决策模型 AnyDecisionModel,支持 NVIDIA Parakeet 和阿里云 Qwen3-ASR 等引擎,可在苹果平台本地运行。
 Hacker News · AI 热帖
DAYJOB: Tax 评估 AI 代理在 8 个税务领域的 50 项专业任务中的表现,要求代理完成税务申报、合规和咨询工作。Claude Sonnet 5.5 在排行榜上以 10.8% 的通过率领先,Claude Opus 5.5 通过率为 9.2%。该基准包含 1,789 个工作空间文件,涵盖各种税务场景和复杂材料,由税务专家创建和审查。
量子位精选7272天数智芯发布基于天枢架构的云端通用GPU天垓300和端侧产品彤央TY1200,并在现场随机出题与英伟达H200、Jetson Thor T5000对比。
推荐理由: 现场随机出题、云端与端侧双线对比英伟达,并给出可复现的实测数字与软件栈落地方式。
量子位精选7878Physical Superintelligence(PSI)称借助自研AI科研系统Emmy,在量子信息理论的5个开放问题上取得成果,论文、Lean形式化证明和验证代码已发布在GitHub供审查。
推荐理由: 读者可看到一家新公司用生成与形式化验证分离的流程挑战量子开放问题,并了解其团队与融资背景。