IT之家 · AI精选8282
谷歌扩展 Antigravity 多智能体系统,推出 Teamwork 系统并验证多项数学证明
谷歌宣布扩展旗下 Antigravity 多智能体系统,用多个 Gemini 驱动的专业智能体组成 Teamwork 系统,可验证复杂数学证明并优化软件系统性能。
推荐理由: 原文给出多智能体在数学形式化、分子识别和代码重写上的具体产出与开放入口,可据此判断其协作验证机制的实际边界。
今天最值得读的 AI 新闻,来自正在塑造 AI 的实验室、创业公司和研究者。
IT之家 · AI精选8282谷歌宣布扩展旗下 Antigravity 多智能体系统,用多个 Gemini 驱动的专业智能体组成 Teamwork 系统,可验证复杂数学证明并优化软件系统性能。
推荐理由: 原文给出多智能体在数学形式化、分子识别和代码重写上的具体产出与开放入口,可据此判断其协作验证机制的实际边界。
 Google Research精选8888
Google 在 Antigravity 中向外部研究者和开发者开放 /teamwork 多智能体工作流,可与 Gemini 4 Argon、Carbon、Hydrogen 配合使用,/boost 和 Deep Review 也已可用。
推荐理由: Google公开了/teamwork在多智能体科研与工程任务上的具体结果,并开放给外部研究者使用。
 Hacker News · AI 热帖精选8686
Edge0 开源 Edge0-145B 和 Edge0-120B 两个端侧模型,并同时发布统一推理框架与部署工具。官方称 145B 模型可在兼容笔记本上本地运行,峰值内存 29GB、解码速度 80+ tokens/s、预填充 1100+ tokens/s,支持 128K–256K 上下文。
推荐理由: 原文给出端侧 145B 模型的实测内存、速度与多项基准对比,可据此判断本地运行前沿级模型的现实边界。
 vLLM Blog精选6060
vLLM 在 Inkling 2 Small 发布首日提供支持。该模型是文本与视觉输入的多模态 MoE,总参数 594B、激活参数 17B,上下文最长 1M tokens,并自带 DSpark 推测解码器。
推荐理由: 原文给出了 vLLM 对 Inkling 2 Small 的 Day-0 支持细节与多项内核优化,读者可据此了解该模型的部署路径与吞吐表现。
 Google AI Blog精选同一件事 · 2 家8282
Google搜索上线Gemini 4 Hydrogen,这是搜索迄今最大的一次模型升级,已面向全球所有用户开放。官方称新模型能理解多部分问题、拼写错误和高度具体的请求,并借助更强的指令遵循与工具调用能力逐项回应问题。Hydrogen的推理能力还强化了查询分发,可同时检索多个相关子主题并给出更多图片、结构化回答、对比表格和定制工具。
推荐理由: Google官方说明Gemini 4 Hydrogen在搜索中的意图理解、查询分发与可视化回答变化,可据此判断搜索体验的调整方向。
 Google DeepMind精选同一件事 · 5 家8787
Google DeepMind 发布 Gemini 4 Hydrogen,面向日常编码与智能体工作流,在默认 high 思考档位下 Artificial Analysis 智能指数为 51,高于 Argon 的 50,xhigh 档位可达 54
推荐理由: 官方给出Hydrogen与Carbon、Argon的分工定位,以及多模型编排在成本与速度上的实测差异。
vLLM Blog精选6060vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。
推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。
 The Decoder精选同一件事 · 5 家7878
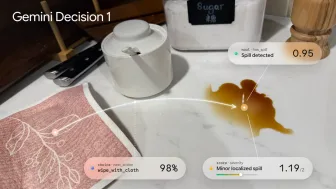
Google DeepMind 推出 Gemini Decisions API,面向是/否、多选和量表评分等封闭式判断,底层模型 Gemini Decision 1 单次可处理最多 1000 个独立问题,覆盖文本、图像、音频、视频和 PDF。
推荐理由: Gemini Decision 1 把封闭式判断做成独立 API,并给出延迟、价格与基准表现,便于对照近期同类决策模型。
 One Useful Thing精选7878
Ethan Mollick在Claude Fable 5.2公开发布前试用后认为,按“在多数可用电脑完成的智力任务上达到多数人类专家水平”的定义,它接近AGI但仍有缺口。
推荐理由: 作者用六个跨领域实测案例说明模型能力已接近通用智能,但缺乏自我判断作品好坏的能力。
 Claude · YouTube精选6868
Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Claude · YouTube精选同一件事 · 6 家7575Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
 量子位精选7272
百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。
推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。
 Hacker News · 300+ 热帖精选7878
llama-modchip 发布了一组 ggml/llama.cpp 内核补丁与量化转码工具,将 284.33B 的 DeepSeek-V4-Flash 压缩到 56.56 GiB(1.71 bpw),可在 64 GB 内存的纯 CPU 机器上运行,256K 上下文下峰值内存 57.61 GiB 且无需 swap。
推荐理由: 项目给出了在 64 GB 内存上运行 284B MoE 的量化方案与内核补丁,并附各硬件实测数据,可据此判断纯 CPU 部署的可行边界。
vLLM Blog精选7272NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 Artificial Analysis Articles精选同一件事 · 2 家7272
Thinking Machines 发布 Inkling 2 Small,在 Artificial Analysis Intelligence Index v5.0.1 上得分 31,比 Inkling Small 高 18 分,与 Gemini 3.8 Flash (high) 持平。
推荐理由: 第三方评测给出 Inkling 2 Small 与 Gemini、Claude 等模型在智能指数、编码和幻觉率上的逐项对比,可据此判断其定位。
IT之家 · AI精选7878蚂蚁百灵官方团队发布原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数和 1M 上下文窗口,支持图像、文本与视频输入。
推荐理由: 原文给出三项基准对比与 API 定价,读者可据此判断这款多模态模型的能力位置与调用成本。
量子位精选同一件事 · 3 家7272百度于11月5日正式开源基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base),采用 MoE 架构,总参数量2800亿,每个 Token 激活140亿参数,预训练使用33.5万亿 Token,预训练上下文最高128K,微调与推理阶段支持最长100万 Token 上下文。
推荐理由: 原文给出文心5.5 Flash Base 的架构与训练细节,读者可据此了解其效率优化思路与同尺寸对比位置。
vLLM Blog精选同一件事 · 2 家7575vLLM 宣布在 NVIDIA、AMD、Google TPU 和阿里平头哥真武 PPU 上 Day-0 支持月之暗面开源的 Kimi K3.1 Pro,该模型为 2.8T 参数(104B 激活)多模态 MoE,上下文 1M token。
推荐理由: vLLM 团队详述为 Kimi K3.1 Pro 做 Day-0 适配的工程取舍,含稀疏注意力、KV 缓存打包与 DCP 的具体数字。
 Together AI Blog精选同一件事 · 2 家7575
Together AI 发布了 Together Compiler(TKCC),利用高吞吐智能体持续为推理引擎生成优化方案,在 24 小时内于 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等前沿开源模型上实现 1.3-3x 的 TPS 提升。
各家口径不同:Together AI博客提到了模型Kimi K3和GLM 5.3;MarkTechPost提到了SemiAnalysis InferenceX AgentX。
推荐理由: 原文给出了持续编译在多个前沿模型上的吞吐提升和引擎启动耗时对比,可据此判断推理优化流程的变化。
 Anthropic Research精选同一件事 · 2 家6262
Anthropic 公布可验证推理原型 FlashProve,用 zkSNARK 证明响应确实来自所承诺的模型权重。对 400B 参数的 Llama 4 Maverick(4-bit 量化),单张 H100 生成证明约 110 tokens/秒,每 1,024 token 请求的证明约 19 MB,验证在 24 核 CPU 上约 17 秒。
各家口径不同:MarkTechPost 称证明体积为 18.78 MB;The Decoder 称证明体积约为 19 MB。
推荐理由: Anthropic 公开可验证推理原型 FlashProve 的实测数据与 Lean 形式化证明,可与既有 zkML 方案横向比较。