vLLM 首日支持 Mistral Large 4
Day 0 support for Mistral Large 4 on vLLM
vLLM 宣布在发布当天支持 Mistral Large 4,这是一个 1 万亿参数、每 token 激活 49B 的 MoE 原生多模态模型,采用 MLA 加 DSA 稀疏索引器,并内置 DSpark 投机解码草稿模型。
同一新闻,精选展示《Mistral Large 4(Le Chonk)在 Hugging Face 发布》
同一件事另外 2 家也报道了
- Hugging Face Blog··首发
- vLLM Blog··+0 分钟·当前阅读
vLLM 首日支持 Mistral Large 4
- The Decoder··+15 小时 25 分
法国 Mistral 发布 "Le Chonk",编码能力强劲但仍落后于中国模型
新增信息:The Decoder提到该模型在整体排名中落后于中国模型。
按发布时间排列 · 事件后续出现时自动追加 · 由模型根据各家标题与摘要比对
译文尚不完整,完整内容请切换到原文。
我们很高兴宣布 vLLM 中对 Mistral Large 4 的 day-0 支持。Mistral Large 4 是 Mistral 的新型专家混合原生多模态模型。它结合了 DeepSeek 风格的稀疏注意力堆栈(MLA 加上 DSA 顶部 k 指引器)以及几个新的架构特性:跨层 KV 共享、NoPE 层、SSMax 和 LeRoPE。它配备了内置的 DSpark 推测解码绘图器和 Pixtral 视觉编码器。
支持它需要超过一个模型文件。ML4 在 vLLM 的模型运行器 V2 (MRV2) 上运行,具有可中断的 CUDA 图。它的构建块存在于一个新的 vllm/models/mistral/ 软件包中,并且它产生的工作对解码上下文并行性 (DCP)、预填充上下文并行性 (PCP)、DSpark、基于 NIXL 的解聚服务和 HiSparse 主内存 KV 卸载进行了通用改进。
亮点
- 架构: 72 层 MoE,具有 128 个路由专家(顶部 4 个)加上 1 个共享专家,隐藏大小为 6144。注意力是 MLA(KV LoRA 排名 512,RoPE 维度 64),具有一个 DSA 稀疏索引器,该索引器为每个查询选择前 2048 个键。总共 1 万亿个参数,每个 token 激活 490 亿个参数(包括嵌入和输出层的是 520 亿)。
- 检查点: FP8(块缩放权重)和 NVFP4(NVFP4 专家,FP8 注意力/共享专家)。两者默认都使用 FP8 潜在 KV 缓存(
fp8_ds_mla)。 - 多模态: 用于图像输入的 Pixtral 视觉编码器,包括每个提示中的多个图像。
- 推测解码: 内置的 DSpark 绘图器(3 个滑动窗口 MLA 层,深度 3)接受每个步骤约 2.9 个 token,并在 TP8 上提供约 2 倍的输出吞吐量。
- 长上下文: DCP 在 TP8 上提供约 7.9 倍的 KV 容量。PCP+DCP 预填充将首次 token 时间 (TTFT) 缩短高达 1.6 倍。DSpark 在两者下都起作用。
- 解聚服务: NIXL 预填充/解码 (P/D) 解聚,具有 DP/EP、TP 和 PCP×DCP 预填充节点,并在两侧都有 DSpark。
- HiSparse: 主内存稀疏 KV 卸载,现在支持跨层 KV 共享。
- AMD: 在 AMD Instinct MI350 系列 GPU 上使用 ROCm 的 day-0 支持,包括 DSpark、图像输入和 MXFP4 专家的专家并行性。
使用
Mistral Large 4 支持包含在 vllm/vllm-openai:mistral-large-4 Docker 镜像中,该镜像还包含 mistral-common 1.13。以下命令在它内部运行 vllm serve:
docker pull vllm/vllm-openai:mistral-large-4在 8 个 GPU 上使用 FP8:
vllm serve mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}' \
  --tool-call-parser mistral --enable-auto-tool-choice \
  --reasoning-parser mistral
在 4 个 GPU 上使用 NVFP4(Blackwell;在 8 个 GPU 上使用 --tensor-parallel-size 8):
vllm serve mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --tensor-parallel-size 4 \
  --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}' \
  --tool-call-parser mistral --enable-auto-tool-choice \
  --reasoning-parser mistral
NVFP4 不会为了速度而牺牲质量。在多模态、长上下文、代理编码、业务自动化和网络安全评估中,它在每个任务上都保持在 FP8 的 2.1 分以内,平均差异为 -0.3 分。token 消耗也匹配:平均完成 token 始终保持在 FP8 的约 4% 以内。它也更快、更轻:在 TP8 上,NVFP4 每个 token 解码速度比 FP8 快 1.08–1.19 倍(没有推测解码;使用 DSpark 时为 1.18–1.22 倍),并持有约 1.5 倍的 KV 缓存。
*FP8 与 NVFP4 在核心评估中的分数和 token 消耗的比较。误差线表示通过自举估计的 95% 置信区间。在所有领域,包括多模态推理(GDP.pdf、MathVision)、长上下文(Graphwalks 512k)、代理编码(DeepSWE、SWE-bench Pro、Terminal-Bench 4)、业务自动化(AutomationBench)和网络安全(CyberGym),NVFP4 检查点都匹配 FP8 行为。
长上下文 (DCP)。 添加 --decode-context-parallel-size 8 以跨 8 个排名分片潜在 KV 缓存。它需要默认的 FP8 KV 缓存。
多模态。 传递 --limit-mm-per-prompt '{"image": N}' 以允许每个提示最多 N 张图像。
对于多节点、解耦的 P/D 和其他测试配置,请参阅 Mistral Large 4 配方。
实现细节
模型架构
| 组件 | Mistral Large 4 |
|---|---|
| 层 / 隐藏大小 / 头部 | 72 / 6144 / 64 |
| 注意力 | MLA、无查询 LoRA、KV LoRA 排名 512、RoPE 维度 64 |
| 稀疏注意力 | DSA 索引器,top-k 2048,32 个索引头;44 层拥有索引器,28 层重用最近的早期索引器层的 top-k |
| 位置编码 | YaRN + LeRoPE(按频率学习缩放);每 4 层是 NoPE |
| 查询缩放 | 每个注意力层和索引器上的 SSMax(长度相关的查询缩放) |
| KV 共享 | 9 层(39、43、…、71)读取第 35 层的潜在缓存(每 4 个) |
| MoE | 第 0 层密集;第 1–71 层:128 个专家,top-4,1 个共享专家 |
| 输出 | logit 软帽 30 |
| 视觉 | Pixtral 编码器(30 层,隐藏 2048,块 14) |
*72 个解码器层:每 4 层是 NoPE,28 层重用最近的先前索引器层的 top-k,NoPE 层 39–71 读取第 35 层的潜在 KV,只有第 0 层是密集的。*
在 vLLM 中支持每个组件所需的努力:
稀疏 MLA + DSA 索引器。ML4 重用 vLLM 的稀疏-MLA 堆栈(FlashMLA 稀疏带有 fp8_ds_mla 潜在缓存,加上稀疏索引器带有 FP8 索引器缓存)。ML4 特有的差异是叠加在顶层:重用最近早期索引器 top-k 的共享索引器层、具有自身 SSMax 的索引器以及 NoPE 层上的 NoPE 索引器。每个 token,KV 缓存存储 47,136 字节:41,328 用于 MLA 潜在值和 5,808 用于索引器。
跨层 KV 共享。9 个 NoPE 层读取第 35 层写入的潜在 KV 而不是写入自己的。我们添加了 kv_sharing_target_layer_name 到 MLAAttention 和 AttentionLayerBase。消费者层跳过缓存写入,V2 运行器将它们解析为目标层的 KV 缓存规范。消费者不占用 KV 内存:72 层中的 63 层拥有缓存。这是模型无关的,并且正在 upstream 到 vllm#64095。
NoPE、SSMax 和 LeRoPE。NoPE 层表示为具有零 RoPE 维度的 MLA,因此它们使用相同的内核和缓存布局。LeRoPE 被折叠到 YaRN 频率中。SSMax 被融合到 MLA RoPE 内核中(见下文融合)。
Mistral 模型包。而不是向 deepseek_v2.py 添加标志,端口构建在 vllm/models/mistral/ 下可重用的 Mistral 组件上:注意力、索引器、SSMax、MLP、MoE、融合操作和每层规范(common/layer_spec.py)。ML4 模型本身是 vllm/models/mistral_large4/nvidia/model.py,DSpark 草图器紧挨着它(dspark.py)。每层特征(RoPE/NoPE、索引器所有者/共享者、KV 所有者/消费者)来自从 params.json 构建的层规范,而不是共享代码中的模型特定分支。
模型运行器 V2。ML4 仅在 MRV2 上运行。V2 注意力工具发现 KV 共享层并查找它们的目标规范。DSpark 插入到 V2 DFlash/DSpark 规范器中。
可中断的 CUDA 图和融合。ML4 不使用 torch.compile。它使用可中断的 CUDA 图,为架构自动启用(当文本模型位于多模态包装器内时也是如此)。它们比急切模式快约 6 倍。手写的融合取代了编译器原本会做的事情,同时启用了进一步的优化:
- 第一轮:SSMax、MLA RoPE + SSMax、索引器 Q 路径和索引器 K 路径。这些将解码 TPOT 减少 8–10%。
- 解码轮次:FP32 路由 GEMM,一个单次启动的 Triton LayerNorm 用于索引器查询, 所有-reduce + 残差 + RMSNorm 在一个 FlashInfer 内核中完成,并且索引器 K 直接写入 FP8 缓存。在 TP8 FP8 上, c1 TPOT 从 10.22 ms 降至 9.00 ms (-12%),c8 从 16.01 ms 降至 15.08 ms。
长上下文:解码和预填充上下文并行性
DCP. MLA 保留一个潜在 KV 头,所以在 TP 下缓存在每个排名上都是复制的。DCP 按标记进行分片。 在 TP8 上,DCP8 将 KV 容量从 2.38M 提高到 18.88M 标记 (FP8) 并从 3.60M 提高到 28.76M 标记 (NVFP4)。
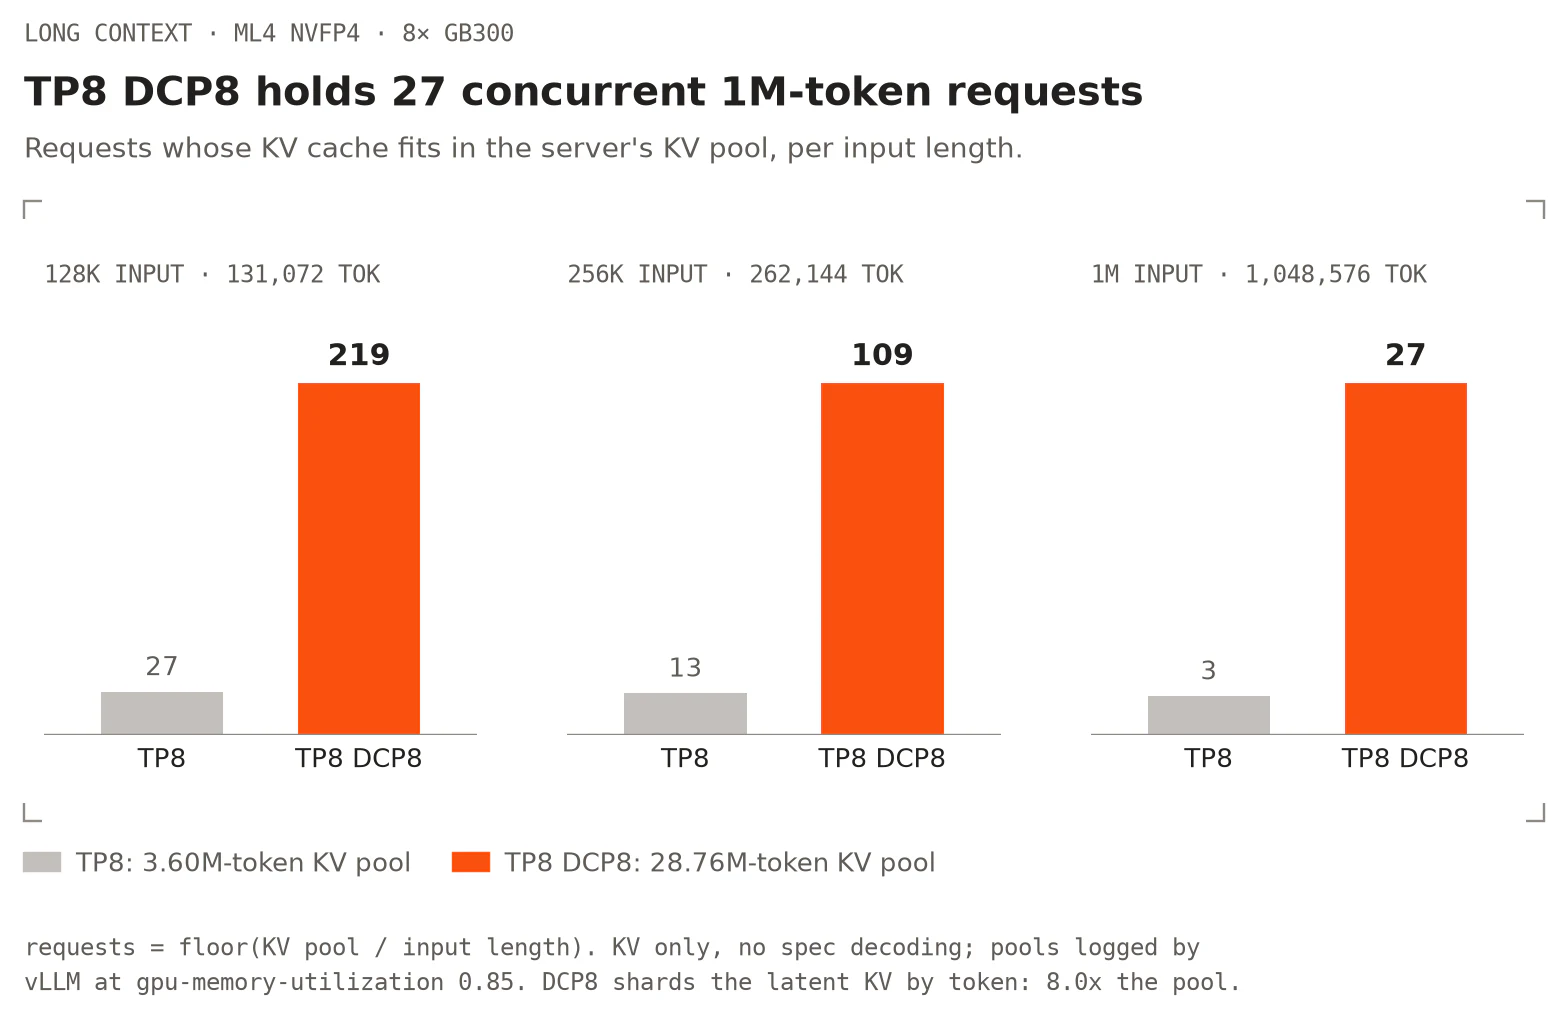
并发 128k / 256k / 1M 标记请求,其 KV 缓存适合在 8× GB300 上使用 ML4 NVFP4,TP8 vs TP8 DCP8:floor(KV 池 / 输入长度) - 3.60M 和 28.76M 标记,gpu-memory-utilization 0.85。
开箱即用,DCP 使用稀疏 MLA 每个解码步骤支付了较大的固定成本。在 60k 上下文中进行的分析显示每个步骤大约有 7 ms 的 DCP 仅工作:
- NCCL all-gathers 的 LSE 和索引器 top-k 候选者(44 个索引器层);
- reduce-scatters;
- 一个稳定的 top-k 合并;
- 查询 gathers;
- 小的掩码内核和启动间隔。
我们用以下内容替换了这些内容:
- a2a combine 用于 FlashMLA 稀疏(合并为 vllm#61285): a 对称内存 all-to-all LSE combine 代替 all-gather + reduce-scatter。ML4 默认使用它。
- 直接 top-k 交换:每个排名将其打包的(分数,id)候选者推送到其同伴的对称内存收件箱中,并且一个选择器就地读取它们。这替换了一个 NCCL all-gather 和每个索引器层 6 路径的基数选择。
- Top-k 压缩:对于 32+ 标记的批次,每个排名压缩其有效的 top-k 插槽,并用
topk_length限制内核,而不是扫描 2048 个充满-1的插槽。在一个 5k 标记的预填充分析中,注意力从 165 ms 减少到 38 ms。 - 一个融合内核消除了空行(一个不拥有查询的任何 top-k 插槽的排名)。
DCP 特定的开销降至每步 3.2 ms。与解码融合一起,在 TP8 DCP8 FP8(60k 输入 / 1k 输出):
| 之前 | 之后 | |
|---|---|---|
| c1 TTFT p50 | 6.89 s | 4.73 s |
| c1 TPOT p50 | 17.82 ms | 12.50 ms |
| c64 输出 tok/s | 139.1 | 204.0 (+47%) |

TTFT 和 TPOT p50 vs 在 TP8 DCP8 上的并发性(60k 输入 / 1k 输出,无规范),之前 (a2db3f0b9d) 和之后 (bbe5926511) DCP collectives 端口和解码融合。
这些 DCP 优化随 Mistral Large 4 在第 0 天提供支持。
何时使用 DCP。 DCP 用每步延迟换取 KV 容量。在相同的 8x GB300 NVFP4 部署和工作负载(无规范解码)上,DCP8 每个标记解码比 TP8 慢约 16–28%: c1 TPOT 在 8k 输入时为 11.1 vs 8.7 ms,在 60k 时为 11.4 vs 9.1 ms。在高达 128 个并发请求的 8k–60k 标记中,TP8 的 3.6M 标记池永远不会成为瓶颈,因此 TP8 在那里提供更高的吞吐量。DCP8 在 KV 成为限制时才值得:非常长的上下文,或者许多并发的长时间运行的会话。在我们的 agentic P/D 运行(~100k 标记会话)中,一个 TP4 DCP4 解码节点在 32 个会话中将 TTFT 保持为 0.7 s,而一个普通的 TP4 解码节点耗尽了 KV 并上升到 15 s。
PCP + DCP 预填充。 对于长提示,PCP 将一个提示的标记跨排名分割。现在 PCP+DCP 在 ML4 上使用 CUDA 图形工作,包括 DCP > PCP 和 DSpark。两个修复使它正常工作:
- 在 PCP 模式下,MLA KV 缓存首先在 PCP 排名中收集所有输入,并且该收集操作取决于批次的预填充/解码分割。在分段图中捕获时,该分割被冻结。现在,只有收集操作作为一个急切中断运行到固定大小的缓冲区中,而缓存写入本身仍然在图中。
- DCP 组的排名顺序是为了匹配集合体返回数据的顺序。
在 TP1×PCP4×DCP4 的图上,GSM8K-200 从 0.315 提升至 0.975。使用 DSpark 它达到了 0.980。作为 P/D 预填充节点,PCP4×DCP4 提供了我们测量的最低 TTFT(参见 P/D 部分)。
DSpark 推测性解码
ML4 在检查点中包含了一个 DSpark 起草人(mtp_dspark.* 张量和mtp块在params.json中)。DSpark 是一个并行起草人:一个小型非因果 Transformer 在一次前向传递中提出一个块的所有起草位置。它基于从目标层 1、18、36、54 和 71 指定的隐藏状态进行条件化。ML4 的起草人添加了:
- 一个 RNN 马尔可夫头:一个门控循环状态(排名 512)跨起草位置运行,因此每个位置的 logits 都取决于它之前的起草的标记;
- 位置特定的掩码输入:每个起草槽获得它自己的学习输入嵌入,而不是一个共享的掩码标记;
- 滑动窗口 MLA 起草层:3 个 MLA 层,具有 2048 个标记的窗口和 BF16 KV 缓存,它们自己的 KV 缓存组。Triton MLA 后端为它们获得了滑动窗口解码。
*一个 DSpark 步骤:目标捕获提供起草的上下文 K/V,[锚点、掩码_1、掩码_2]块通过 3 个滑动窗口 MLA 层在一次传递中运行,RNN 头按顺序发出 3 个起草标记,目标验证它们。*
使用 --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}' 启用它。
结果。 TP8,200 个真实提示,贪婪(温度 0),最多 512 个输出标记:
| FP8 基础 TPOT | FP8 DSpark TPOT (AL) | NVFP4 基础 TPOT | NVFP4 DSpark TPOT (AL) | |
|---|---|---|---|---|
| c1 | 8.84 ms | 3.50 ms (2.90) | 8.21 ms | 2.95 ms (2.93) |
| c8 | 15.28 ms | 7.08 ms (2.85) | 12.85 ms | 5.80 ms (2.86) |
| c32 | 29.92 ms | 11.57 ms (2.85) | 25.38 ms | 9.80 ms (2.86) |
该表使用贪婪解码。使用采样时,接受度保持接近:在温度 1.0 / top-p 0.95 时,AL 在并发 8 时约为 2.8。在更高的温度下,在推测性配置中设置"draft_sample_method": "probabilistic":在 T=1.5 时,它将 AL 从 2.04 提升至 2.36–2.53 (+12–22% 吞吐量)。两种模式都无损,这要归功于标准的拒绝采样。
在相同的并发下,DSpark 将 FP8 的输出吞吐量提高 1.9–2.1 倍,将 NVFP4 的输出吞吐量提高 1.9–2.2 倍。 它不会改变模型生成的内容:每个起草的标记都与目标模型进行了验证,并且我们通过经验检查了这一点。当基础模型重新评分 DSpark 的输出时,它们与基础模型自己的贪婪选择匹配的频率与基础模型自己的输出匹配的频率一样。在 GSM8K(1,319 个问题)上,FP8 在没有 DSpark 时得分为 0.909,在它得分为 0.918。
*每个 GPU 的输出 tok/s 与每个用户的 tok/s(1000 / TPOT p50),没有(虚线)和有 DSpark(实线,深度 3)。短:上表中 200 个提示的 TP8 运行。8k / 32k / 60k:ML4 NVFP4 位于 8× GB300 上,TP8 和 TP8 DCP8,`vllm bench serve` 使用真实文本提示和 1k 输出标记;在 60k 上,只有 DSpark 运行存在。*
DSpark + DCP. 在这项工作之前,滑动窗口 MLA 草稿无法在 DCP 下运行。现在,草稿的小窗口缓存(3 层 × ~2k 令牌,每个请求约 7 MB)在每个 DCP 排名上复制,而目标缓存保持 DCP 分片。这扩展了现有的支持(vllm#56723)到窗口化 MLA 草稿。在 TP8 DCP8 上,60k 上下文时,c1 TPOT 从 11.82 ms 降低到 5.22 ms(2.26 倍,AL 2.85),GSM8K-200 保持在 0.965。成本是 KV 容量:在 DCP8 下,每个 64 令牌的草稿块包含一个块 ID,其目标页面覆盖 512 令牌。在 64k 上下文中,容量降至约 0.69 倍的普通 DCP8。这个限制在 max_num_seqs 128 以下 ~99k 平均上下文中不受限制。
DSpark 在 P/D. 一个 DCP 预填充节点可以在两边使用 DSpark 传递给一个 TP 解码节点。NIXL 从一个预填充排名拉取复制的草稿窗口,并从 DCP 切片中拉取目标 KV。接受度与任何 P/D 布局相同:在 8k / 32k / 60k 输入时为 ~2.98 / 2.86 / 2.78。
滑动窗口 MLA 草稿层和 DSpark 在 DCP 下正在通过 vllm#63795 和 vllm#63796 上游传输。
使用 NIXL 的解耦合服务
我们在 4+4 GB300 GPU(一个 NVL72 机架)上使用 NIXL 对 1P1D 进行了基准测试。设置:
- NVFP4 在两边使用 DSpark,所有地方使用 CUDA 图,不使用前缀缓存;
vllm bench serve使用固定长度的提示:每个输入长度 320 个唯一的单轮聊天提示,每个恰好 8,192 / 32,768 / 60,000 令牌。每个提示是一个自然文本段落(WikiText-2 和 GSM8K 问题),后面跟着一个问题,提示之间没有共享前缀,作为令牌 ID 发送;- 每个请求 1,024 个输出令牌(贪婪,忽略 EOS);
- 并发扫描和固定 QPS 扫描。
所有配置通过代理在 GSM8K-200 上得分 0.965–0.980,NIXL 转移失败率为零,请求失败率为零。
*每个 GPU 的输出令牌/秒与每个用户的令牌/秒,1P1D 在 4+4 GB300 上。实线是并发扫描;空心/虚线标记是固定 QPS 扫描。*
在给定最小每个用户速度下的最佳每个 GPU 输出令牌/秒(8 个 GPU):
| P → D | 8k, ≥40 令牌/秒/用户 | 8k, ≥100 | 32k, ≥40 | 32k, ≥100 | 60k, ≥40 / ≥100 | c1 TTFT 8k / 32k / 60k |
|---|---|---|---|---|---|---|
| P DP4/EP → D DP4/EP | 718.2 | 176.7 | 202.6 | 139.2 | 108.8 | 0.49 / 1.90 / 3.65 s |
| P DP4/EP → D TP4 | 459.2 | 194.2 | 205.2 | 150.0 | 107.2 | 0.46 / 1.88 / 3.66 s |
| P PCP4×DCP4 → D TP4 | 350.6 | 192.6 | 91.5 | 91.5 | 49.8 | 0.35 / 1.37 / 2.57 s |
| P TP4 → D TP4 | 259.2 | 185.3 | 62.8 | 62.8 | 32.3 | 0.52 / 2.07 / 4.02 s |
AMD
Mistral Large 4 从第一天起就在 AMD Instinct MI350 系列 GPU 上运行,使用 vLLM 的 ROCm 构建。稀疏 MLA 在 AITER 的 MLA 解码内核上运行,DSA 索引器在 AITER 的 gfx950 索引器上。
MXFP4 专家. 在 ROCm 上,路由的专家作为 OCP MXFP4 在 AITER 的融合 MoE 上运行。获取它们有两种方法:
- AMD Quark MXFP4 检查点 (Mistral-Large-4-1T-A52B-Quark-MXFP4)。Quark 仅重新量化路由的专家,具有静态权重和动态激活比例。注意,共享专家、密集前馈层、路由器、输出头、视觉编码器和 DSpark 草稿器保持原始精度。检查点从大约 1,061 GB 缩小到 578 GB,因此它在四个 MI350 系列GPU(每个 288 GB)上服务。服务命令、评估结果和重现配方在模型卡上。
- 在加载时重新量化FP8检查点 (
VLLM_FP8_MOE_REQUANT=mxfp4)。专家按层转换,因此峰值内存保持在足够低的水平,适用于TP4。在TP8时,专家权重从每个GPU大约125 GiB降至69 GiB,并且与在1-64个并发请求下为FP8专家提供服务相比,输出吞吐量提高了22-71%。VLLM_FP8_MOE_REQUANT_ACT设置了MXFP4专家计算的激活格式:a8w4(FP8激活,默认)或a4w4(MXFP4激活)。
无论如何,一个8-GPU节点可以服务于两个TP4副本,每个副本大约有6倍的HBM用于KV缓存和FP8专家在同一四个GPU上留下的激活。
功能。 TP8和TP4、专家并行、通过Pixtral编码器进行图像输入以及使用检查点内置草稿器进行DSpark推测解码在ROCm上得到支持。在MI350X的TP4上使用FP8 KV缓存,DSpark在真实提示每步接受3.1个token,并将每个token的解码延迟降低2.7倍(一个请求)、1.9倍(8个请求)和1.8倍(32个请求)(输出吞吐量分别为2.1倍、1.6倍和1.4倍)。在ROCm上,潜在KV缓存默认为FP8(E4M3),这提供了bf16的1.86倍的KV容量;--kv-cache-dtype bfloat16将其禁用。
AITER。 VLLM_ROCM_USE_AITER=1在AITER上运行vLLM的热路径,AITER是AMD的内核库:融合的MoE(在两阶段FlyDSL内核上的MXFP4专家)、块FP8和bf16 GEMM、MLA解码内核、RMSNorm和张量并行自定义all-reduce。ROCm图像为该模型的MoE和GEMM形状提供AITER调整表,AITER在启动时将其与自己的合并;在TP4上,它们在1-8个并发请求时将输出吞吐量提高9-16%。另外两个设置可以在顶部提供帮助:VLLM_ROCM_USE_AITER_TRITON_SPARSE_MLA=1在AITER的Triton内核上运行稀疏MLA,AITER_CUSTOM_AR_MAX_SIZE=134217728将大型预填充步骤(高达128 MiB)的所有reduces保持在AITER的自定义all-reduce上。它们一起将TP4的输出吞吐量进一步提高2-5%,并将首次token的时间降低5-7%。下面的两个命令都设置了这三个。
专用解码。 对于延迟敏感型服务,--additional-config '{"decode_backend": "latency_specialized"}'将1个、2个或4个请求的解码步骤中的每个MoE层作为一个持久的FlyDSL内核启动运行。启动融合了注意力、索引器、路由器、MXFP4专家和两个张量并行all-reduce。在MI350X的TP4上,与在同一GPU上vLLM的标准解码相比,它将每个token的解码延迟降低1.5倍(一个请求)和1.1倍(四个请求)。它与DSpark协同工作:单个请求的验证块在融合内核上运行,比没有推测的标准解码低2.9倍的每个token延迟。更大的批量和预填充运行标准路径。它在默认的FP8 KV缓存上运行,需要TP4和VLLM_FP8_MOE_REQUANT_ACT=a4w4,否则拒绝启动并给出原因。该内核改编自ROCm ATOM的GLM-5.2融合解码。
在MI350系列上服务。 两个命令都启用AITER并在加载时将FP8专家重新量化为MXFP4:
# TP8, one replica per node
VLLM_ROCM_USE_AITER=1 VLLM_FP8_MOE_REQUANT=mxfp4 VLLM_FP8_MOE_REQUANT_ACT=a8w4 \
VLLM_ROCM_USE_AITER_TRITON_SPARSE_MLA=1 AITER_CUSTOM_AR_MAX_SIZE=134217728 \
vllm serve mistralai/Mistral-Large-4-1T-A52B --tensor-parallel-size 8 \
  --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}' \
  --tool-call-parser mistral --enable-auto-tool-choice --reasoning-parser mistral

# TP4 with the specialized decode, for few concurrent users; two replicas per node (second on GPUs 4-7)
VLLM_ROCM_USE_AITER=1 VLLM_FP8_MOE_REQUANT=mxfp4 VLLM_FP8_MOE_REQUANT_ACT=a4w4 \
VLLM_ROCM_USE_AITER_TRITON_SPARSE_MLA=1 AITER_CUSTOM_AR_MAX_SIZE=134217728 \
vllm serve mistralai/Mistral-Large-4-1T-A52B --tensor-parallel-size 4 \
  --additional-config '{"decode_backend": "latency_specialized"}' --max-num-seqs 64 \
  --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}' \
  --tool-call-parser mistral --enable-auto-tool-choice --reasoning-parser mistral
ROCm实现细节
Sparse MLA on AITER. On ROCm, ML4's sparse MLA runs on the ROCM_AITER_MLA_SPARSE backend. The indexer's top-2048
positions are converted to global cache slots, and each query token becomes its own entry in the slot stream. AITER's
MLA decode kernel then reads that stream in persistent mode, with work-split metadata built ahead of time to balance the
load across CUs. AITER's MLA kernels take a multiple of 16 heads: TP4 gives exactly 16 of ML4's 64 heads per GPU, while
TP8's 8 are padded to 16. VLLM_ROCM_USE_AITER_TRITON_SPARSE_MLA=1 switches to AITER's Triton sparse-MLA kernel instead,
which needs no head padding and no separate FP8 copy of the query. NoPE layers on the bf16 cache have no RoPE part for
AITER's kernel to read, so they run on vLLM's ragged Triton sparse-attention kernels.
DSA indexer on AITER. A fused Triton kernel quantizes each indexer key to FP8 with one scale and writes it into the
indexer cache, 132 bytes per token per indexer layer. Within a cache block, keys are stored in 16×16 tiles, the layout
AITER's paged reader expects. A single layout rule is shared by the writer and every reader (insert, prefill gather and
paged logits), so they cannot disagree. Prefill scores run on AITER's fp8_mqa_logits and decode scores on AITER's paged
MQA-logits kernel, both reading FP8 keys. The top-2048 comes from AITER's indexer top-k where it supports the shape, and
from vLLM's top_k_per_row otherwise. Shared-indexer layers reuse the top-k of the nearest earlier indexer layer, as on
other platforms.
FP8 latent cache. ROCm has no fp8_ds_mla layout, so when the checkpoint asks for an FP8 KV cache, ROCm uses a plain
E4M3 cache instead. All 576 latent dimensions (512 NoPE and 64 RoPE) are stored as FP8 with one per-tensor scale, 576 bytes
per token per layer, against 656 for fp8_ds_mla and 1,152 for bf16. The query is quantized to FP8 too, so AITER's kernel
runs FP8 × FP8. With 63 cache-owning layers plus the indexer, a token takes 42,096 bytes, against 78,384 in bf16: the 1.86×
KV capacity in the AMD section.
MXFP4 experts at load, one layer at a time. With VLLM_FP8_MOE_REQUANT=mxfp4, the checkpoint loader is unchanged: it
still loads block-FP8 expert weights with their block scales. Their parameters start on the meta device, and the layerwise
loader materializes one layer at a time. As soon as a layer's experts are loaded, each expert is dequantized to bf16 and
re-quantized to MXFP4 (E2M1 values, one E8M0 scale per 32 values), and that layer's FP8 copy is freed. Peak memory is the
MXFP4 model plus one layer of FP8 experts, which is what lets the 1T model load on four GPUs. The weight error is about
the same as quantizing the bf16 weights to MXFP4 directly. The experts then run on AITER's fused MoE: two-stage FlyDSL
kernels with FP8 activations for a8w4, or MXFP4 × MXFP4 for a4w4.
Specialized decode: one persistent kernel per layer. With decode_backend=latency_specialized, a pure decode step of
1, 2 or 4 requests (or a single request's DSpark verify block) runs each of the 71 MoE layers as one FlyDSL kernel launch.
The launch uses 256 CTAs, all resident at once on the GPU's 256 CUs. Inside it run:
- 输入规范、查询和潜在-KV投影使用SSMax和LeRoPE;
- 整个DSA索引器:投影、键缓存写入、评分和精确的Top-2048;
- 潜在缓存上的稀疏MLA,以bf16或FP8原地读取;
- 输出投影、Softmax Top-4路由器以及共享和路由的MXFP4专家。
嵌入、密集层0和最终规范保留在vLLM的模块上。
tensor-parallel all-reduces 在内核内部运行,在四个 GPU 之间的对等内存上,因此一层就是一个启动,没有主机往返。内核是为 1、2 和 4 行构建的,这些是 vLLM 的完整 CUDA 图捕获大小,并在这些图中重放。任何其他步骤都运行 vLLM 的层:prefill、混合批次、更宽的批次。内核改编自 ROCm ATOM 的 GLM-5.2 融合解码,扩展用于 ML4 的层类型:
- 没有查询 LoRA;
- 查询和索引查询上的 SSMax;
- softmax 路由;
- NoPE 层;
- 读取层 35 的潜在缓存 的 KV 共享层;
- 索引共享层。
故障停止。 一个等待对等 GPU 的持久内核永远不会挂起服务器。每个内核内的等待在 10 秒后放弃,放弃会在每个排名上设置一个粘性错误字,这会立即结束其他排名的等待。每次前向传播后,设备端断言会在计算 logits 之前检查该字。如果该字被设置,该步骤的剩余工作永远不会运行,工作进程中止并且引擎停止,因此来自失败步骤的任何标记都不会到达客户端。检查大约需要每个启动 1 µs。
该路径也是默认拒绝。如果一个部署使用内核不提供的内容,启动会失败,并会列出每个原因的错误,并且所有 TP 排名在集体运行之前会就每个检查达成一致。不支持的功能包括其他 TP 大小、专家或上下文并行性、LoRA、KV 连接器、其他推测方法,以及未存储为 a4w4 的专家。
TPU
Mistral Large 4 从第一天起就在 TPU v7x 上运行,vllm-torchtpu,包括对
Pixtral 视觉编码器的支持。我们验证的配置结合了主机内的张量并行、跨主机的数据并行以及跨 16 块 TPU v7x 芯片的专业并行。
在 TPU v7x 上服务:以下命令在一个主机上启动一个数据并行工作进程:
vllm serve mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 --data-parallel-size 4 --data-parallel-size-local 1 \
  --data-parallel-start-rank "$TPU_WORKER_ID" \
  --data-parallel-address "$HEAD_IP" --data-parallel-rpc-port 29696 \
  --enable-expert-parallel --enable-ep-weight-filter \
  --dtype bfloat16 --kv-cache-dtype fp8_e4m3
TPU 实现依赖于 vllm-torchtpu 的稀疏 MLA 和 DSA 索引器 Pallas 内核,扩展 MLA 以进行跨层 KV 缓存共享。我们将 MLA 潜在 KV 缓存存储在 FP8 中,并支持密集线性投影的 FP8 权重和激活量化。路由的专家使用仅权重的 FP4 量化 (W4A16)。
HiSparse:主机内存稀疏 KV 卸载
稀疏注意力每个查询只读取 2048 个键,因此一个长请求的大部分 KV 不需要在 GPU 内存中。HiSparse 将完整的潜在 KV 保留在固定的主机内存中。它保留一个驻留 GPU 工作集以及一个每个请求的热缓冲区,并在未命中时从主机复制选定的行。使用 HiSparseConnector 启用它:
--kv-transfer-config '{"kv_connector": "HiSparseConnector", "kv_role": "kv_both",
                       "kv_connector_extra_config": {"host_pool_gib": 440}}'
Known issue. When the tensor-parallel group is on a single node, also set
VLLM_FLASHINFER_ALLREDUCE_BACKEND=trtllm. The default single-node FlashInfer all-reduce
(MNNVL) can crash the engine with CUDA error: unspecified launch failure once HiSparse spills KV
to host (vllm#64327). The fix is in
flashinfer#7782.
对于 ML4,我们使 HiSparse 与 跨层 KV 共享 工作。九个消费者层绑定到层 35 的驻留视图和主机副本,并只保留它们自己的热缓冲区和 LRU(每个都有自己的索引器)。没有重复,也不需要环境变量。与实例化共享层相比,这为相同的宿主池保留了 14.3% 的更多标记。我们还修复了:
- 从多模态模型的文本配置中读取
index_topk; - CUDA 图捕获期间的两次主机镜像。
容量。 在单个 GB300 节点(TP4,NVFP4)上,四个 TP 排共享一个去重的主机池,所以 host_pool_gib 是总数。使用 440 GiB 池,HiSparse 在启动时容纳 8.77M KV 令牌,并在稳态下保持高达 11.25M,而 GPU 单独使用时只有 1.97M(4.5x 到 5.7x)。GSM8K-200 不变(0.975),针孔测试通过率约为 98k(10/10)和 ~248k(5/5)令牌。
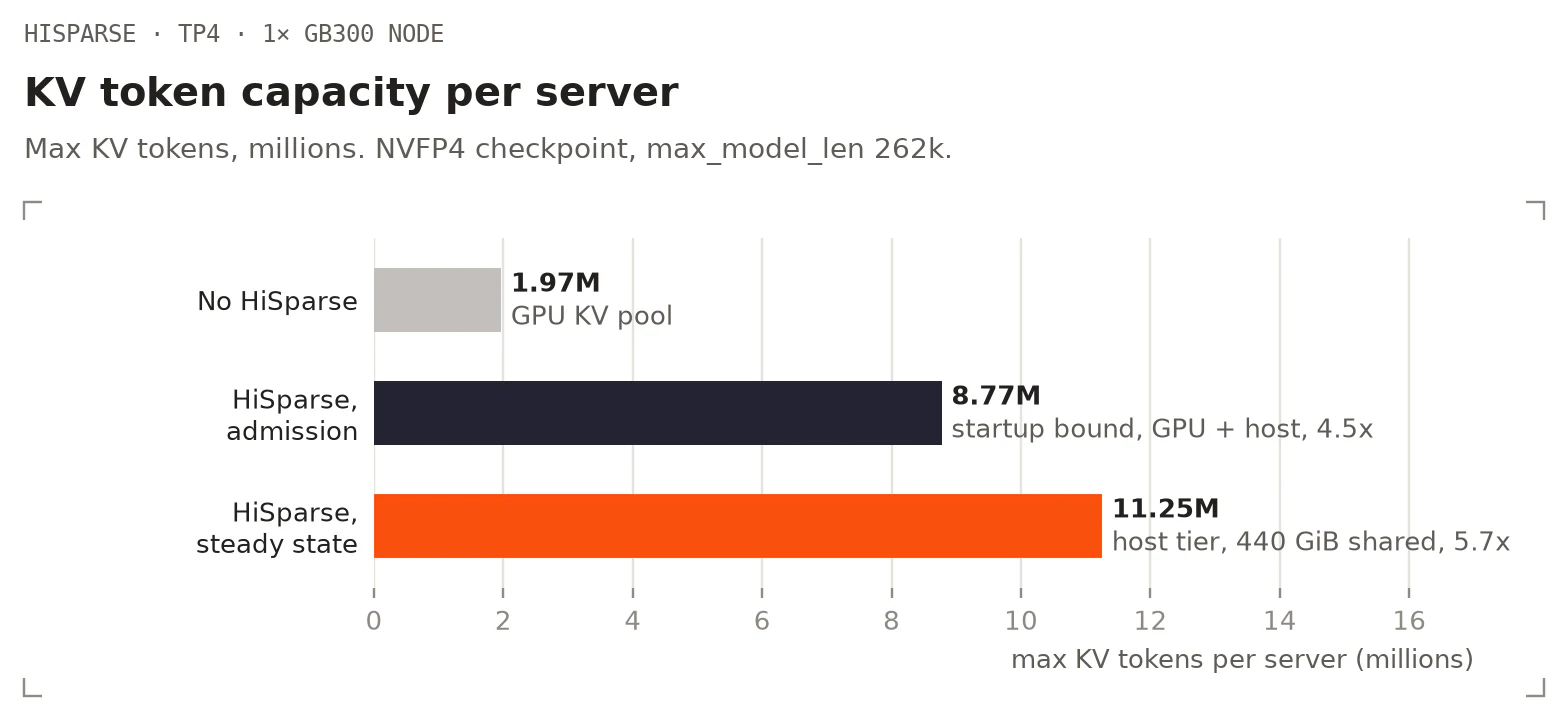
单个 GB300 节点(NVFP4,max_model_len 262k,前缀缓存关闭)上 TP4 服务器的 KV 令牌容量:GPU 单独使用时 1.97M 令牌;使用 HiSparse 和 440 GiB 主机池共享四个 TP 排,启动时容纳 8.77M 令牌(4.5x),稳态下高达 11.25M(5.7x)。重复使用层 35 的 KV 的层仅主机上存储一次。
下一步
- 上游:MLA 跨层 KV 共享,DSpark 滑动窗口 MLA 草稿和 DSpark 在 DCP 和 HiSparse KV 共享支持下运行。
- 带有 P/D 中的 DSpark 的 DCP 解码节点,以及单独的草稿块池,以便 DSpark 在 DCP 下保持完整的 KV 容量。
- HiSparse 与 GPU 部署用于 NIXL 导入和节点共享主机池的多节点 TP。
- 更多解码融合以降低并发延迟。
致谢
vLLM 中的 Mistral Large 4 支持是由 Nicolò Lucchesi 和 Mistral 推理团队领导的合作。我们感谢 vLLM 维护者审查、设计和实现大部分底层工作:Lucas Wilkinson、Flora Feng、Matt Bonanni 和 Red Hat 团队的其他人;整个 Inferact 团队;Cyrus Leung 以及整个 vLLM 社区。
在 AMD 方面,我们也感谢 Hongxia Yang、Felix Marty、Andy Luo、Indira Vats 在 AMD Instinct GPU 上进行 Day 0 启用和优化,以及 Bowen Bao、Chuan Li、Peng Sun 提供一般支持。
来源: vLLM Blog · vllm.ai