Microsoft Research
PDD Kit 正式验证 AI 智能体编写的全栈 Web 应用
PDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。
Microsoft ResearchPDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。
 TechCrunch · AI
Axiom Math 宣布正式验证 Stacks Project 项目,该项目包含约 7,654 页数学内容,团队将其翻译为约 1600 万行计算机验证代码。公司通过 AI 代理在 Lean 编程语言中重构数学证明,填补了代数几何领域的形式化空白,为未来 AI 智能体构建可靠知识库奠定基础。
 NVIDIA Newsroom3838
NVIDIA 通过全栈协同设计提升内存效率,在 GPU、CPU、网络、存储和软件各层优化内存使用。Blackwell Ultra 显卡使每 GPU HBM 容量提升约 3%,而 SemiAnalysis AgentX 上的智能体推理成本降低 30 倍。
 NVIDIA Technical Blog6565
NVIDIA协同设计通过优化内存使用,减少冗余权重复制、闲置KV缓存和重复计算前缀,提升HBM效率,将更多内存用于生成token。该方案使每个字节能产生更多有用工作,而非单纯关注GPU内存容量。
 量子位
网易有道推出互动式数学讲题Agent「欧拉讲题」,已在应用市场上线。与传统搜题产品提供答案和文字解析不同,欧拉讲题将分步骤讲解、互动追问和动态板书结合起来,让学生可以边看讲解边提问,还能通过图形演示理解抽象的数学关系。
 LangChain Blog
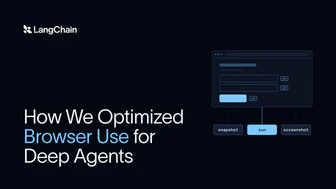
Browserbase Stagehand 工具通过代码模式让智能体一次调用完成多步浏览器操作,结合快照视图管理上下文,显著提升 Claude Sonnet 5.5 在 WebVoyager 100 任务中 90% 的通过率(总成本 $1.98。
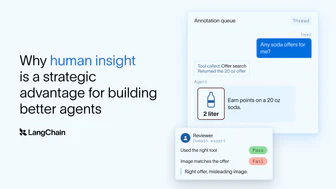
LangChain BlogLangChain 探索人类反馈三原则提升智能体开发:专家判断定义质量标准,完整上下文评估,将反馈转化为可复用数据;通过 agent trace 记录用户交互与模型行为,人工标注评分并附理由,用于校准自动化评估器、改进评估标准与构建黄金数据集,形成专家知识可复用资产。
LangChain Blog5252LangSmith Bring Your Own Cloud (BYOC) 现在支持 AWS (GA)、Azure (Beta) 和 Google Cloud (Beta),用户可将追踪、评估、数据集、提示词和智能体部署保留在自选云账户中,LangChain 负责数据层管理。
TechCrunch · AI4242Box 在开发者大会上推出 Box 内容检索功能,将 Nvidia Nemotron 集成到产品核心,通过 Nemotron 创建的嵌入元数据使智能体查询效率提升四倍。
TechCrunch · AI6565硅谷初创公司 Aina 发布智能戒指 Aina AI Ring,售价 399 美元,集成屏幕、摇杆和麦克风,可通过麦克风与 AI 智能体交互、记录笔记、接听电话,并作为 AI 和非 AI 应用的控制器。该戒指支持手势操作,可与 Mac 和手机屏幕交互,控制音乐或智能家居设备。Aina AI Ring 已开始预售,将于 2027 年 1 月发货。
Ripple-65B 通过优化 SFT 和 RL 方案提升计算效率,采用合成数据管道和质量过滤,在高质量长时程合成环境中使用截断重要性采样、分数中心化和线性长度惩罚的混合 RL 方案,仅用 1.4M 滚动次数就达到 TerminalBench 2.1 分数 80.5,比 Reflection Beam 少 70 倍。
 ByteDance Seed · Hugging Face 新模型
ByteDance-Seed/Qwen3-30B-A3B-MoE-SAE 发布,包含在 Qwen3-30B-A3B 模型第 4、30 和 46 层训练的 TopK 稀疏自编码器(k=100,2^20 潜在变量),每个 SAE 约 17.2 GB,重建方差未解释分数分别为 12.6%、25.1% 和 7.6%。
 Databricks Blog
NVIDIA 与 Databricks 联合为 Debezium 项目贡献的 Zerobus Ingest 消息接收器,通过直接将记录写入 Unity Catalog Delta 表。
 IBM Research Blog3636
ORNL、IBM 和 AMD 在 IBM 纽约波基普西园区部署量子纠错(QEC)协同设计平台,将 IBM Quantum Nighthawk r2 处理器与 ORNL Umbra HPC 系统整合,后者包含 AMD Instinct MI355X GPU 和 5th Gen AMD EPYC™ CPU,为混合 HPC-量子计算环境中的算法开发与验证提供低延迟量子-经典执行能力。
IBM Research Blog3838HRL 实验室开发出采用先进算法的惯性测量单元(IMU),提供不间断的 GPS 替代方案。其 MEMS 惯性传感器尺寸如汤罐,精度接近 GPS,并解决长期困扰的偏差漂移问题,通过 AutoCal 自动校准系统持续修正误差,实现无限导航支持。该 IMU 采用 ASIC 和先进封装技术优化成本与尺寸,适用于无人机等轻型载体。
 Hugging Face Daily Papers
StreamDuo将一个可训练解说员与一个冻结的研究智能体配对,该研究智能体检索游戏维基条目,以在不针对目标游戏进行训练的情况下提高跨游戏直播解说。StreamDuo在 Baldur's Gate 3 上训练并在十个未见过的新游戏中测试,将实体召回率从 0.082 提高到 0.116,将源游戏泄露率从 9.9% 降低到 1.0%,并在直播模型中实现了最佳时机、最高的评判活力和总体质量。
 IT之家 · AI4242
大疆发布 Matrice 5T 无人机,首次在轻型行业无人机上标配激光雷达、毫米波雷达与全彩全向视觉感知系统,售价 57,488 元。配备原生 1K 热成像相机、多焦段可见光相机,支持 IP55 防水等级,最长飞行时间 59 分钟,内置机载算法可辨别超 20 种目标类型,开放算力可导入第三方 AI 模型。
 O'Reilly Radar
RouteLLM 研究人员训练路由器在强模型和廉价模型间选择,基准评测显示成本降低一倍以上且对响应质量影响极小。自动路由能帮助用户在预算内获得更多帮助,使同一订阅支持更多请求或更频繁使用强模型。用户需了解路由效果,评估其带来的成本和时间效益,例如通过代码分析任务全程交互来比较不同路由策略。
 Codex releases00
GitHub Copilot rust-v0.168.0-alpha.4 发布,该版本包含最新功能改进和修复。
 Hacker News · AI 热帖
高通推出 Cloud AI 100 Ultra 显卡,这是一款 150W AI 加速器卡,配备 128GB 内存,带宽达到 548GB/s。
 36氪 · AI6565
MachinePulse 发布 Karpo AI 产品,通过理解用户模糊心情提供具体城市活动安排。Karpo 记住用户偏好(如家中狗 Koda)并整合现实供给(如推荐狗友好场所),在用户明确需求前介入决策。产品团队来自豆包、TikTok 等公司,面向海外市场探索“生活方式×AI”,通过持续对话捕捉意图并连接城市服务。
IT之家 · AI6565Rollme 推出 AuraCam 头戴式耳机,配备 800 万像素摄像头和电子防抖,支持 OpenAI 图像识别与实时翻译功能,售价 89.99 美元。耳机具备会议录音、拍照录像功能,通过按钮同步至手机 App,支持蓝牙 5.4 和 Wi-Fi 6,续航最长 50 小时。
Hugging Face Daily Papers6565NEO-VLA框架通过让动作策略直接访问网络深处的视觉表征,消除了固定视觉编码器,在多种操控场景和分布偏移下实现了更强鲁棒性。该框架使用轻量级卷积层对图像进行分词,并让视觉表征与语言在骨干网络中共同演化,使动作专家能从指令条件化的不同深度视觉表征中获取信息。层探查实验显示,动作关键信号常在最终视觉表征形成前就已达到峰值。
 MarkTechPost精选同一件事 · 2 家7171
Together AI 发布 Together Compiler(TKCC),一个由编码智能体驱动的持续编译系统,通过改写模型前向计算并热加载到常驻推理引擎,在 SemiAnalysis InferenceX 的 AgentX 负载上最高达到已公开最优配置的 2.6 倍 TPS,每个配置在不超过 2 个节点、24 小时内完成。
各家口径不同:Together AI博客提到了模型Kimi K3和GLM 5.3;MarkTechPost提到了SemiAnalysis InferenceX AgentX。
量子位精选同一件事 · 3 家7272百度于11月5日正式开源基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base),采用 MoE 架构,总参数量2800亿,每个 Token 激活140亿参数,预训练使用33.5万亿 Token,预训练上下文最高128K,微调与推理阶段支持最长100万 Token 上下文。
ByteDance Seed · Hugging Face 新模型5858ByteDance-Seed 发布跨层转码器(CLT)为 Qwen3-8B-Base,包含 36 层 × 32,768 潜在变量,参数量 94.2B,总大小 377 GB,支持 fp32 推理,通过联合评分所有层中的 360 个最高激活潜原来编码,解码时重建原始 MLP 输出。
量子位6565spaCy作者Matthew Honnibal质疑MIT Astra研究,称其修改Qwen3.5-0.8B权重提升数学成绩的实验存在误导,将读权重、写权重和修复大模型混为一谈;Honnibal指出,Astra修复大模型时需借助Python编程和多次前向测试,并非直接读取权重,批评其呈现方式模糊了不同能力的界限。
Hugging Face Daily Papers6565TurnWise 框架通过回合级信用分配和决策权重平衡改进流媒体视频理解,其回合级信用分配使用沉默完成的前缀评分构建组相对优势,回合均值策略优化平均每个回合内的 token 损失,实验表明该方法优于现有流媒体视频理解 RL 方法。
IT之家 · AIFlipper Devices 宣布多功能无线设备 Flipper One 开启预订,采用 20 美元“预订券”模式,未来在 Kickstarter 众筹时以 379 美元优先购买。
MarkTechPost同一件事 · 2 家Google AI Research 发布 Agile Deliberation 框架,通过人类参与循环将模糊概念转化为结构化定义,用于灰色区域图像分类。该框架基于 Gemini 2.5 Pro 和 Gemini 2.5 Flash API,无需微调,平均 F1 分数比零样本 Gemini 2.5 Flash 高 10.5 分,付费场景下 F1 达 0.59。
各家口径不同:谷歌研究提到用户实验减少疲劳和焦虑;MarkTechPost 关注 F1 分数提升。
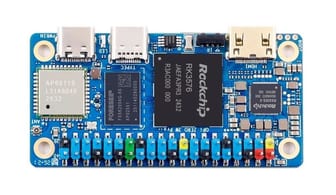
IT之家 · AI6565香橙派发布 OrangePi Zero 3W Pro 小尺寸 SBC,基于瑞芯微 RK3576 处理器,支持 16GB LPDDR 内存和多种存储扩展,集成 Wi-Fi 6E & 蓝牙 5.3,适合本地轻量 AI 推理。
IT之家 · AI同一件事 · 2 家英伟达发布 CUDA Toolkit 13.5,正式支持下一代 AI 计算平台 Vera Rubin 并面向企业生产环境部署。更新升级了 GPU 资源调度、多 GPU 通信、数学计算库及性能分析工具,优化了 cuBLAS 对 NVFP4、MXFP8 低精度矩阵运算,提升训练和推理吞吐量。
 MIT News · AI
UQ-DAAAM 系统能识别并修正机器人记忆中的错误描述,通过比较多视角图像量化不确定性并优化物体描述,提升机器人对物体、位置和时间的认知准确率,目前修正成功率约 92%,准确率提升 5%。该系统采用 LLM 融合多视角描述,并使用启发式规则选择最佳补充图像,无需重跑 VLM 即可大幅降低计算量。
IT之家 · AI3535FurMark 2 2.11.0.4 版本更新,支持 RTX Spark 等新 GPU 设备测试,优化 Windows GPU 核心热点与内存温度显示及 Linux Wayland 协同。
IT之家 · AIKimi 推出托管智能体 Kimi Hosted Agents,将 Harness 作为云端服务提供,支持 7×24 小时托管环境与长程任务执行。企业可按需配置 Agent 快速构建内部业务或产品用户应用,提供 140+ Skills 与 30+ 插件,计费为 ¥0.072/小时沙箱运行时长加模型推理费用。
Codex releases55GitHub Copilot 0.168.0-alpha.3 发布,该 AI 编码智能体用于任务、项目和自动化工作,包含代码审查、质量分析、安全漏洞检测等功能。
量子位VAST 发布 V·STAR 人才计划,聚焦 3D 生成基础模型、三维理解与智能体、世界模型研究,希望与年轻研究者共同推进 AI 从生成内容到构建可交互世界的目标。
36氪 · AI腾讯混元Hy4上线,首次引入视觉理解并支持跨应用任务操作电脑,综合表现跻身最强开源模型之列。Hy4已上线腾讯云TokenHub,每百万Tokens输入最低0.3元。即日起至12月31日通过TokenHub按量调用享5折,11月18日前通过Token Plan接入享2.5折,全球新老用户同享。
IT之家 · AI同一件事 · 2 家6262昇腾基于 vLLM Ascend、SGLang 同步实现 0 Day 推理适配 Kimi K3.1 Pro,支持 2.8 万亿参数模型在 Atlas 800 A3、900 A3 SuperPod 及 950 超节点系列上部署,模型原生支持视觉理解并具备百万 token 上下文窗口。
 Cognition Blog
SWE-2 Flash 首次在强化学习前加入中期训练阶段,性能显著超越基线模型 Inkling-Small,Terminal-Bench 4.0 分数从 0.9% 提升至 20.0%,FrontierCode 2.0 从 3.2% 提升至 24.0%,优于所有美国开源模型。该模型在 Devin Desktop 和 CLI 中可用,价格仅为 SWE-2 的五分之一,速度提升三倍。