Together AI 发布 Together Compiler,智能体让推理最高提速 2.6 倍
Together AI Releases Together Compiler: Agents Make Inference Up to 2.6x Faster
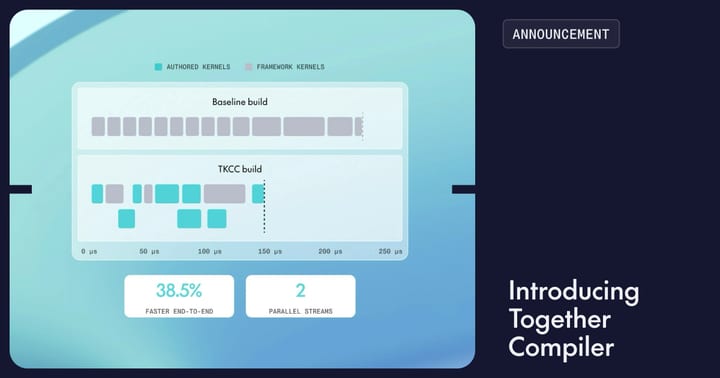
Together AI 发布 Together Compiler(TKCC),一个由编码智能体驱动的持续编译系统,通过改写模型前向计算并热加载到常驻推理引擎,在 SemiAnalysis InferenceX 的 AgentX 负载上最高达到已公开最优配置的 2.6 倍 TPS,每个配置在不超过 2 个节点、24 小时内完成。
同一新闻,精选展示《Together AI 发布了 Together Compiler,持续编译优化 AI 推理。》
同一件事另外 1 家也报道了
各家口径不同:Together AI博客提到了模型Kimi K3和GLM 5.3;MarkTechPost提到了SemiAnalysis InferenceX AgentX。
- Together AI Blog··首发
- Together AI Blog··+0 分钟
Together AI 发布了 Together Compiler,持续编译优化 AI 推理。
新增信息:在Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash上实现1.3-3倍的TPS提升。
- MarkTechPost··+32 小时 3 分·当前阅读
Together AI 发布 Together Compiler,智能体让推理最高提速 2.6 倍
新增信息:在SemiAnalysis InferenceX AgentX工作负载下实现2.6倍的TPS提升。
按发布时间排列 · 事件后续出现时自动追加 · 由模型根据各家标题与摘要比对
Together AI 推出了 Together Compiler (TKCC),这是一个由代理驱动的系统,它随着生产流量的变化不断优化推理。Together Compiler 已经在 Together 的多个无服务器端点上运行。对开发者的核心主张:一旦调优的引擎就会过时,所以调优应该永远不会停止。
TL;DR
- 系统:这是一个优化系统,在 Kimi K3、GLM 5.3、MiniMax M3.1 Flash、DeepSeek v4.1 Flash 和 Llama 1B 上经过测试。
- 运行于:NVIDIA B200、B300、GB300、H100、AMD MI355X 和 AWS Trainium2。每次运行最多使用每个模型的 2 个节点。
- 性能:在不到 24 小时的设置时间内,比最佳的已发布 InferenceX 配置高 2.6 倍的 TPS。
- 最佳:MiniMax M3.1 Flash (B200, 批量大小 1) 上每个用户的 1,111 P90 TPS,比 633 TPS 的基线高 1.8 倍。
- 最差:MI355X 上的 GLM 5.3 仅从 463 提高到 480 TPS(约 4%)。
Together Compiler 是什么?
Together Compiler 是 Together AI 的一种持续编译循环,它使用编码代理来重写模型的正向传递。它需要服务器启动命令、流量配置和硬件配置。代理提出更快的正向传递,而持久引擎测量每一个。获胜的代码将被发送到服务引擎。当流量漂移时,循环再次运行。
为什么推理需要持续编译?
Together AI 团队报告说,其流量形状永远不会静止。一个国家的提示长度约为 97K 个 token 对比其他地方的 70K。一个客户的 P90 输入长度在 3 天内从 18K 增长到 33K 个 token。
在随机数据上调整的内核也可能误导。随机输入激活了 13% 到 38% 更多的 MoE 专家,而不是实际流量。一个代理编写的 top-k 内核在随机数据上需要 20 µs。在 70K 上下文的真实数据上,它最多需要 62 ms。
持久引擎是如何工作的?
大多数代理循环为每个实验重新启动 vLLM、SGLang 或 TensorRT-LLM。研究团队测量了 MiniMax M3.1 Flash 在 TensorRT-LLM 上的 761 秒冷启动时间。Together Compiler 一次启动引擎。代理通过 RPC 提交候选的正向传递。服务器交换正向函数指针并重新捕获 CUDA 图。
两个测量级别平衡速度和保真度。快速级别提供 12 层以快速筛选。慢速级别提供 60 层以在真实分布上确认收益。两个级别测试了 8.1 倍更多的候选者(1,354 对比 168)。他们还发现了解决方案快 7.2%。Together AI 团队报告说,代理实验吞吐量比引擎重启基线高 252 倍。
它是如何选择并行布局的?
成本模型在代理开始之前对张量、专家、数据和上下文并行布局进行排名。它混合了规格表数字、微基准和测量的正向传递。它还使用了测量的 MoE 专家不平衡和不均匀的请求长度。在 Kimi K3 上,它发现了一个生产布局,其 TPS 高达 24%。
代理需要人类专家提供什么?
一个由专家策划的知识库在 12 小时后速度提升降低了 25% 到 31%。被指示使正向传递“尽可能快”的简单代理超过了专家策略。集成得分在 10 次试验后为 6.2 倍对比 4.9 倍。自定义日志结构占用了高达 43% 的工具调用。Together AI 现在向代理提供原始引擎源代码,而不是中间表示。
基准测试:Together Compiler 多快?
在 SemiAnalysis InferenceX 的 AgentX 工作负载上,Together Compiler 超过最佳开源配置最高达 2.6 倍 TPS。每个设置在最多 2 个节点上运行不超过 24 小时。
批大小 1,每个用户的 P90 TPS(Together Compiler 对比 InferenceX 最佳,自报):
- MiniMax M3.1 Flash (B200): 1,111 对比 633
- DeepSeek v4.1 Flash (GB300): 1,205 对比 943
- GLM 5.3 (B200): 417 对比 329
- Kimi K3 (GB300): 450 对比 423
- GLM 5.3 (MI355X): 480 对比 463
对于 MiniMax,成本模型选择 TP8 而不是基线的 TP4。这使每个 GPU 在内存绑定的解码中的权重流量减半。
在 Llama 1B 批大小 1 上,它超过 Hazy Research megakernels、Mirage 和 CUDA 图基线最高达 1.7 倍。除了 LLM,它通过精确比特输出加速了 8 个科学模型 1.5 倍到 6.4 倍。Claude Code 使用 /goal 加速了 1.2 倍到 4.4 倍,并在 AIFS-ENS 2.0 上失败。
与其他代理优化系统相比如何?
| 指标 | Together Compiler | Cursor + NVIDIA 多代理 | AMD GEAK | Apple RSI-Inference Bench |
|---|---|---|---|---|
| 类型 | 生产优化循环 | 多代理内核优化器 | Triton 内核代理框架 | 编码代理的基准测试 |
| 范围 | 服务引擎内部的完整前向传递 | 235 个独立的 CUDA 内核(SOL-ExecBench) | 单个 Triton 内核 | 编辑 vLLM 或 SGLang 的 37 个任务 |
| 测量 | 持久引擎,热重载,2 层,真实流量 | 在 27 个 B200 GPU 上的 SOL-ExecBench | TritonBench-revised 和 ROCm 基准测试 | 验证器构建引擎并服务模型 |
| 硬件 | B200、B300、GB300、H100、MI355X、Trainium2 | B200 | AMD Instinct MI300X | H100、B200 |
| 主要结果 | 与 InferenceX 最佳最高 2.6 倍 TPS | 1.38 倍几何平均值,在 235 中的 149 个上获胜 | 最高 2.59 倍加速,最高 63.33% 正确性 | 评分代理;没有单一系统结果 |
| 时间预算 | 每个设置不超过 24 小时 | 3 周 | 未披露 | 每个任务最多 8 小时 |
| 可用性 | Together 用户的有限 Beta | 公共代码库中的结果 | 开源 | Apple 示例代码许可 |
关键要点
- Together Compiler 随流量变化持续重新优化推理。
- 持久引擎与热重载提供 252 倍更多的代理实验。
- 在 24 小时内,超过最佳 InferenceX 配置最高达 2.6 倍 TPS。
- 简单代理击败专家知识库和精选策略。
- 自报;在不同设置中收益范围从约 4% 到 2.6 倍。
查看 论文、Together Compiler 博客 和 Polymorphic Inference 帖子。此外,欢迎在 Twitter 上关注我们,别忘了加入我们的 15 万+ML SubReddit 并订阅 我们的 Newsletter。等等!你用 Telegram 吗? 现在你也可以在 Telegram 上加入我们。
需要与我们合作推广您的 GitHub 代码库 OR Hugging Face 页面 OR 产品发布 OR 网络研讨会等? 联系我们
帖子 Together AI 发布 Together Compiler:代理使推理加速高达 2.6 倍 首次出现在 MarkTechPost。
来源: MarkTechPost · marktechpost.com