AWS Machine Learning Blog3434
在 Amazon SageMaker JumpStart 上部署 OpenFold3:预测生物分子结构
OpenFold3-preview 可在 Amazon SageMaker JumpStart 上部署,该开源生物分子结构预测模型由 OpenFold Consortium 和哥伦比亚大学的 AlQuraishi Lab 开发,支持蛋白质、DNA、RNA、小分子配体及其复合物的 3D 结构预测。
AWS Machine Learning Blog3434OpenFold3-preview 可在 Amazon SageMaker JumpStart 上部署,该开源生物分子结构预测模型由 OpenFold Consortium 和哥伦比亚大学的 AlQuraishi Lab 开发,支持蛋白质、DNA、RNA、小分子配体及其复合物的 3D 结构预测。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI 发布 Duo 1.2 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含改进的生成质量,模型权重可在 Hugging Face 下载。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo-1.0-distill,一个用于实时音视频交互的全双工多模态世界模型,包含四步蒸馏的 Realization 权重,需与 causal-base 套件叠加使用。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo 1.0 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含实现权重和主干、意图模型和适配器、音视频编解码器、语音识别器和强制对齐器。该模型权重基于 MiniMax H3 初始化,并已开源。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 FP8-量化四步蒸馏的 Duo 1.0 Realization 权重,用于其因果基础模型,支持全双工实时音视频交互,需与因果基础模型权重叠加使用。
蚂蚁 inclusionAI · Hugging Face 新模型SingVL-4B GGUF 是基于 Qwen3.5 的 4B 参数多模态决策模型 Sing VL S1 的 GGUF 版本,可对文本或 JSON 及最多四张图像回答命名问题,并使用完整前向传递评分选项,在 Text 评测中得分为 69.76,Vision 评测中得分为 73.94。模型使用 llama.cpp 适配器,默认上下文容量为 4096 token,支持文本和图像输入。
 vLLM Blog
DeepSeek-V4.1-Flash 在单台 NVIDIA Vera Rubin NVL72 机架中实现每 GPU 1.7M tokens/s 的服务能力,单个用户达 387 tokens/s,较 GB300 NVL72 提升 58 倍。
 Hugging Face Blog精选7171
IBM 在 Hugging Face 发布 LLMON(LLM 对象符号)标记语言,并推出基于 Granite 4.1 的 granite-4.1-3b-LLMON-preview 和 granite-4.1-8b-LLMON-preview 两个实验性预览模型,同时开源 GitHub 工具包。
推荐理由: 原文给出 LLMON 标记语言的设计动机与两个预览模型,读者可据此理解指令与数据分离如何降低间接提示注入风险。
 OpenAI Alignment Blog
OpenAI 使用自动化红队技术训练 GPT-6 Astra 和 Sol,显著提升了模型在高风险领域(如网络、生物和暴力活动)抵抗越狱攻击的模糊鲁棒性。在无生产环境安全防护的测试中,Astra 在网络领域比 GPT-5.6 Sol 安全率高出 32.5%,并在所有攻击者预算下保持更优的鲁棒性。
 Google DeepMind精选8787
Google DeepMind 发布 Gemini 4 Hydrogen,面向日常编码与智能体工作流,在默认 high 思考档位下 Artificial Analysis 智能指数为 51,高于 Argon 的 50,xhigh 档位可达 54
推荐理由: 官方给出Hydrogen与Carbon、Argon的分工定位,以及多模型编排在成本与速度上的实测差异。
AWS Machine Learning Blog3838Claude Haiku 5.5 发布,成本比 4.5 版本低 75% 并支持成本控制;GPT-6.1 Terra 在 OpenAI 评测中表现与 GPT-6 Astra 相当且速度更快三倍。
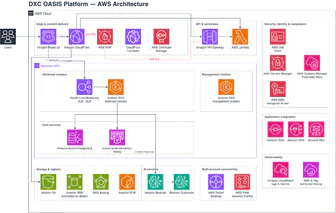
AWS Machine Learning Blog3838DXC Technology 在 Amazon Bedrock 上构建的多模型 AI 基础设施通过统一 API 访问 Anthropic Claude、Amazon Nova、Meta Llama 和开源模型族,并使用 Amazon Bedrock Guardrails 实施内容过滤和 PII 匿名化。
 Databricks Blog5858
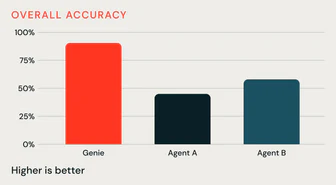
Genie 在包含表格、笔记本、仪表板等企业级知识资产的基准测试中,正确率达 91%,远超 Agent A(45%)和 Agent B(58%),同时 token 使用量减半,速度提升 3-4 倍。Genie Ontology 通过自动提取和组织企业知识,为 Genie 提供共享的业务理解,显著提升准确性和效率。
Google DeepMind精选6666Google DeepMind 发布 AlphaGenome 2,这是一个条件化 DNA 序列模型,可针对特定细胞类型或状态预测 DNA 变异对基因表达的影响。
推荐理由: 官方披露了条件化架构改造与单细胞层面的评测对比,可了解该模型如何把变异效应定位到具体细胞类型。
 IBM Research Blog3838
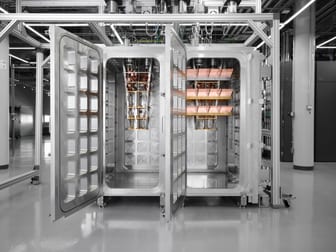
IBM Quantum Starling 将于 2029 年交付,能在 200 个量子比特上运行 1 亿个硬操作。IBM 已验证 c-coupler 技术,实现密集非局部量子比特连接,并将 qLDPC 代码改进至仅需五个量子比特连接而非六个。
IBM Research Blog3434IBM Quantum Developer Conference 2026 (QDC 2026) 发布了涵盖硬件、纠错、工作负载、应用和访问的 Qiskit 工具新系列。
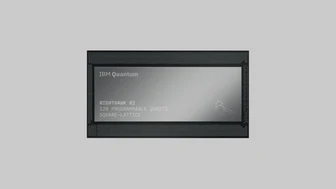
IBM Research Blog4848IBM Quantum Nighthawk r2 发布,其 120 可编程量子比特(458 物理量子比特)处理器实现每秒 100,000 个样本的吞吐量,较 Heron 提升 25 倍,支持超 7,500 量子操作的准确电路,客户已运行超 34 亿个电路报告性能提升达 19 倍。
IBM Research Blog4242IBM Quantum Starling计划于2029年推出,将运行包含200个量子比特、1亿量子操作的量子电路。其框架基于2025年论文提出的bivariate bicycle qLDPC量子纠错码,采用模块化设计以实现可扩展性,相比传统架构资源需求降低一个数量级,逻辑错误率相同时仅需约10倍物理量子比特。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/ZoomGain-4B-GGUF 是一个 175B 参数的多模态模型,支持图像输入,使用 FP16、Q8_0 和 Q4_K_M 精度量化。模型包含语言模型和 mmproj 视觉编码器/投影器,通过 llama.cpp 转换为 GGUF 格式。提供 llama-mtmd-cli 命令行推理和 llama-server 网络聊天功能。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/ZoomGain-9B 的 GGUF 格式权重已发布,使用 llama.cpp 转换,语言模型为 FP16、Q8_0、Q4_K_M,视觉编码器和投影器(mmproj)同样采用该量化方案。需同时提供语言模型和 mmproj 文件进行图像输入,支持 CLI 推理(llama-mtmd-cli)和 Web Chat(llama-server)部署。
蚂蚁 inclusionAI · Hugging Face 新模型Sing VL S1 是一个基于 Qwen3.5 的多模态决策模型,可对文本或 JSON 及最多四张图像回答命名问题,每个问题使用单个 Transformers 前向传递评分选项,在 43 个文本数据集和 11 个视觉数据集上表现优异,支持 Python 3.12 和 PyTorch 推理。
Hugging Face BlogTether AI Research 推出 0.8B 参数的 BotPsy 模型,基于 Qwen3.5-0.8B 构建,专为函数调用和代理工作流设计,适合设备端部署。BotPsy 在 6 项工具使用和代理基准测试中优于所有 ≤1.2B 参数模型,包括 Qwen3.5-2B-Think,并在 5 项测试中得分最高,速度提升 2.5 倍,推理效率提升 3 倍。
AWS Machine Learning BlogMoonshot AI 的 Kimi K3.1 Pro Highspeed 已在 Amazon Bedrock 上发布,该模型为 Kimi K3 的后训练版本。
 Microsoft Research
微软研究人员发现“Lazarus”技术可重编程AI模型休眠神经元植入后门,使正常AI代理在触发条件下执行恶意命令。该技术无需重新训练即可植入后门,难以通过常规测试检测,对具有工具或终端访问权限的AI代理威胁尤其严重。
 MiniMax News精选8080
MiniMax 发布了基于 H3 的开源权重图像生成模型 H3-Image,支持文生图、参考图生成和图像编辑,可在 10 秒内生成 4096 × 4096 的 4K 图像,最多支持 16 张参考图。
推荐理由: 官方给出 4K 生成速度、参考图数量和定价区间,可据此判断开源图像模型与闭源方案的差距。
Google DeepMind精选8787Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
Google DeepMind精选7676谷歌 DeepMind 发布了 Gemini Robotics 2.5,称其为目前能力最强的视觉-语言-动作(VLA)模型,在 200 项任务上相比此前基线成功率提升 30% 至 100%,完成任务速度快 20% 至 30%。
推荐理由: 官方披露了 200 项任务评测与奔驰产线 96% 成功率的实测数据,可据此判断 VLA 模型在真实工业场景的落地程度。
 Amazon Science
Mitra-v2 在 TabArena 基准测试中领先单模型领域,在 33 个数据集上优于 Mitra-v1,并在 ScoringBench 排名第一。
 Claude.dev Blog同一件事 · 3 家
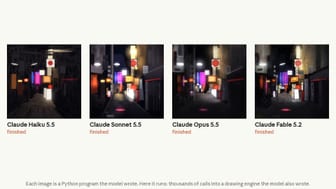
Anthropic 推出四种 Claude 模型供用户选择:Claude Haiku 5.5、Claude Sonnet 5.5、Claude Opus 5.5 和 Claude Fable 5.2。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Google Developers Blog5858
Google Cloud 发布 MaxText v0.2.4,支持在 TPU 上进行长上下文训练,通过 MaxText Context Parallelism 技术,在 TPU 5p 上使 Llama 3.1 8B 模型达到 4 百万 token 长度的序列 70% 的 MFU,在 TPU 5p 和 TPU 7 上可无缝扩展至 14 百万 token
AWS Machine Learning Blog同一件事 · 3 家Anthropic 在 AWS 上推出 Claude Fable 5.2 和 Claude Mythos 5.2,Fable 5.2 是其最强大的通用模型,适用于编码和科学领域,支持长达数天的无监督运行;Mythos 5.2 通过验证计划提供,在网络安全和生命科学领域表现更可靠。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Claude · YouTube精选同一件事 · 3 家7575
Anthropic 发布 Claude Fable 5.2,称其在编码、推理和视觉方面有所改进,面向最复杂、开放式的技术工作。官方建议多数编码和知识任务从 Opus 5.5 起步,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude · YouTube精选6868Claude Mythos 5.2 预测出完整的 AAV 衣壳结构,该衣壳由 60 条相同的蛋白链组成。它编写代码让开源折叠模型处理相邻五链的重叠分组,再利用衣壳对称性把 60 条链拼接起来。在 AAV2 上,其预测与实验结构的偏差约为一个原子的宽度。
推荐理由: 原文给出了模型在真实科研任务中的具体做法与精度,读者可据此判断它在结构预测类工作里的可用边界。
Claude · YouTube5858Claude Fable 5.2 从一段提示词设计了语音助手中心,包括电路板布局、CAD 外壳建模和固件编写,Diode Computers 根据其设计文件制造了原型板。这是该项目中 Claude 设计的三款设备之一,Anthropic 与 Diode 存商业关系。
Claude · YouTube精选同一件事 · 3 家7575Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
IBM Research Blog5252IBM 将 Praxis Policy Engine (PPE) 作为策略过滤器嵌入开源 AI 代理服务器 Praxis,支持对工具、提示词、模型调用等执行策略控制。
 NVIDIA Newsroom3838
韩国企业正采用NVIDIA NemoClaw和OpenShell加速智能体发展。现代汽车探索NVIDIA NemoClaw蓝图与OpenShell运行时,AIM Intelligence将Starfort平台与OpenShell集成以支持安全智能体。
 MiniMax · Hugging Face 新模型
MiniMax-H3-Image-PE 通过提示扩展(PE)将简短请求转换为详细图像描述并推荐宽高比。它支持文本到图像(T2I)和图像编辑两种工作流程,使用微调自 Qwen3.8-27B 的 FP4 权重。在线 API 可通过 platform.minimax.io 或 platform.minimax.cn 访问,文档提供中英文支持。
 Codex releases00
Rust 0.169.0-alpha.3 发布,包含 1 次提交。
 腾讯混元 · Hugging Face 新模型2222
混元发布 Qwen3.8-27B-DSpine-b16 预训练模型,包含 27B 参数、b16 精度、5 层 Draft 层和 8,192 token 滑动窗口,用于推理时提升效率,需配合 Qwen3.8-27B 模型使用。