跳到正文
实时
  1. Hacker News · AI 热帖86

    Edge0 开源 145B 与 120B 端侧模型及推理框架。

    Edge0 开源 Edge0-145B 和 Edge0-120B 两个端侧模型,并同时发布统一推理框架与部署工具。官方称 145B 模型可在兼容笔记本上本地运行,峰值内存 29GB、解码速度 80+ tokens/s、预填充 1100+ tokens/s,支持 128K–256K 上下文。

    推荐理由: 原文给出端侧 145B 模型的实测内存、速度与多项基准对比,可据此判断本地运行前沿级模型的现实边界。

  2. Google DeepMind87

    Google DeepMind 发布 Gemini 4 Hydrogen 模型

    Google DeepMind 发布 Gemini 4 Hydrogen,面向日常编码与智能体工作流,在默认 high 思考档位下 Artificial Analysis 智能指数为 51,高于 Argon 的 50,xhigh 档位可达 54

    推荐理由: 官方给出Hydrogen与Carbon、Argon的分工定位,以及多模型编排在成本与速度上的实测差异。

  1. MarkTechPost82

    Anthropic发布Claude Fable 5.2与Mythos 5.2:同一模型,不同安全护栏

    Anthropic发布Claude Fable 5.2和Claude Mythos 5.2,两者基于同一个底层模型,Fable 5.2增加了分类器拦截高风险网络安全任务和大部分生物学研究任务,Mythos 5.2去掉了这些限制,需要通过Cyber Verification Program和Life Sciences Verification Program访问。

    推荐理由: 将同一底层模型拆分为两档安全护栏,并提供与 Opus 5.5、GPT-6 Astra 的对比表格及成本差异。

  2. TechCrunch · AI72

    Meta 发布轻量模型 Muse Ember,主打智能体执行与低成本

    Meta Superintelligence Lab 发布轻量模型 Muse Ember,输入价格为每百万 token 10 美分,主打工具调用、编码子任务、路由、抽取和长文档解析等智能体高频工作。

    推荐理由: Meta 用每百万输入 token 10 美分的定价和 Artificial Analysis 综合基准,把轻量模型放进智能体执行环节与 Haiku、Luna 比较。

  1. 量子位82

    腾讯混元Hy4发布:770B总参数、49B激活参数,首次支持原生视觉与电脑操作

    腾讯混元Hy4正式发布,770B总参数、49B激活参数,首次引入原生视觉能力和电脑操作支持,指令遵循、长文理解与长程Agent能力同步升级。模型已在腾讯云TokenHub、WorkBuddy/CodeBuddy、元宝等产品上线,API接入OpenRouter、Hermes、OpenCode等平台,权重将于近期开源。

    推荐理由: 作者用多个长程任务实测混元Hy4的自主执行与自检能力,可据此判断开源模型在Agent交付上的实际水平。

  1. 量子位71

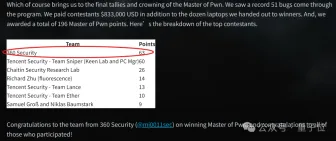
    360 图龙锋以 99.4% 漏洞复现成功率登顶 CyberGym 榜单

    360 自研 AI 安全攻防系统图龙锋在 CyberGym 榜单上以 99.4% 的漏洞复现成功率登顶,三轮独立评测成功率分别为 99.27%、99.47% 和 99.40%。

    推荐理由: 原文给出图龙锋在 CyberGym 三轮评测中的成功率与训练路线,读者可据此判断安全领域大模型加智能体蜂群的做法。

  2. The Decoder73

    Thinking Machines 发布 Inkling 2 Small,称其为最强西方开源权重模型

    Thinking Machines 发布第二代模型 Inkling 2 Small,采用 MoE 架构,总参数 594B、激活参数 17B,支持文本与图像输入并可调节思考深度。

    推荐理由: 原文给出新模型在智能指数、智能体任务和成本上的具体对比,读者可据此判断开源权重模型的竞争位置。

  3. The Decoder85

    OpenAI 发布 GPT-6 Cyber 安全模型,可挖漏洞并给出修复方案

    OpenAI 推出专为挖掘软件安全漏洞训练的 GPT-6 Cyber,可发现缺陷、构建可用漏洞利用并建议补丁。OpenAI 称其在无特殊安全指令时 99.93% 的测试未越界,前代为 94.49%;ExploitGym 得分 48.5%,前代 GPT-5.6 Cyber 为 32.1%。

    推荐理由: 原文列出了 GPT-6 Cyber 在 ExploitGym 和真实漏洞挖掘中的具体数字,读者可据此判断安全专用模型的实际能力边界。

  4. The Decoder70

    腾讯发布 Hy4 模型,首次支持图像理解与电脑操作

    腾讯发布 Hy4 模型,首次具备图像理解能力,并能自主操作 Blender、CAD 等软件,权重将在稍后未定日期开放,目前仅通过腾讯云、OpenRouter 和元宝等应用提供。

    推荐理由: 腾讯 Hy4 首次加入图像理解与电脑操作能力,第三方评测与官方说法存在差距,可对照看开放权重模型的真实位置。

  1. IT之家 · AI82

    美团龙猫开源 LongCat-2.5 模型,总参数 1.6 万亿、支持百万上下文

    美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。

    推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。

  1. Mistral AI82

    Mistral 发布万亿参数开源模型 Mistral Large 4(Le Chonk)

    Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。

    推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。

  2. Latent Space82

    Gemini 4 Carbon 登顶多项榜单,首批面向网络安全防御者开放

    Google DeepMind 发布 Gemini 4 Carbon,距 Argon 仅两周,宣称在网络安全与长周期任务上达到 SOTA,在 Artificial Analysis Intelligence Index v5 上以 59 分位列第一。

    推荐理由: 汇总了 Gemini 4 Carbon 在多个独立榜单上的位置与定价,并列出编码、幻觉率等与竞品的差距。

  3. Google DeepMind87

    Google DeepMind 发布 Gemini 4 Carbon 前沿模型

    Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。

    推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。

  1. Google DeepMind84

    Google DeepMind 发布世界模型 Genie 4

    Google DeepMind 发布世界模型 Genie 4,可实时生成带原生音频的交互式模拟世界,并以文本提示实时改变天气、镜头和场景元素。Genie 4 首次原生生成环境音与人声对话,角色可实时对话并响应场景事件;Gemini 3.8 Flash 在循环中充当引导智能体,把目标拆成步骤并逐帧校验。

    同一件事 · 2 家

    各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。

    推荐理由: 官方披露了原生音频、实时文本操控与 Gemini 引导推理三项能力,可据此判断世界模型在机器人与内容预演中的位置。

  1. 量子位80

    OpenAI发布GPT-6.1 Terra:价格减半,电脑操作能力接近GPT-6 Astra

    OpenAI发布GPT-6.1 Terra,标准API输入1美元/百万Token、缓存输入0.05美元/百万Token、输出5美元/百万Token,价格约为GPT-5.6 Terra的一半。

    推荐理由: 原文给出GPT-6.1 Terra的官方基准、API定价与网友实测成本对比,可据此判断低价电脑操作模型的性价比边界。

  2. IT之家 · AI86

    OpenAI 发布低成本新模型 GPT-6.1 Terra,每项任务成本约为 Claude Opus 5.5 九分之一

    OpenAI 发布新模型 GPT-6.1 Terra,主打以更低成本完成需要视觉推理和操作桌面软件的复杂任务,于 10 月 27 日向 Plus、Pro、Enterprise 和 Edu 用户开放,可在 ChatGPT Work 和 Codex 中使用,API 模型标识为 gpt-6.1-terra。

    推荐理由: 原文给出多项基准与每任务成本对比,读者可据此判断低成本模型在桌面自动化上的取舍。

  3. Artificial Analysis Articles85

    OpenAI 发布 GPT-6.1 Terra,主打成本效率

    OpenAI 发布 GPT-6.1 Terra,这是 GPT-5.6 之后的首个 Terra 级模型,输入/输出定价为每百万 token 1 美元/5 美元,低于 GPT-5.6 Terra 的 2 美元/12 美元。

    推荐理由: 原文使用 Intelligence Index 与 Coding Agent Index 的分数和每任务成本,量化了 GPT-6.1 Terra 相对于 GPT-5.6 Terra 的性价比变化。

  1. The Decoder85

    月之暗面发布 Kimi K3.1 Pro,AA 智能指数升至第四,逼近 Claude Opus 5.5

    月之暗面发布 Kimi K3.1 Pro,这是 Kimi K3 的后训练版本,在 Artificial Analysis 智能指数上得分 55,比 K3 提升 11 分,排名第四,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。

    推荐理由: 文章用第三方指数和多项基准对比,呈现开源权重模型与闭源前沿模型之间差距缩小的具体幅度。