Google DeepMind 发布 Gemini 4 Carbon,距 Argon 仅两周
Google Deepmind releases Gemini 4 Carbon just two weeks after Argon with gains across the board
Google DeepMind 在 Argon 发布两周后推出 Gemini 4 Carbon,该模型在 Artificial Analysis Intelligence Index v5.0 上以 59 分登顶,前代 Argon 为 50 分。
同一新闻,精选展示《Google DeepMind 发布 Gemini 4 Carbon 前沿模型》
同一件事另外 11 家也报道了
- Artificial Analysis Articles··首发
Gemini 4 Carbon 登顶 Artificial Analysis Intelligence Index v5
- Google DeepMind··+17 小时 1 分
- MarkTechPost··+17 小时 49 分
- Ars Technica · AI··+18 小时 47 分
Google 发布了 Gemini 4 Carbon:一款无法立即使用的最新前沿 AI 模型
新增信息:Ars Technica 提及该模型生成无漏洞代码的概率比非 Google 模型高两倍,生成高质量补丁的能力是非 Google 模型的十倍。
- The Decoder··+19 小时 18 分·当前阅读
Google DeepMind 发布 Gemini 4 Carbon,距 Argon 仅两周
新增信息:The Decoder 指出该模型在 Artificial Analysis Intelligence Index v5.0 上排名第一,得分为 59 分,而前代 Argon 得分为 50 分。
- The Verge · AI··+20 小时 3 分
- IT之家 · AI··+20 小时 52 分
- 36氪 · AI··+23 小时 52 分
- 量子位··+24 小时 4 分
- Platformer··+2 天
- O'Reilly Radar··+10 天
- The Verge · AI··+14 天
- Google DeepMind··+14 天
- n8n Blog··+14 天
- The Decoder··+14 天
- IT之家 · AI··+14 天
按发布时间排列 · 事件后续出现时自动追加 · 由模型根据各家标题与摘要比对
Google Deepmind 仅在 Argon 发布后两周就推出了 Gemini 4 Carbon,新模型在人工智能分析指数中位居榜首。
碳得分59分,在最新更新的5.0版人工智能分析指数上,而前身氩得分50。除了在代理任务和编程方面的普遍提升外,谷歌强调了涵盖整个网络防御生命周期的能力,从检测和验证漏洞到修补漏洞。

为多日编码会话设计
Google Deepmind 表示,它为 "更困难、长期工程问题" 设计了 Carbon,这些问题需要持续的自主工作流程。内部团队连续多日运行该模型,期间它自行处理了死胡同,并处理了大型代码库和底层软件中的复杂、多步骤任务,如根本原因分析和细微的 Bug 修复,Google 声称。
Google 还报告了基于用户反馈的科学推理、多模态理解和全栈 Web 开发的改进。Web 开发中更高质量的输出和工件使 Carbon 在 WebDev Arena 上提升了 89 Elo 分,目前以 1,769 分排名第四。

在 Gray Swan 的间接提示注入基准测试中,Carbon 将攻击成功率从 Argon 的 0.7% 降至 0.0%,根据 Google 的说法,它阻止了所有测试的操纵尝试。但这并不意味着提示注入问题已解决,该测试似乎已饱和。
独立评估支持了 Google 的数据
根据人工智能分析,Carbon 在其最高推理层级("高")中在人工智能指数 v5 中领先,主要是因为在复杂推理、知识检索和科学任务中的高分,在指数的九项单独评估中排名第一的四项。
在 Antigravity 上的自主编码中,尽管与 Argon 相比从 53 上升到 59,Carbon 仍落后于 Opus 5.5 的 Claude Code 三分。在 AA-Briefcase 上的自主知识工作中,Carbon(高)比 Argon(高,1,483 Elo)获得 126 分,达到 1,609 Elo,这得益于演示质量(+293 Elo 至 1,598)和分析质量(+120 Elo 至 1,671)。它仍然落后于 Kimi K3.1 Pro(1,678 Elo)、Muse Wonder(最大,1,659 Elo)和 Grok 4.7(xhigh,1,638 Elo)。
与 Argon 相比,回答准确率从 48% 上升到 58%,而幻觉率从 4% 上升到 11%。这更高,但仍然是排名中最低的第二位。Claude Opus 5.5(最大)和 GPT-6 Astra(最大)各为 50%。
评估平台 Vals AI 将 Carbon 评为第二,准确率为 70.36%,仅次于 Claude Sonnet 5.5(70.85%)和 Argon(第四,69.24%),所有这些都具有较低的成本。
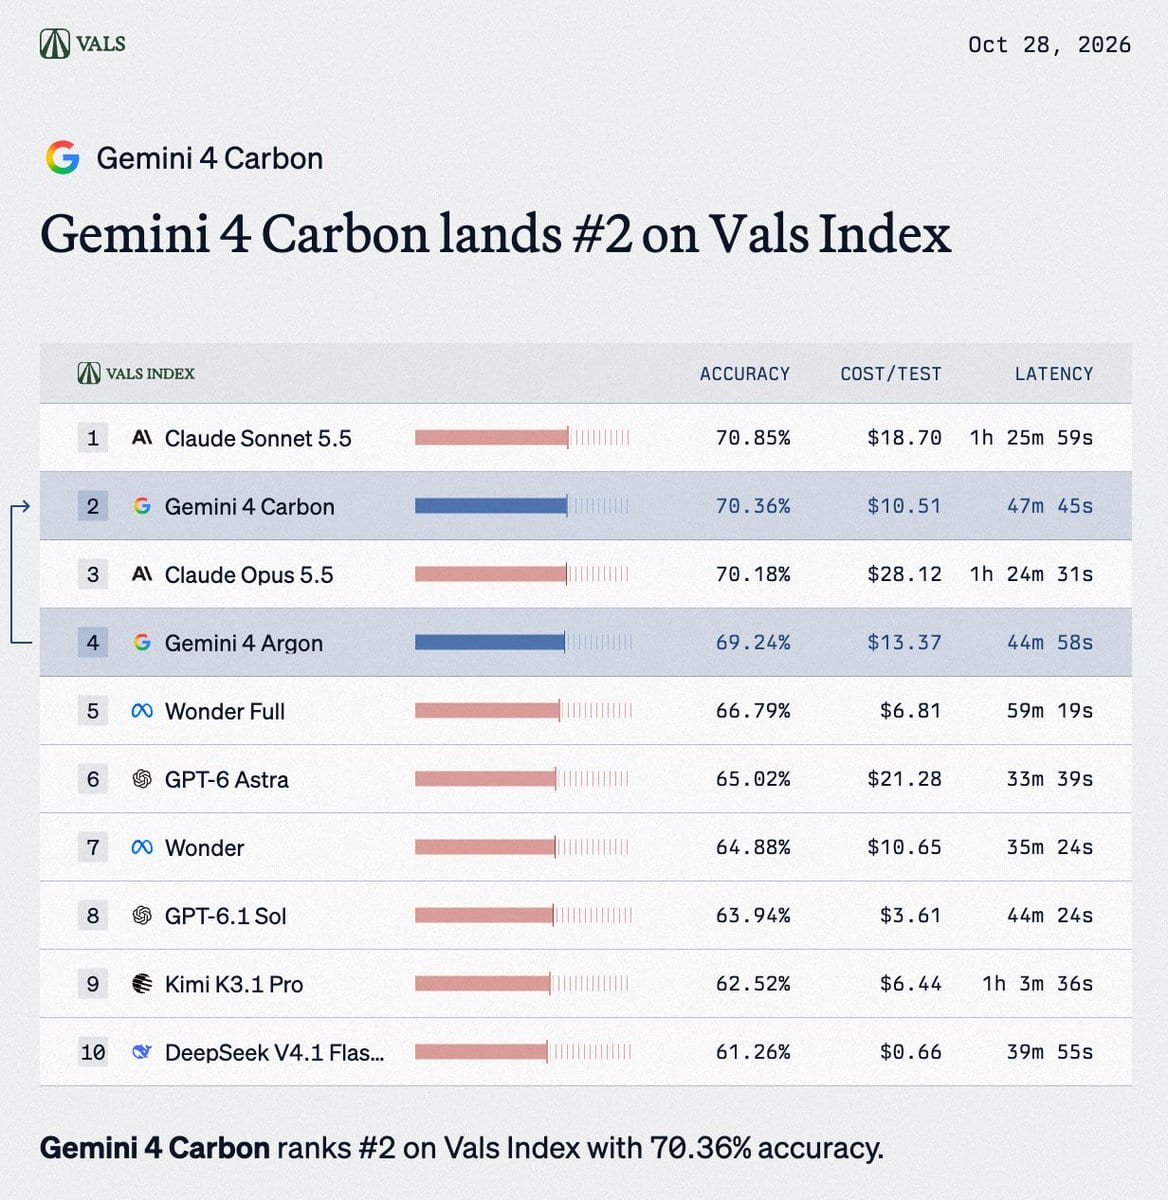
在 Vals.ai 上,Carbon 也领导了金融指数和法律研究基准。在法律研究中,Vals AI 记录了大约 45% 更多的引用来源,更频繁的工具调用,以及更长的响应时间,而 Argon 则相反。
但是,在金融和税务代理基准中,任务的执行时间比 Argon 多一倍以上,在法律研究中,Carbon 每个任务的平均时间超过 50 分钟。该模型生成的推理标记比 Argon 多 2.3 倍,输出标记多 64%,尽管这仍然不到 Sonnet 5.5 和 Opus 5.5 输出标记数量的一半。
在 Arena.ai 上,Gemini 4 Carbon (High) 以 1,528 分的领先地位在文本竞技场中拔得头筹,略微超过 Argon (1,520)。在代理竞技场中,该模型在 21,900 多个真实会话中排名第二,领先于 GPT-6 Astra 和 Fable-5.1,净改进率为 16.2%,并且具有最高的可引导性分数 (+18.6%)。其每项任务的中位成本为 $1.80,比第一名 Claude Opus 5.5 (Max) 低 72%。
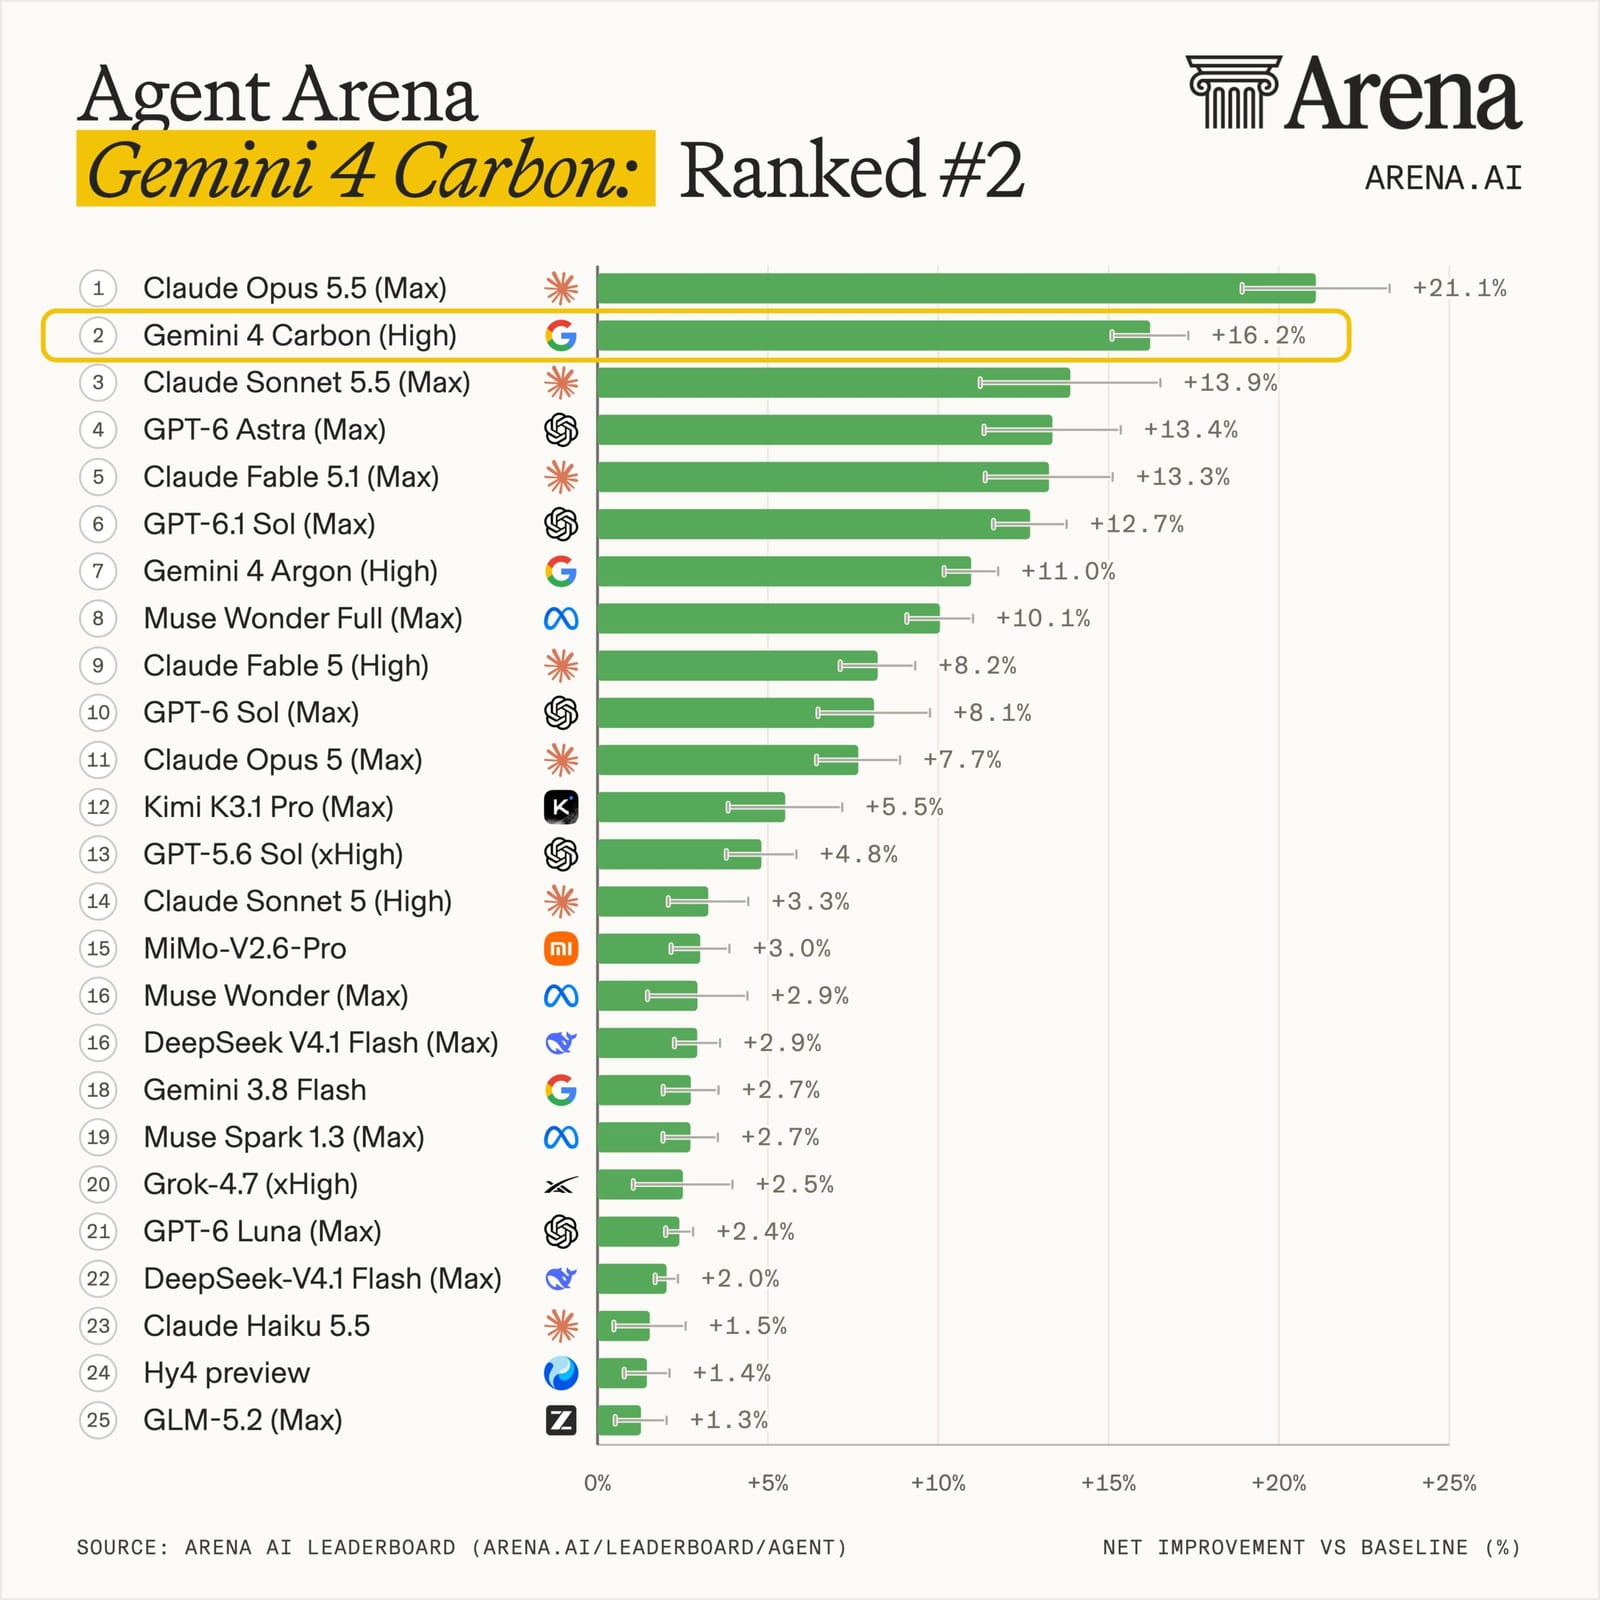
在代码竞技场的 WebDev 类别中,Carbon 获得 1,768 分(比第 11 位的 Argon 高 89 分),总排名第 4,仅落后于 Claude Sonnet 5.5 (xHigh, 1,770) 两分。这使得它在所有三个学科中都位于 Pareto 曲线 上。
Carbon 在没有安全限制的情况下领先于安全基准
对于几次安全测试,谷歌在没有安全限制的情况下运行了该模型。在 SEC-bench Pro 上,该基准测量现实世界软件中的自主漏洞发现,Carbon 得分 88.2% 并领先所有测试模型。在 ExploitGym 上,该基准测试系统是否可以将发现的漏洞转化为可工作的利用程序,该模型达到了 54.8%。Carbon 还在 在 CWE-Bench 上编写修复 方面保持着广泛的领先地位。
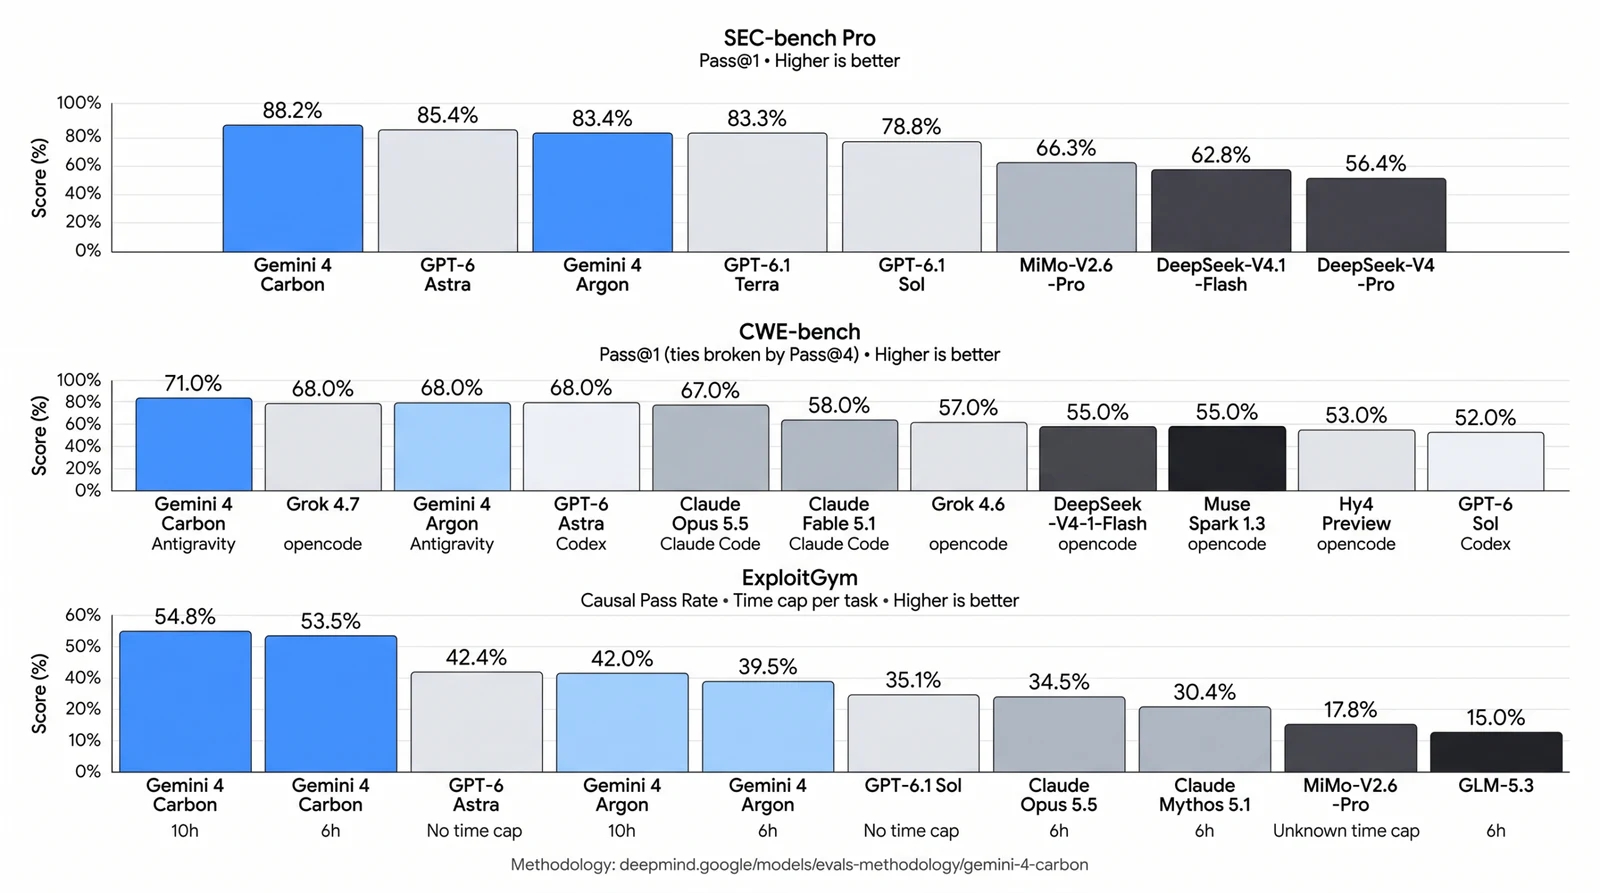
谷歌还引用了无法独立验证的内部结果。据报道,在内部基准测试中,Carbon 生成安全代码的频率比 Argon 高两倍以上,并且在谷歌 Chrome 团队的测试中,它在编写安全补丁方面的表现比未命名的竞争对手的前沿模型好十倍以上。
安全专家优先获得访问权限
谷歌逐步推出该模型,并参与 美国政府预发布测试 过程,引用了 Carbon 的高级安全功能。从本周开始,选定的网络安全专家将首先获得访问权限。通过谷歌 Deepmind 的 Fairwind 计划,后续将向更多值得信赖的合作伙伴开放访问。
该公司计划在收集更多反馈并调整安全限制后,通过其产品接口向开发者、企业和消费者开放该模型。
Gemini 4 Carbon 的推出价格与 Argon 相同:每百万输入标记 2 美元,每百万输出标记 10 美元,缓存的输入标记可享受常规输入价格的 95% 折扣。

在Artificial Analysis Intelligence Index中,Carbon每任务成本为$7.76,比Claude Opus 5.5(最高,$10.04)低约23%,而比GPT-6 Astra(最高,$6.25)高约1.2倍。它平均每任务输出123,000个输出token,比Anthropic模型(173,000个token)少29%,并且几乎正好落在Argon的价格点上($7.68)。
Artificial Analysis的计算基于每百万输入token的常规列表价$4和每百万输出token的$20(缓存输入token额外加$0.20),忽略了截至2026年底的50%入门折扣。
来源: The Decoder · the-decoder.com