月之暗面发布 Kimi K3.1 Pro,AA 智能指数升至第四,逼近 Claude Opus 5.5
Chinese AI model Kimi K3.1 Pro is closing in on Anthropic's Claude Opus 5.5
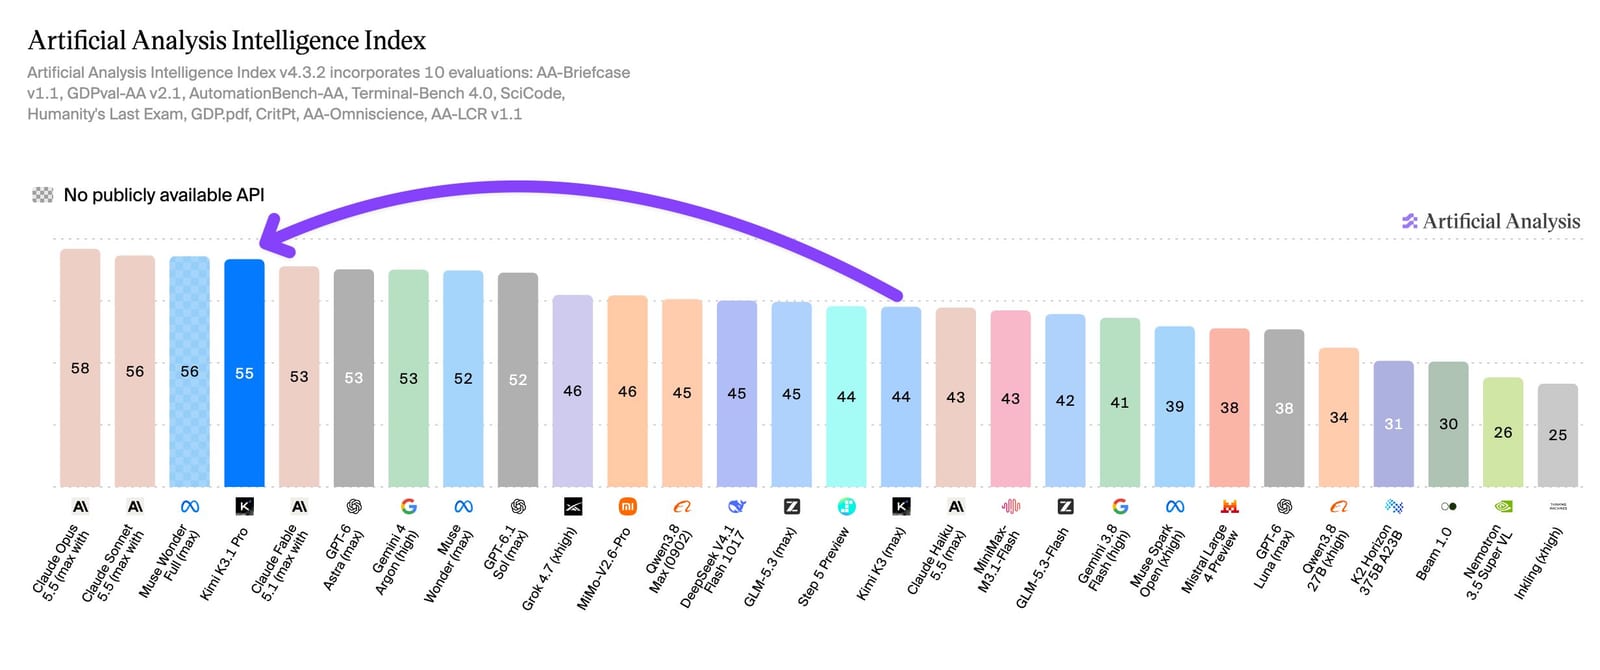
月之暗面发布 Kimi K3.1 Pro,这是 Kimi K3 的后训练版本,在 Artificial Analysis 智能指数上得分 55,比 K3 提升 11 分,排名第四,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。
文章用第三方指数和多项基准对比,呈现开源权重模型与闭源前沿模型之间差距缩小的具体幅度。
Moonshot AI 的新推理模型 Kimi K3.1 Pro 位列人工智能分析指数第四名,仅落后于顶尖专有模型 3 分。
中国AI公司Moonshot AI发布了其前身Kimi K3的后续训练版本Kimi K3.1 Pro,该模型的后续训练计算能力显著提升。该模型在人工智能分析指数上的得分为55分,比K3提升了11分,位列第四名。
根据人工智能分析,只有Claude Opus 5.5 (58)、Claude Sonnet 5.5 (56)和Muse Wonder Full (56)的排名更高,Moonshot计划于2026年11月4日发布模型权重。如果Moonshot按计划发布模型权重,K3.1 Pro将成为得分最高的开源权重模型。届时,开源模型和专有模型之间的差距将从12分缩小到仅3分,假设届时没有其他变化。
除了 K3.1 Pro,Moonshot 还推出一个名为 K3.1 Pro Highspeed 的变体,据该公司称,其运行速度比 K3.1 Pro 快两到三倍。两者现在都可以通过 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 获得。
| 项目 | Kimi-K3.1-Pro | Kimi-K3.1-Pro-Highspeed |
|---|---|---|
| 输入 | $2.00 / MTok | $4.00 / MTok |
| 输出 | $10.00 / MTok | $20.00 / MTok |
| 缓存输入 | $0.20 / MTok | $0.20 / MTok |
代理任务看到最大的收益
K3.1 Pro 在代理任务方面的改进最为显著。根据人工智能分析,在 GDPval-AA 基准测试中,它达到了 1,846 Elo,比 K3 高出 312 分,仅次于 Claude Opus 5.5 (1,866) 和 Muse Wonder Full (1,857)。在 Terminal-Bench 4.0 上,Moonshot 报告了 65.7%,领先于 GPT-6 Astra (58.2%),并且几乎落后于 Claude Opus 5.5 (66.4%)。K3 在同一测试中仅获得了 13%。
幻觉率也急剧下降。根据该公司称,在 Moonshot 的内部 Kimi Hallu Bench Hard 测试中,声明级别的幻觉率从 K3 的 23.4% 下降到 8.3%。Moonshot 表示这是一项压力测试,而不是一般错误率的衡量标准。GPT-6 Astra 在同一基准测试中达到了 5.5%,因此仍然具有优势。
在内部金融基准测试中,K3.1 Pro 在金融建模上获得了 7.2 分,在金融研究上获得了 11.6 分。对于一般办公任务,根据 Moonshot 的说法,该模型在 OfficeQA Pro v2 上超过了所有测试模型。
| 基准 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 | DeepSeek-V4.1-Flash | GLM-5.3 |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 | 42.3 | 41.8 |
| SWE Marathon v1.1 | 51.7 | 46.3 | 42.5 | 45.6 | 40.0 | 42.5 |
| DeepSWE v1.1 | 75.5 | 74.2 | 74.1 | 67.4 | 77.0 | 66.9 |
| BenchCAD (带工具) | 92.7 | 96.2 | 95.9 | 92.6 | 81.6 | -- |
| HLE-Full (带工具) | 70.0 | 67.7 | 57.2 | 65.6 | 58.8 | 62.5 |
| BrowseComp | 92.1 | 90.8 | 91.5 | -- | -- | -- |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | 54.5 | 40.4 | 31.1 |
| Automation Bench-AA | 73.3 | 69.5 | 68.5 | 59.4 | 66.6 | 62.2 |
| GDPval-AA v2.1 (Elo) | 1,846 | 1,866 | 1,573 | 1,754 | 1,746 | 1,650 |
| GPQA-Diamond | 94.2 | 93.9 | 96.1 | 93.7 | 92.2 | 91.7 |
| ExploitBench | 74.7 | 91.0 | 100 | 83.0 | -- | 54.4 |
Moonshot 的 Kimi K3.1 Pro 基准测试表。所有结果推理努力设置为 "max."
3D 建模和编码
K3.1 Pro 可以直接与 Unity、Unreal Engine 和 Godot 等游戏引擎合作,处理快速修复和完整项目构建,根据 Moonshot 的说法。在 BenchCAD 基准测试中,它使用工具获得了 92.7%,接近 Claude Opus 5.5 (96.2%) 和 GPT-6 Astra (95.9%)。不使用工具时,它达到了 72.8%,几乎与 Claude Opus 5.5 (73.0%) 相当。
Moonshot 表示该模型在机械零件、建筑模型和可配置产品的参数化建模方面最强,可以在没有 MCP 连接器的情况下为 Blender 和 CAD 软件编写和运行脚本。该公司还在 Kimi.com 上推出了一项名为“3D Make”的功能,允许用户预览、编辑和导出 3D 模型。
相同尺寸,更低价格
K3.1 Pro 保持了与 K3 相同的尺寸,具有 2.8 万亿总参数和 1040 亿个活跃参数。上下文窗口跨越一百万个标记,该模型处理文本和图像。根据 Artificial Analysis,它位于帕累托前沿的顶端。没有参数数量相当的模型在智能指数上得分更高。
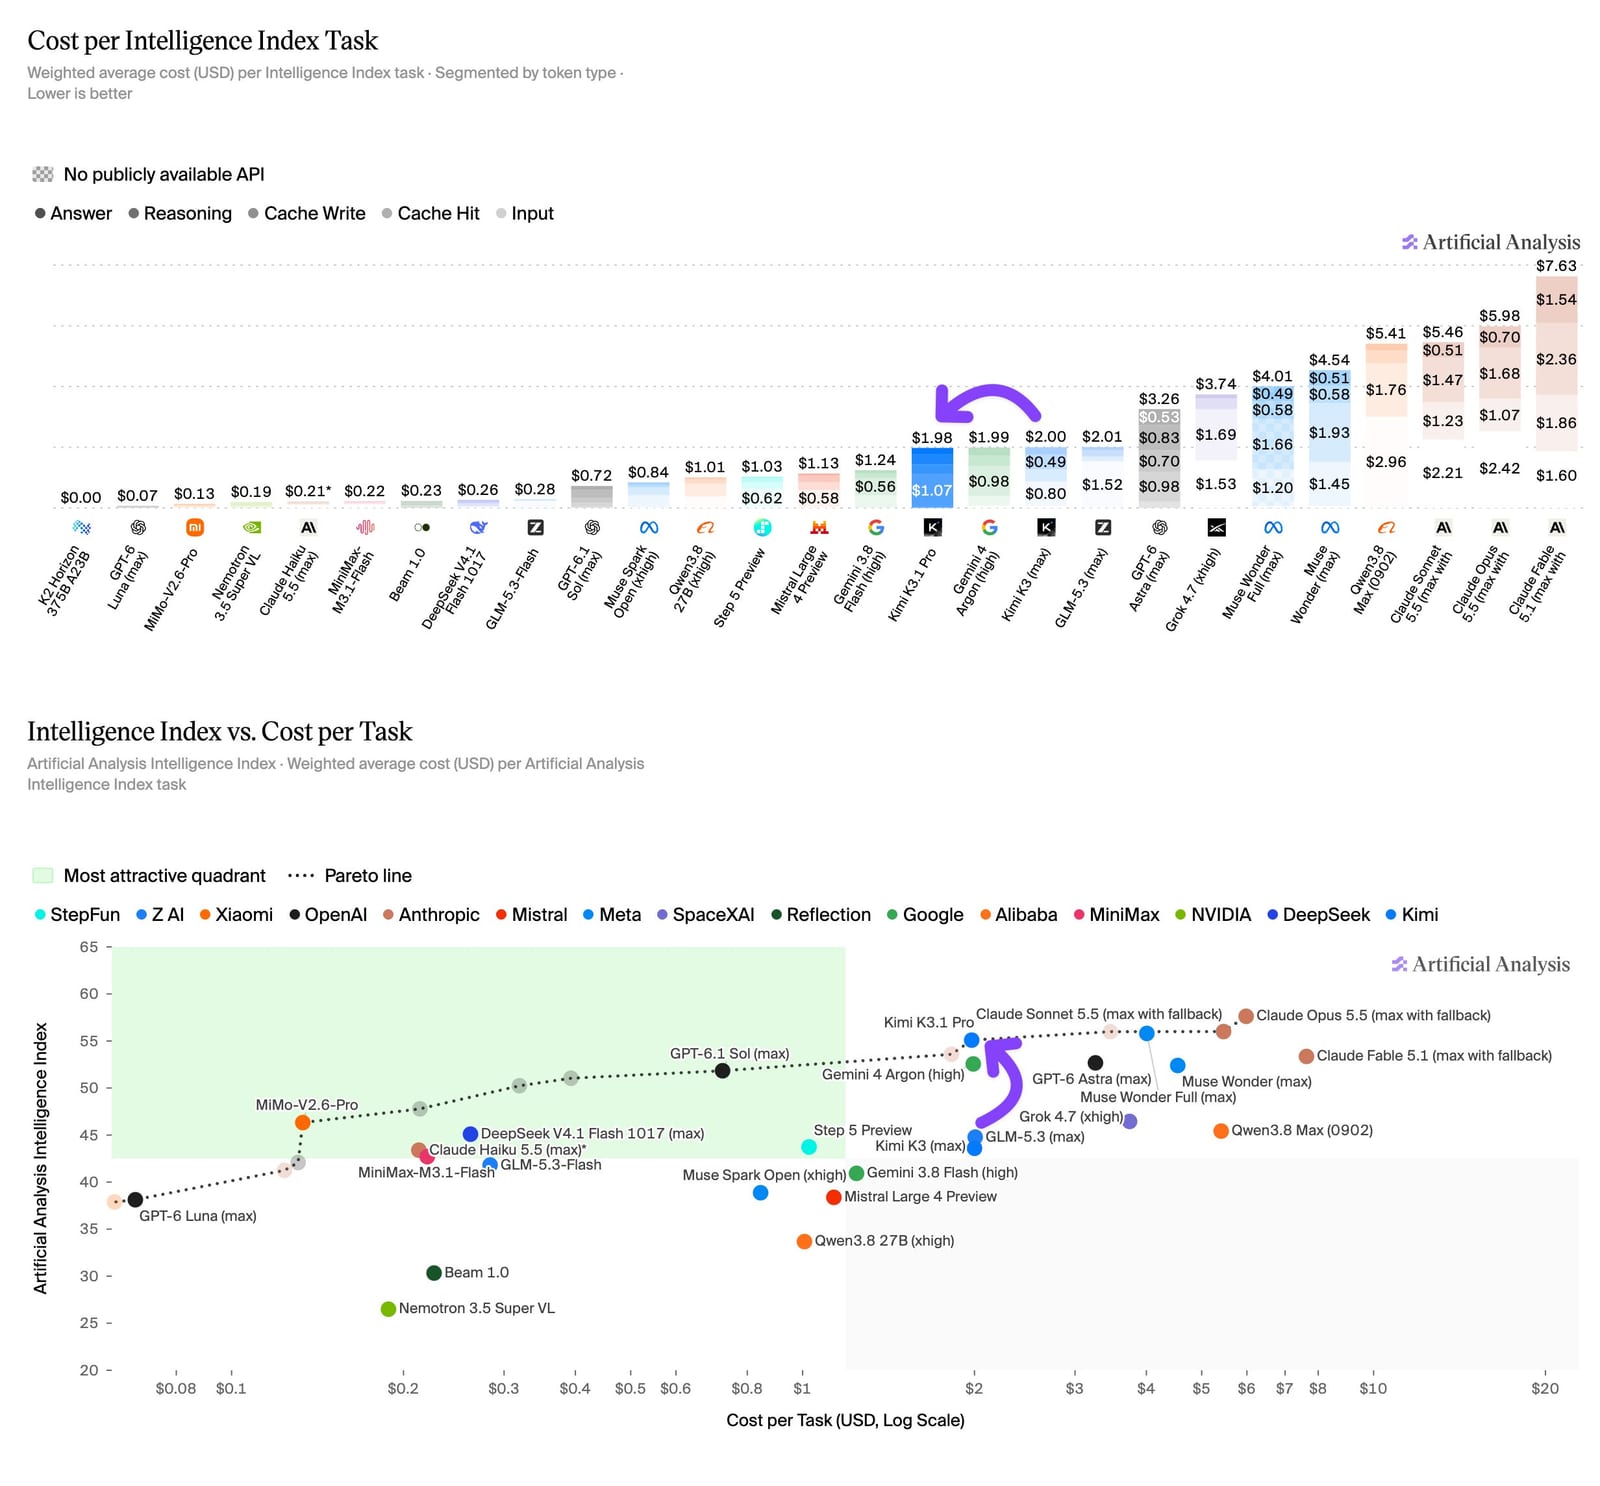
标记价格降低了 33%。输入成本为每百万标记 2 美元(从 3 美元下降),输出成本为 10 美元(从 15 美元下降),缓存命中成本为 0.20 美元(从 0.30 美元下降)。每个智能指数任务成本为 1.98 美元,几乎与 K3 相同(2.00 美元),因为该模型生成了 14% 更多的输出标记。
网络安全和故意限制进攻性能力
Moonshot 在其 技术博客文章 的一个完整部分中讨论了网络安全。该公司表示,随着训练后规模的扩大,漏洞研究能力不断增长,因为与网络相关的內容嵌入到了一般的中期训练语料库中,相关的任务也是 RL 环境混合的一部分。
对于开放权重版本,Moonshot 从两个训练阶段中删除了与网络相关的数据。在其内部 xdev-bench-hard 上,该测试重现了最近披露的 Linux 内核、Node.js 和 JavaScriptCore 等软件漏洞,未清理的版本解决了 90.5% 的任务。数据清理后,K3.1 Pro 解决了 81.0%。DeepSeek-V4.1-Flash 在同一测试中达到了 85.7%,而 Kimi K3 得分为 33.3%。
Moonshot 表示,没有开放权重模型应该推动进攻性网络能力的绝对前沿。同时,该公司希望逐步提高开放模型能做的事情,因为它们也用于防御性目的,如审计遗留系统。Anthropic 之前表明,即使 GLM-5.3,其在 AA 指数上得分为 45,也能以接近 Claude Mythos 的水平编写漏洞利用程序。
无炒作的 AI 新闻 – 由人类编辑
订阅 THE DECODER 以获得无广告阅读、每周 AI 新闻、我们独有的“AI 雷达”前沿报告(每年六次)、完整存档访问以及访问我们的评论部分。
来源: The Decoder · the-decoder.com