Edge0 开源 145B 与 120B 端侧模型及推理框架。
Edge0-145B: Frontier AI Capabilities on Your Own Computer
Edge0 开源 Edge0-145B 和 Edge0-120B 两个端侧模型,并同时发布统一推理框架与部署工具。官方称 145B 模型可在兼容笔记本上本地运行,峰值内存 29GB、解码速度 80+ tokens/s、预填充 1100+ tokens/s,支持 128K–256K 上下文。
原文给出端侧 145B 模型的实测内存、速度与多项基准对比,可据此判断本地运行前沿级模型的现实边界。
今天,我们开源了Edge0-145B和Edge0-120B,以及我们的统一推理框架和部署工具。Edge0-145B是世界上最第一个开源的设备端AI模型,拥有1450亿参数。它将媲美前沿云模型的编码、推理和代理能力带到您自己的电脑上。
设备端AI长期以来在模型能力和硬件运行能力之间迫使权衡。更大的模型需要更多的内存、带宽和电力;较小的模型在处理复杂工作时可能会遇到困难。将工作移到云端会增加模型提供者的费用、数据处理限制,并依赖于连接性。
这次发布通过四种方式解决了这些限制:
| 限制 | Edge0-145B使什么成为可能 |
|---|---|
| 大型模型难以在个人硬件上运行。 | 一个145B的模型可以在兼容的笔记本电脑上本地运行,据报道峰值内存为29GB,解码速度超过80个token/秒。 |
| 小型设备端模型在要求高的任务上可能会不足。 | 编码、推理和指令遵循的结果与特定的前沿云模型具有竞争力,如下面的比较所示。 |
| 一个有用的助手需要完成工作,而不仅仅是回答问题。 | 该模型计划、编写和运行代码,调试错误,并直观地检查结果,用于3D场景、游戏、硬件程序和PCB设计等项目。 |
| 云工作流程带来重复费用、敏感数据限制和网络依赖。 | 本地推理不会产生相应的云模型token或API费用;数据可以保留在电脑上,核心功能可以在离线状态下继续工作。硬件和电力仍然需要花钱。 |
我们正在发布完整的技术栈,以便开发人员可以重现结果、评估或微调模型,并将它们集成到自己的产品中。
我们如何使1000亿以上参数的AI在个人电脑上运行
Edge0-145B笔记本电脑性能:内存、速度和电力
Edge0-145B使一个1450亿参数的模型可以在个人笔记本电脑上使用。一个有用的本地模型必须适合内存、快速处理提示、生成速度快到足以使用,并控制功耗。它还需要支持更长的任务。
| 要求 | Edge0-145B报告结果 | 它使什么成为可能 |
|---|---|---|
| 内存 | 29GB峰值内存 | 在不使用服务器的情况下,在兼容的个人笔记本电脑上运行,例如MacBook Pro。 |
| 提示处理 | 1100+ token/秒预填充 | 在生成开始之前处理长提示,包括几十页的代码。 |
| 生成 | 80+ token/秒解码 | 比一个人阅读速度快。 |
| 电力 | 典型功耗约120W | 在报告的设置中,无需降低速度即可持续运行。 |
| 长任务 | 128K–256K上下文 | 在长输入上保持几乎相同的速度,支持扩展工作。 |
我们早期的Edge0-35B手机发布报告峰值内存低于2.5GB。在iPhone 18 Pro Max上,Edge0-35B使用大约2.5GB的内存提供37+ token/秒的性能。Edge0-145B的参数大约是它的四倍;其笔记本电脑比较报告80+ token/秒和28GB峰值内存。这些测量适用于不同的模型和硬件。
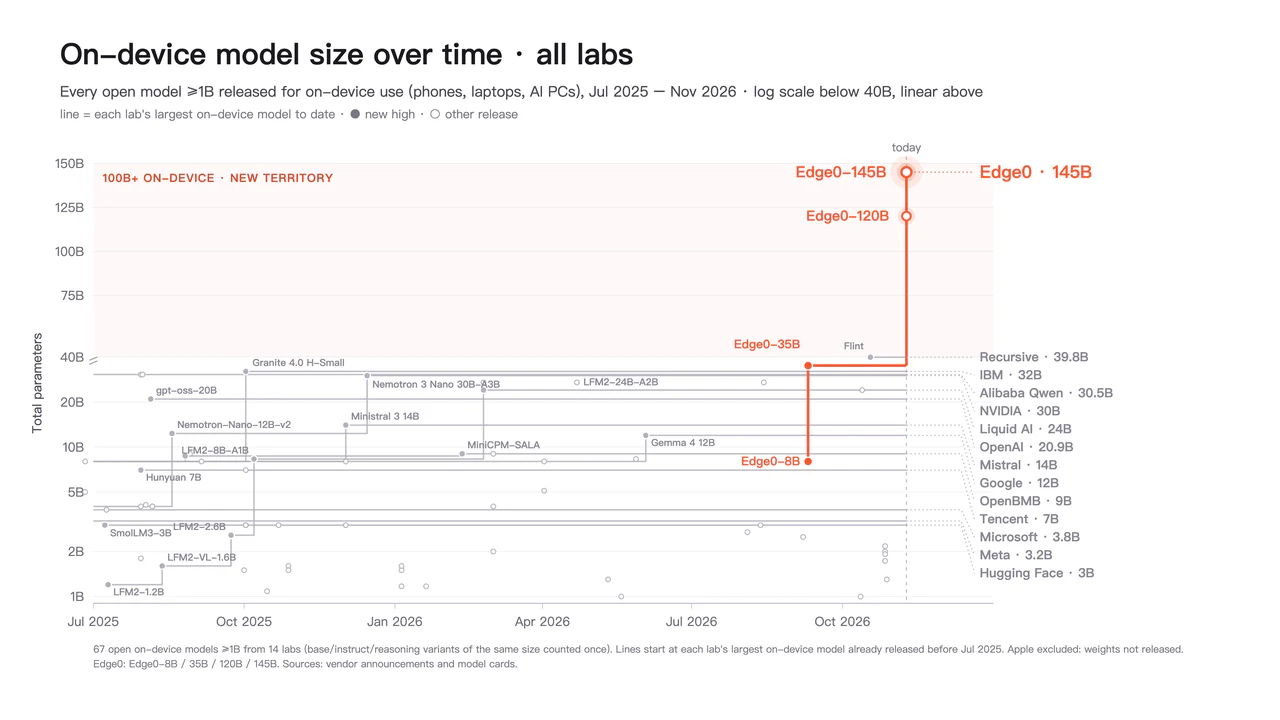
设备上模型随时间扩展。该图表涵盖了14个实验室的67个至少有1B参数的开源模型,旨在用于手机、笔记本电脑和AI PC。相同大小的基础、指令和推理变体只计一次;每条线跟踪一个实验室的最大模型,包括2025年7月之前的发布。实心点标记新的高点,空心点标记其他发布。在40B以下对数刻度,以上是线性刻度。苹果被排除在外,因为其权重未发布。来源:供应商公告和模型卡。
为什么设备上模型保持较小
内存限制在2026年9月之前将大多数设备上模型保持在10B参数以下。苹果智能的设备上基础模型大约有3B参数,而谷歌的Gemini Nano有1.8B和3.25B版本。即使是7B模型也可能消耗大约4GB的内存。
更大的模型面临内存墙。模型权重占用存储空间,在生成时必须读取,与操作系统和其他应用程序争夺有限的内存和带宽。即使是激进压缩的35B模型也可能需要大约20GB的内存,远超手机能提供的内存。
计算、带宽和电源创造了竞争性限制。更大的模型提供了更多的功能,但会拉扯内存容量、生成速度和电池寿命。使模型更小有助于它们适应,通常以牺牲功能为代价。
仅靠隐私无法弥补这一差距。苹果智能保护用户数据,但苹果承认其设备上模型不是为需要通用世界知识的代理应用程序而设计的。普遍的假设是,设备上的人工智能无法与云相媲美。
Edge0的内部结构:模型和推理设计的四层
我们一起设计了Edge0-145B及其推理引擎,以减少使大型模型难以在本地运行的内存和数据移动。设计涵盖架构、训练、加载和调度。
架构:跨稀疏专家共享大型矩阵。共享矩阵大大减少了必须存储和移动的权重,同时保持专家数量不变。每组64个专家共享两个大型矩阵,而每个专家保留一个小参数集,以捕获其差异。以前,每个专家存储一套完整的矩阵。在模型的145B总参数中,每一步推理只有大约10B参数参与计算。
训练:从一开始就为本地执行而构建。我们从一开始就在其设备上架构中训练模型,部署约束被构建到其设计中。这避免了在训练云模型后将本地部署视为压缩或剪枝步骤。
加载:GPU内存、系统内存和SSD访问的管道。读取和计算在三个存储层中重叠,避免了串行等待。经常使用的“热专家”保留在GPU内存中。一个大约40GB的专家库位于系统内存中,当需要时,专家被带入GPU内存。大约48GB的词汇数据驻留在SSD上,按需读取。
调度:同时使用CPU和GPU。GPU计算缓存的专家,而CPU并行处理剩余的工作。推测解码一次验证多个候选标记,将读取权重的成本分摊到更多的输出标记上。这些选择支持报告的80+ tokens/s解码率。
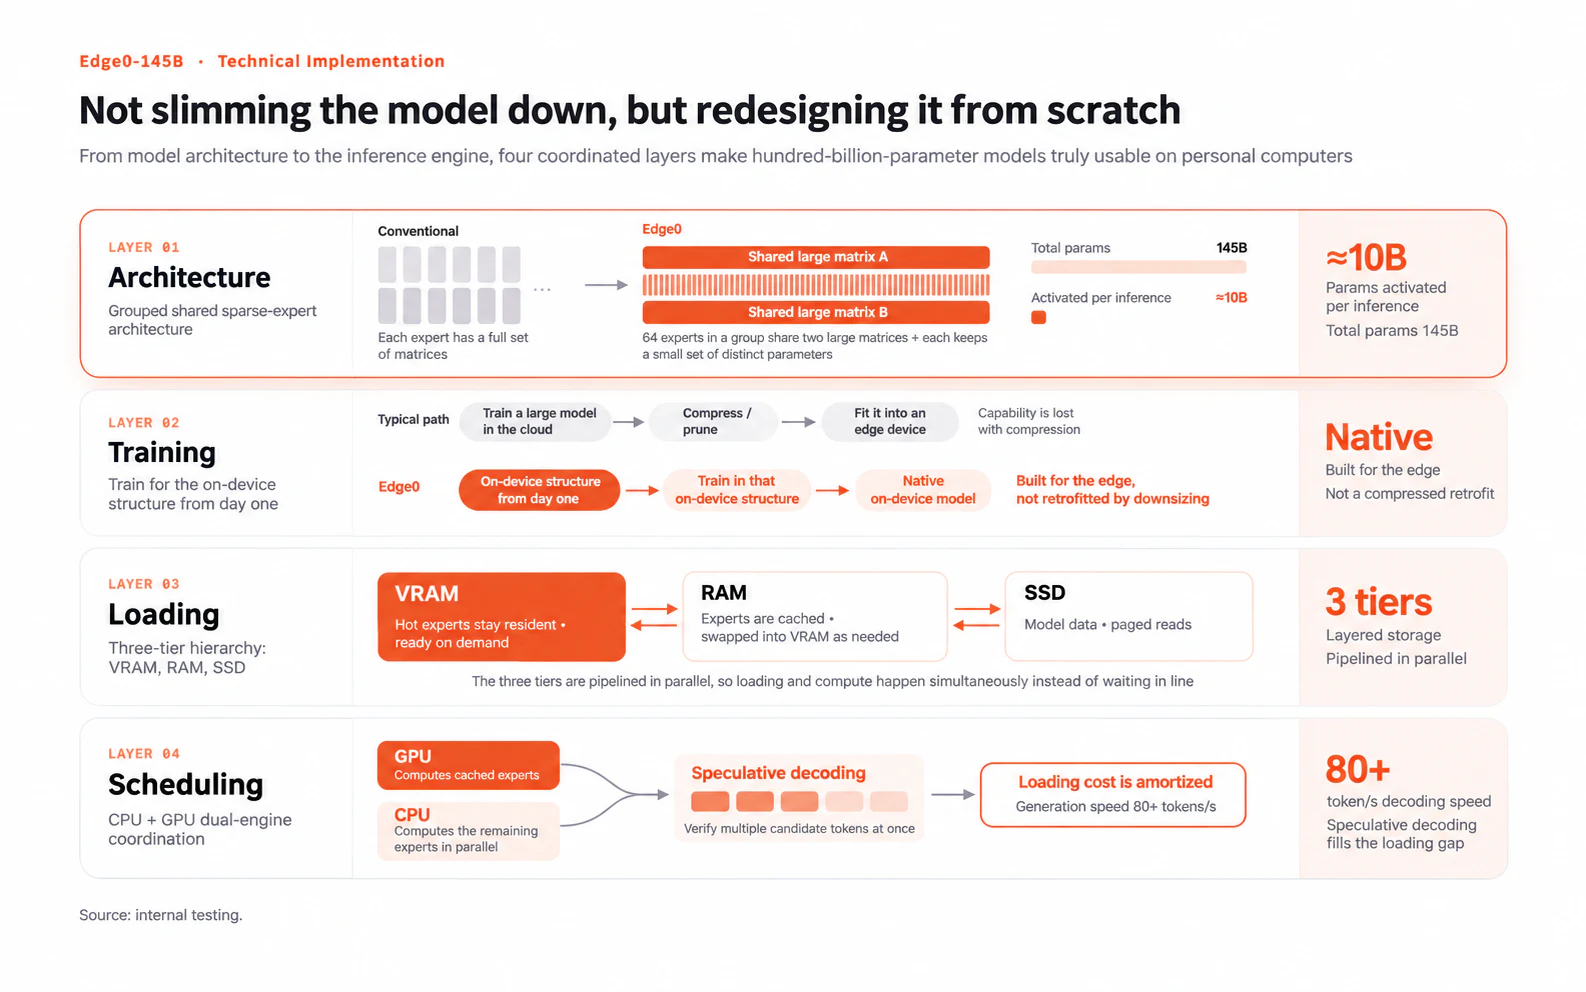
模型和推理引擎的设计工作协同,使得百亿以上参数的推理在个人电脑上成为可能。来源:内部测试。
这些改动使得参数数量从数十亿增长到超过百亿,而内存使用、功耗和延迟没有成比例的增加。
Edge0 能做什么:从聊天到复杂工作,一切都在你的电脑上
Edge0-145B 能够将复杂任务执行到可用结果。它的编码和推理能力支持本地工作流程,结合了规划、工具使用、执行、调试和视觉检查。基准测试确立了它的能力;演示展示了它如何运用这些能力。
与前沿云模型的编码和推理能力相当
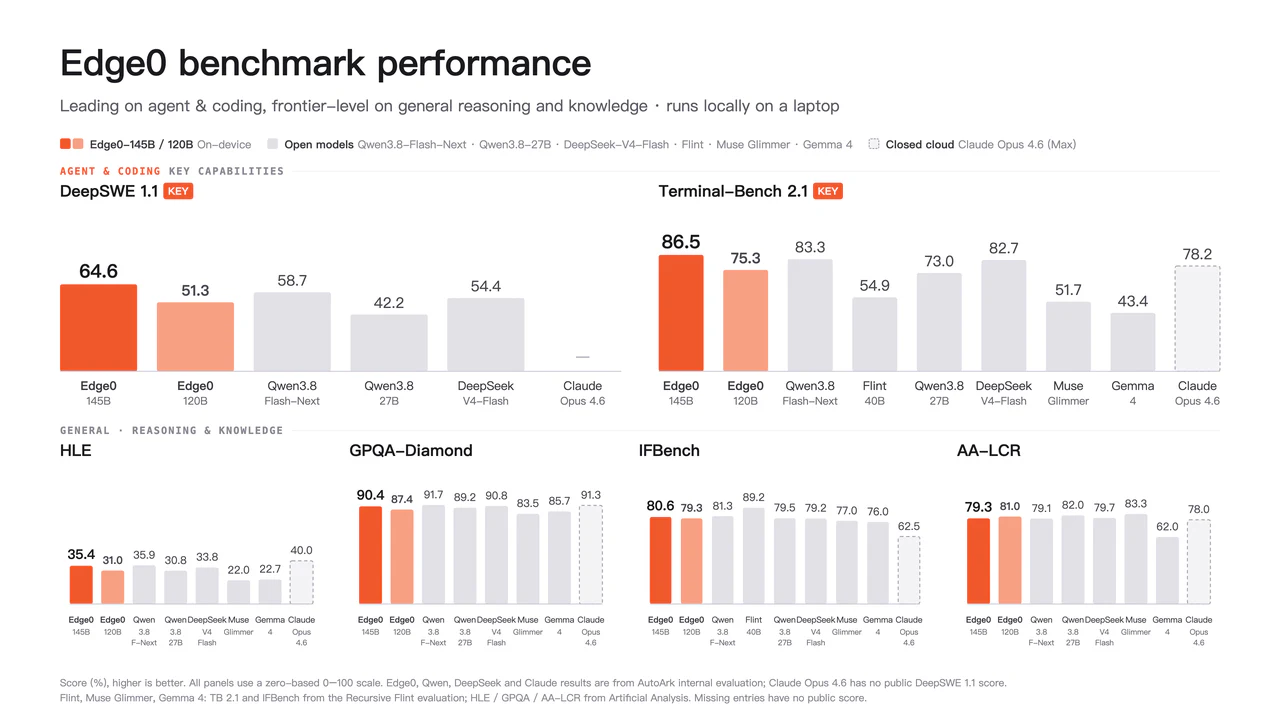
Edge0-145B 在编码、推理、知识和指令遵循方面与特定的前沿云模型具有竞争力:
- 编码:它在 DeepSWE 1.1 上得分 64.6,领先于 Qwen3.8-Flash-Next 的 58.7 和 DeepSeek-V4-Flash-0731 的 54.4。
- 推理和知识:它在 GPQA-Diamond 上得分 90.4,接近 DeepSeek-V4-Flash-0731 的 90.8 和 Claude-Opus-4.6 \(Max\) 的 91.3。
- 指令遵循:它在 IFBench 上得分 80.6,领先于 DeepSeek-V4-Flash-0731 的 79.2 和 Claude-Opus-4.6 \(Max\) 的 62.5。
它的 86.52 在 Terminal-Bench 2.1 也超过了 Qwen3.8-Flash-Next 的 83.3、DeepSeek-V4-Flash-0731 的 82.7 和 Claude 的 78.2。在 AA-LCR 上,Edge0-145B 得分 79.3,Claude 得分 78.0。这些比较适用于所提及的模型和评估。
| 模型 | DeepSWE 1.1 | Terminal-Bench 2.1 | HLE | GPQA-Diamond | IFBench | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.52 | 35.4 | 90.4 | 80.6 | 79.3 |
| Edge0-120B | 53.6 | 81.3 | 31.0 | 87.4 | 79.3 | 81.0 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 35.9 | 91.7 | 81.3 | 79.1 |
| Qwen3.8-27B | 42.2 | 73.0 | 30.8 | 89.2 | 79.5 | 82.0 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 33.8 | 90.8 | 79.2 | 79.7 |
| Flint 40B | — | 54.9 | — | — | 89.2 | — |
| Muse Glimmer | — | 51.7 | 22.0 | 83.5 | 77.0 | 83.3 |
| Gemma 4 | — | 43.4 | 22.7 | 85.7 | 76.0 | 62.0 |
| Claude-Opus-4.6 \(Max\) | — | 78.2 | 40.0 | 91.3 | 62.5 | 78.0 |
得分是百分比;越高越好。短横线表示没有公开得分,而不是得分为零。
Edge0、Qwen、DeepSeek 和 Claude 的结果来自 Edge0 的内部评估。Claude-Opus-4.6 没有公开的 DeepSWE 1.1 得分。对于 Flint、Muse Glimmer 和 Gemma 4,Terminal-Bench 2.1 和 IFBench 的结果来自 Recursive Flint 评估;HLE、GPQA 和 AA-LCR 的结果来自 Artificial Analysis。
与主流设备模型基线 Qwen3.8-27B 相比,最大的提升在于代理和编码工作:在 Terminal-Bench 上提升 18.5%,在 DeepSWE 上提升 53.1%。在 HLE、GPQA 和 IFBench 上的相对提升分别为 14.9%、1.3% 和 1.4%。
DeepSWE 1.1 和 Terminal-Bench 2.1 评估代理和编码工作。HLE、GPQA-Diamond 和 IFBench 涵盖推理、知识和指令遵循。完整的评估设置、硬件环境和复现说明将随我们的技术报告发布。
具有较小内存占用的高竞争力
Edge0-145B 结合了在六个基准测试中的 72.8 平均得分和 29GB 测量的峰值内存。Qwen3.8-Flash-Next 平均 71.7,标准 4 位部署估计占用 70GB。这使得 Edge0-145B 大约是估计基线内存的 40%,同时提供相当或更高的能力,使得在 48GB 笔记本电脑上实现本地使用成为可能。
| 模型 | 六个基准测试的平均得分 | 内存占用 \(测量或估计\) |
|---|---|---|
| Edge0-145B | 72.8 | 29GB |
| Edge0-120B | 68.9 | 29GB |
| Qwen3.8-27B | 66.1 | 大约 18GB* |
| Qwen3.8-Flash-Next | 71.7 | 大约 70GB* |
| DeepSeek-V4-Flash-0731 | 70.1 | 大约 87GB* |
这些方法包括 DeepSWE 1.1、Terminal-Bench 2.1、HLE、GPQA-Diamond、IFBench 和 AA-LCR。Edge0 内存数据是内部峰值测量值。带星号的基线数据是标准 4 位部署的估计值,尚未测量。Claude 被排除在外,因为它仅支持云端且没有 DeepSWE 分数。
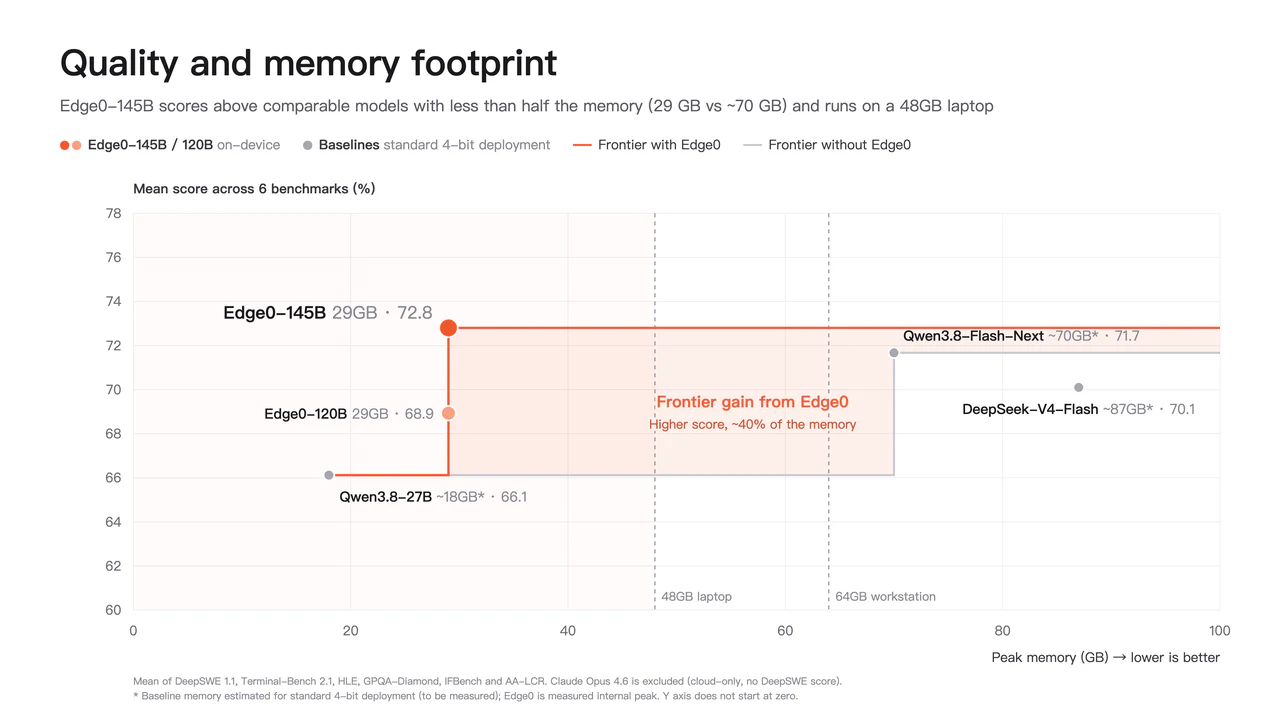
[图:质量与峰值内存对比,标明了 48GB 笔记本和 64GB 工作站的容量。内存越低、分数越高越好;图表的垂直轴不从零开始。]
本地代理可以规划、编码、运行和检查它们的工作
单个自然语言请求可以启动整个本地工作流程。Edge0-145B 拆分需求,规划步骤,编写代码,并调用工具来运行它。当出现问题时,它会调试和修复代码。然后它截取屏幕截图来检查结果,并不断迭代直到工作完成。
这些项目通常需要几十轮的规划、执行和审查。本地推理意味着这些额外的对话、代码修订和视觉分析不会产生相应的云端模型令牌或 API 费用。代码和数据可以保留在计算机上,核心模型功能可以离线工作。
视频制作:在小时内生成特斯拉 Model S 的解释视频
Edge0-145B 生成了一段关于 Model S 如何飞行的解释视频,处理了技术研究、剧本创作、资源生成和编辑。我们要求它使原理对普通观众易于理解。该模型在本地运行,没有调用云端模型或消耗云端令牌,避免了推理的网络往返。
视频在小时内生成。手动制作同等作品需要导演和编剧、3D 模型师、编辑和物理专家至少一个月。AI 视频工作流程以前可能超过数百美元;本地推理消除了相应的云端模型令牌和 API 费用。
3D 建模:在 Blender 中创建曼哈顿城市场景
Edge0-145B 在小时内构建了一个曼哈顿的 3D 场景。从文本和参考图像在 Blender 中工作,它构建了场景,调整了材质和光照,并对渲染输出进行了迭代。
该工作流程将视觉检查、代码生成和修订结合在 Blender 内部。该模型处理对象、空间关系和创意目标,超越了参考图像中的像素。它检查结果,编写代码并进行更改,而无需将这些步骤交还给人类。整个流程保持本地。
手动创建曼哈顿规模的城市场景通常成本约为 $12,000-18,000,并至少需要一个月。领先的云端模型仍然会产生超过 $150 的云端令牌费用。Edge0-145B 完成本地推理,没有这些云端模型令牌费用。
游戏开发:可玩游戏和一座中世纪城市
Edge0-145B 可以在本地创建可玩游戏。我们还利用其 3D 建模能力为奇幻 RPG 创建了一个原创的中世纪首都,并以游戏预告片质量渲染了一个 20 秒的飞越。
该模型独立规划了城市,并在 Blender 中从零开始构建:城市城墙、一千多座老城区房屋、广场喷泉、哥特式双塔立面、肋拱中殿和彩色玻璃窗。
固定的相机路径使错误变得明显。几何裁剪、遮挡或错误的比例会沿着路线出现,因此模型在构建过程中检查渲染结果并修正其工作。整个工作流程完全在本地运行。
一个领先的云模型需要数百个工具调用和数亿个令牌来完成一次,使用相同的提示、参考图像和相机路线。Edge0-145B 在笔记本电脑上完成了它,而没有云模型令牌或 API 费用于本地推理。一个艺术团队通常会花费数周和数千美元来制作一个符合这种标准的城市场景。
硬件控制:飞行的真实无人机代码
Edge0-145B 根据一条指令编写了真实无人机的程序:“编写一个无人机程序,它可以通过障碍物并找到一个红色的背包。”
它在本地生成了飞行控制和视觉识别程序。无人机然后在室内起飞,穿过密集的障碍物杆,自主搜索,并找到了墙边的红色背包。这项任务不需要人类编写的代码,也不需要云调用。
硬件开发人员可以描述他们想要的行为,并让模型将其转换为真实设备的程序,而无需在编辑器、文档和调试工具之间反复切换。
PCB 设计:从 KiCad 布局到组装动画
Edge0-145B 从元件放置开始,通过组装可视化来完成 PCB 设计。我们要求它为自己设计一个板子。它在 KiCad 中从零开始,放置元件,布线双层板,并将设计导入 Unreal Engine 5。然后它设置了相机和灯光,并渲染了 PCB 制造和组装的动画。
一台计算机完成了以前需要硬件工程师和 3D 设计师在几天内手头任务来回传递的工作。原理图和板布局可以保留在团队自己的硬件上,支持商业秘密保护和数据处理要求,而无需将设计上传到云模型。
为什么选择 Edge0:用于设备上的人工智能完整堆栈
要在设备上使用的人工智能需要模型开发、推理工程和硬件适配协同工作。我们的进展依赖于三个能力:快速开发互补模型、优化完整堆栈,以及将每次部署的经验带到下一次部署中。
我们 9 月份发布的 Edge0-35B 展示了这种方法在手机上可以提供什么。它的发布帖子在第一天没有付费推广的情况下,在海外社区通过了 120 万次观看。OpenAI、NVIDIA、高通和其他公司的研究人员和技术专家分享了它,该模型在 Hugging Face 的整体趋势榜单上达到了第 1 名。
我们发布了模型权重和统一的推理框架,为公司和研究人员提供了一个他们可以重现的标准方法。发布帮助将设备上人工智能的讨论从几十亿个参数提升到了 35B 级别。
用于设备上的人工智能的四个模型系列
在过去的一年里,我们发布了四个系列中的 200 个模型。每个系列处理工作的一部分,从听和说,到快速决策、记忆和复杂的代理任务。
| 模型系列 | 角色 | 模型和能力 |
|---|---|---|
| Edge0 | 复杂的代理任务和氛围编码 | 145B 和 120B 型号适用于笔记本电脑;35B 和 8B 型号适用于手机。笔记本电脑型号支持氛围编码,而手机型号支持代理任务。 |
| Audio8 | 听和说 | ASR-Infinite 和 3B、0.6B、以及 0.1B 的 ASR 模型用于语音识别;0.6B 和 0.1B 的 TTS 模型用于语音合成;以及一个 0.1B 的 Chat 模型用于端到端的语音交互。 |
| 决策0 | 快速决策 | 0.6B 和 3B 模型覆盖文本、语音和视觉,支持大约 40 毫秒的多模态决策。 |
| 嵌入0 | 内存 | 一个 0.6B 的多模态嵌入模型用于文本、语音、图像、视频和文件,支持本地长期记忆和检索增强生成(RAG)。 |
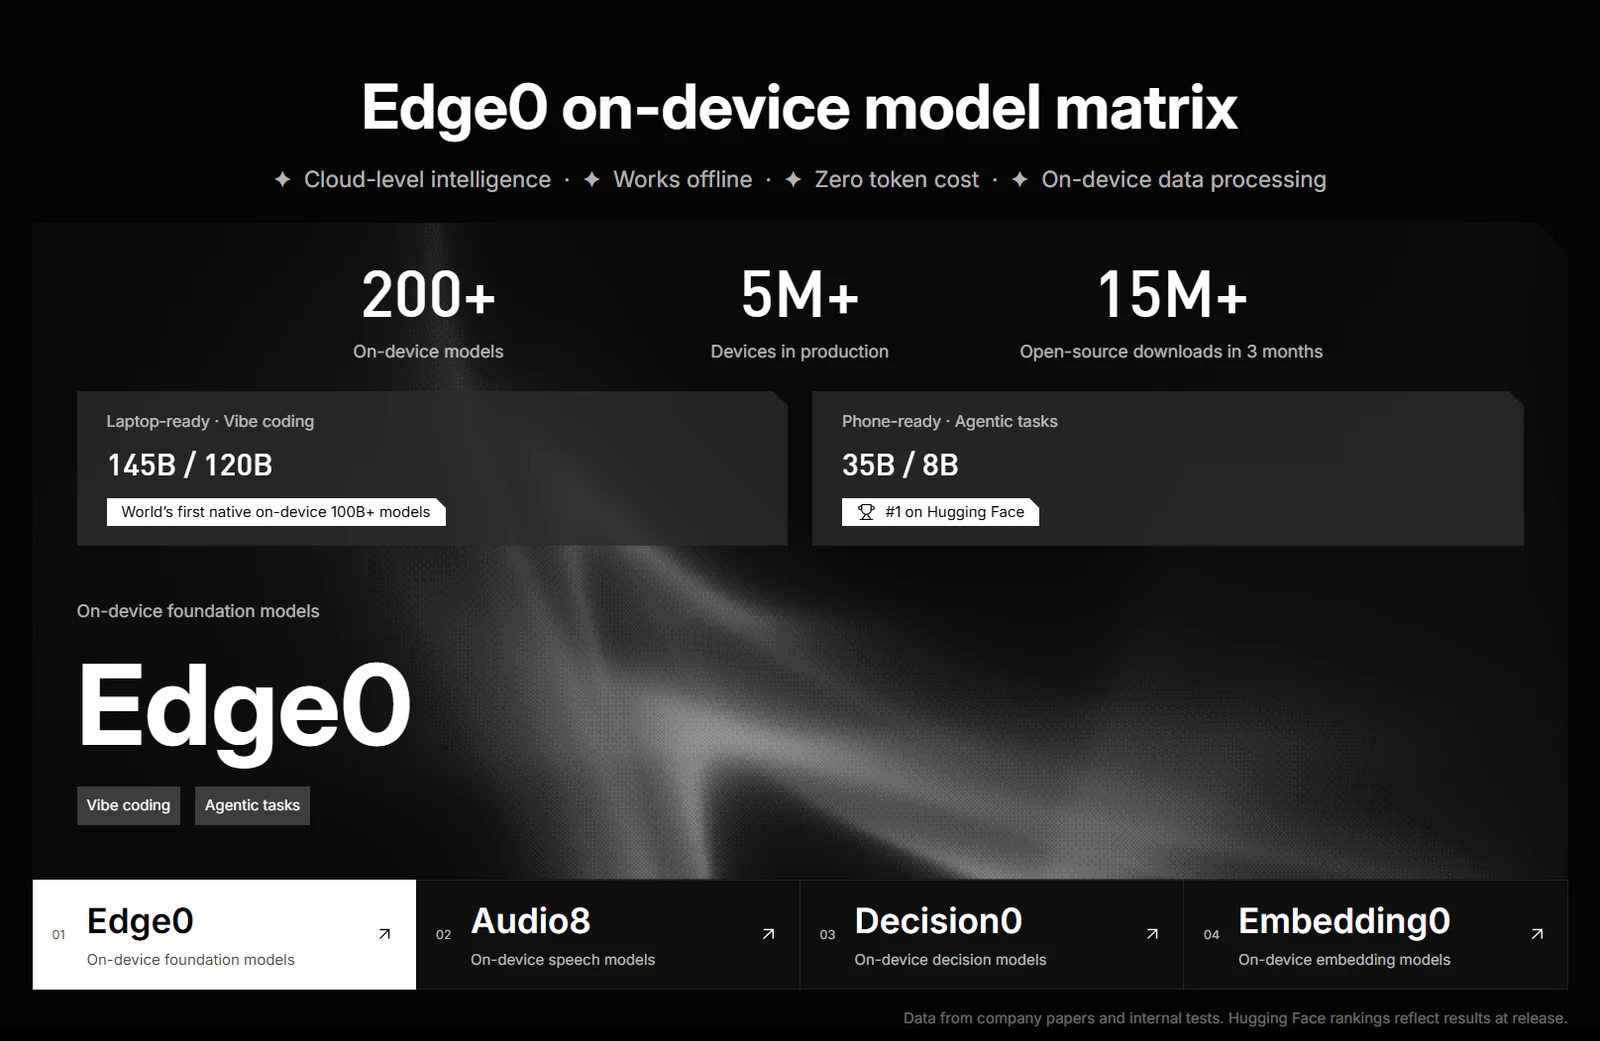
该产品组合涵盖数千万到超过百亿个参数。Edge0 和 Audio8 都已在 Hugging Face 的热门榜单上达到第一。
模型与推理系统共同设计
我们共同开发模型和推理框架,将硬件约束纳入训练,并针对不同的芯片优化引擎。这连接了模型能力与使用它所需的软件和硬件。
这项工作需要模型开发、推理框架和底层硬件适配的专业知识。对于只专注于模型开发的公司来说,很难复制这种组合。
深入到每个部署的硬件优化
每次部署都为我们下一款芯片、模型或产品提供了可重复使用的优化。这很重要,因为设备上的硬件是碎片化的:NPU 架构不同,对 INT4、INT8 和 FP4 等数值格式的支持也不同。通用模型无法自动充分利用每一款芯片。
我们适应各个平台。我们的产品组合现在覆盖了 95% 的主流芯片平台,包括高通、BES、瑞芯微、全志、D-Robotics 和英伟达,涵盖耳机、眼镜、手机、PC 和机器人。这是产品组合的全面覆盖;模型需求各不相同,并不意味着每一款设备都能运行 Edge0-145B。
部署工作现在覆盖了超过 500 万台生产设备。我们的开源模型在三个月内下载量超过 1500 万次。到 2026 年 10 月,我们已有超过 11 万家客户组织。
产品组合数据来自公司论文和内部测试。它们描述了更广泛的 Edge0 产品组合;本文中的 145B 性能结果特指 Edge0-145B。
对于 Edge0-145B,第一天支持 macOS、Windows 和 Linux,包括苹果 M 系列芯片和英伟达平台,如 RTX Spark、RTX 4090 和 RTX 5090。发布包含一键部署工具和硬件指南。
设备端 AI 与云的未来
随着本地模型接近云级能力,更复杂的工作可以留在设备上。隐私、成本控制和离线访问长期以来都倾向于本地执行;剩下的问题是设备上的模型能否完成工作。Edge0-145B 扩展了其可以处理的任务范围。
为什么更多 AI 工作可以留在本地
本地执行解决了采用纯云 AI 的四个实际障碍:
- 控制云模型成本。本地推理随着使用增长不会增加相应的云模型 token 或 API 费用。
- 将敏感数据保留在本地。代码、文档和业务记录可以保留在硬件上,让团队控制数据处理。
- 保持响应式体验。模型和推理引擎设计共同解决响应速度、功耗、系统响应性和持续运行。
- 确保核心功能离线可用。 连接中断时,本地任务可继续;依赖在线信息或服务的功能仍需连接。
从云优先到更复杂的设备端工作
我们看到设备端和云端的工作分配经历了三个阶段。
2026年9月前:云优先,支持设备端。 苹果智能反映了这一阶段:它保护隐私,但在本地处理有限范围内的任务,而更复杂的工作则依赖云端能力。
2026年9月10日Edge0-35B发布后:日常任务在设备端,复杂任务在云端。 本地模型可以处理需要即时响应的频繁请求。对于一家领先的耳机制造商,我们的混合解决方案现在在设备端处理92%的AI使用,在云端处理8%。在消费类可穿戴设备上,日常对话占大多数用例。
Edge0-145B:向设备端优先发展,支持云端。 Vibe编码和其他复杂任务现在可以在个人电脑上运行,让团队有更多选择本地执行的空间。这扩展了可以留在设备端的工作范围,同时保留云端用于需要它的任务和硬件。
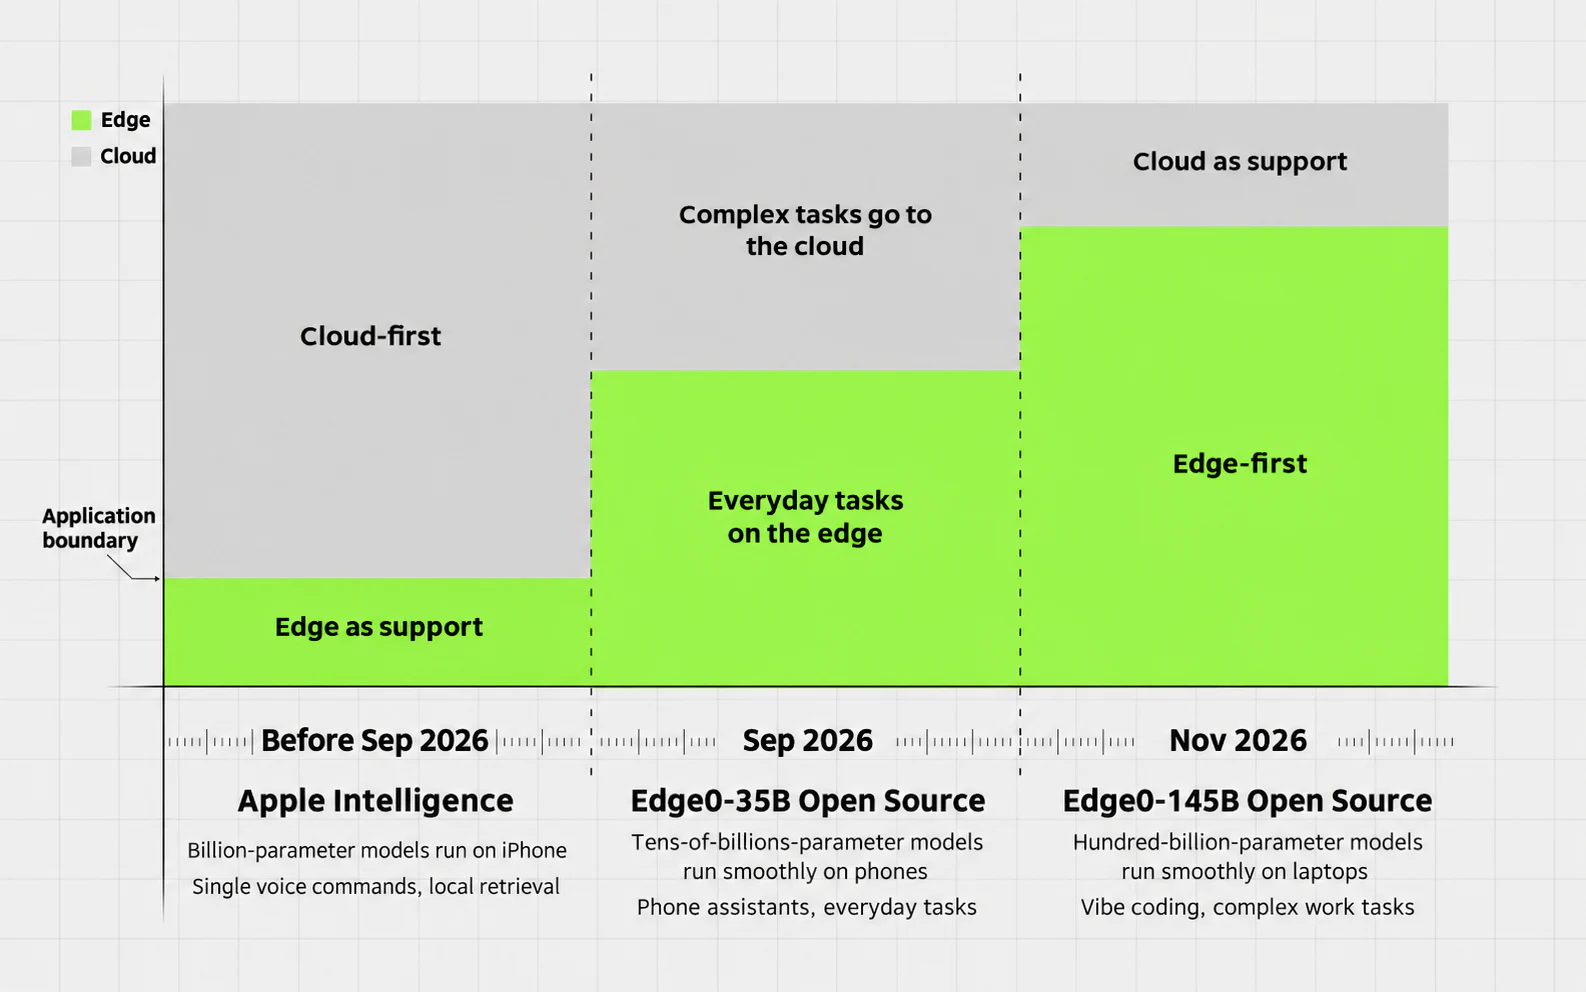
该图表显示了从云优先AI到日常本地任务,再到更复杂的本地工作的转变。其彩色区域是示意图,不是衡量使用份额的。
云AI的适用场景
硬件限制决定了哪个模型适用。计算能力、散热和电池寿命都很重要:Edge0-35B运行在手机上,而Edge0-145B运行在配置合适的笔记本电脑上。计算能力非常低的设备目前无法在本地运行145B模型。它需要一个适合其硬件的小模型,或者需要云访问该规模的模型。
跨设备长期记忆和需要高度即时信息搜索仍然需要云服务。本地和云模型可以协同工作;适当的分割取决于任务、硬件以及它需要的信息。
目标是让本地执行成为高要求工作的实用选择,并配备一个能够在用户附近持续工作的强大模型。这是实现我们每个人都能实现零距离智能的目标的下一步。
开始使用Edge0
下载模型以本地运行,评估或微调它们,并将它们集成到您自己的产品中:
- 模型权重: Edge0-145B 和 Edge0-120B 在 Hugging Face 上。
- 推理框架和部署指南: Edge0 on GitHub。
- 无需环境设置即可尝试: 下载Edge0 App。其核心模型功能离线工作,无需帐户或使用配额。
- 社区: 加入我们的Discord。
对于硬件或产品集成,通过GitHub或 [email protected] 联系Edge0团队。
来源: Hacker News · AI 热帖 · edge0.ai