IT之家 · AI精选7575
开源项目 GPU Unlock 可释放 RTX 30 系列显卡隐藏 AI 算力,实测提升最高约 60%
GitHub 用户 Zagitta 开发的开源项目 GPU Unlock 可解除安培架构消费级显卡在 FP16/BF16 张量核心运算中的指令发射速率限制,无需修改驱动或刷写 VBIOS。
推荐理由: 原文给出多张 RTX 30 显卡在 GEMM 与图像生成负载下的实测提升数据,也标明了显存带宽等限制。
IT之家 · AI精选7575GitHub 用户 Zagitta 开发的开源项目 GPU Unlock 可解除安培架构消费级显卡在 FP16/BF16 张量核心运算中的指令发射速率限制,无需修改驱动或刷写 VBIOS。
推荐理由: 原文给出多张 RTX 30 显卡在 GEMM 与图像生成负载下的实测提升数据,也标明了显存带宽等限制。
 Google Developers Blog
谷歌 AI 边缘团队开源 ML Drift,这是一个高性能、跨平台的边缘设备 GPU 计算引擎,用于设备端 AI/ML 推理。通过抽象 OpenGL ES、OpenCL、Metal 和 WebGPU 等硬件低级 API 的复杂性,ML Drift 使开发者能构建实时交互式 AI 体验。
 Prime Intellect Blog
Prime Intellect Compute 平台正式上线,聚合全球 GPU 资源以实现即时计算的民主化。平台提供统一资源池,支持单 GPU 到 512+ GPU 集群的即时访问,首批整合 12 家云服务商,H100 GPU 时价 1.5-4 美元/小时。
 PyTorch Blog
EUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 IBM Research Blog3636
ORNL、IBM 和 AMD 在 IBM 纽约波基普西园区部署量子纠错(QEC)协同设计平台,将 IBM Quantum Nighthawk r2 处理器与 ORNL Umbra HPC 系统整合,后者包含 AMD Instinct MI355X GPU 和 5th Gen AMD EPYC™ CPU,为混合 HPC-量子计算环境中的算法开发与验证提供低延迟量子-经典执行能力。
 NVIDIA Blog
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
vLLM Blog精选6060vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。
推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。
 Cohere Blog5858
Cohere Model Vault 公开测试推出机密计算功能,为托管企业 AI 带来硬件级保护和可验证安全。该功能在 CPU 和 GPU 上运行推理,通过硬件强制隔离保护工作负载内存,并使用 NVIDIA 机密计算技术加密 GPU 内存和 CPU 与 GPU 之间的流量。客户可在发送敏感数据前验证处理环境,包括硬件、固件和软件配置,确保数据在推理过程中得到保护。
 Databricks Blog
Databricks AI Runtime (AIR) 已正式发布,支持开发者使用 NVIDIA NeMo、NGC 容器和 Nemotron 新菜谱在无服务器 NVIDIA GPU 上训练和微调开放模型。
 Meta Engineering
Meta 完成了 Prometheus 超级集群的首阶段建设,该集群计划扩展至约 100 万个 GPU,采用闭环液体冷却技术,目前运行 Muse 大型语言模型。
 Inception Labs Blog
Inception Labs 推出全球最快推理大语言模型 Mercury 2,基于扩散模型架构,在 NVIDIA Blackwell GPU 上实现 1,009 tokens/秒生成速度。
Prime Intellect BlogPrime Intellect Lab 发布,提供端到端模型训练平台,整合 Environments Hub、托管训练与托管评估,支持大规模智能体强化学习、推理和评估,无需管理 GPU 集群或算法细节。平台基于环境构建,包含任务数据集和执行器,已通过私有测试完成超 3000 次强化学习运行。
Cohere BlogCohere 发布企业级 AI 平台 North,通过安全访问工作数据,结合生成式搜索模型、可定制智能体和内置工作流自动化,帮助员工提升任务效率和质量。该平台支持私有化部署,最低仅需两块 GPU 即可运行,已获 RBC、Dell 等企业采用,覆盖金融、医疗等关键行业,并具备细粒度权限控制、自主策略和合规认证等安全特性。
Prime Intellect BlogPrime Intellect 发布 SYNTHETIC-2 数据集,包含四百万条经验证的推理轨迹,涵盖迄今最全面的复杂强化学习任务和验证器。该数据集通过全球计算贡献者的管线并行分布式推理协作生成,1,253块 GPU(包括49个8xH200节点、43个8xH100节点及大量消费级3090和4090 GPU)在3天内参与创建。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。
NVIDIA Blog5555GeForce NOW 将引入《战锤40,000:战争之黎明IV》,支持云游戏体验克洛努斯之战;DLSS 5 技术将登陆《战争 thunder》和《Where Winds Meet》,性能较前版提升十倍;本周新增 10 款游戏入库,包括《龙之信条2:暗裔觉醒》等。
 Baseten Blog6262
Baseten 将 ~770 GB GLM-5.3 模型的增量权重同步时间从 36 秒缩短至 15 秒,暂停时间从 6 秒降至 0.8 秒,吞吐量提升 3.2 倍。
 MarkTechPost同一件事 · 2 家
Baseten 发布了 joey-1,一款 2B 参数决策模型,返回标签和校准概率而非生成文本,用于高容量路由、分类和护栏检查,每百万输入 token 价格为 0.01 美元,权重在 Hugging Face 上以 MIT 许可证开源。
各家口径不同:Baseten Blog 表示模型在参数量≤3B时表现最佳,而 MarkTechPost 提到的是 2B 参数模型。
Baseten Blog2222Postman 的智能体栈包含 Passport、Fabric、Astropods 和 Fern 四个产品,用于准备 API、控制系统访问和治理智能体行为。Baseten 作为 Postman 推荐的企业团队推理伙伴,提供快速、可靠且经济高效的推理基础设施,支持多种模型,如 Beam 1.0 和 DeepSeek V4.1 Flash,在吞吐量和延迟方面排名靠前。
 Hugging Face Blog精选同一件事 · 3 家8585
Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Meta EngineeringMeta Andromeda 下一代广告检索引擎通过模型-系统协同设计,在检索层实现近排名级模型性能,单卡单秒处理超过 10 亿广告,系统吞吐量达 1000 亿次/秒,较 2024 年版本提升 100 倍,并为广告主带来 2.4% 的转化率增长。
MarkTechPost精选同一件事 · 5 家8383Moonshot AI 发布了 K3.1 系列首个模型 Kimi K3.1 Pro,采用 MoE 架构,总参数 2.8T、激活参数 104B,支持 1M token 上下文,已在 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 上线,API 定价为每百万 token 输入 2 美元、输出 10 美元,低于 K3 的 3 美元和 15 美元。
各家口径不同:Artificial Analysis 提供了 55 分的评分并排名第四;MarkTechPost 提到了 2.8T 的总参数和 104B 激活参数的 MoE 模型。
Prime Intellect Blog3838Prime Mega MoE 通过融合反向传播内核,使 DeepSeek 的 Mega MoE 内核可用于训练,相比默认 PyTorch 实现 MoE 内核速度提升高达 3.11 倍,相比 Prime-RL 基线端到端训练速度提升 1.34 倍。
 The Verge · AI6565
Meta 在财报电话会议上宣布其个人 AI 代理 Muse 已在美国和加拿大下载超过 1000 万次,其中四分之一用户日均使用。扎克伯格称 Muse 将在未来几年实现高利润,并构建一个让个人代理相互交互的“大型 Muse 网络”,预计将产生比 Instagram 和 Facebook 更高的用户收入。
Cohere Blog5858Cohere 发布 Rerank 5 Pro 和 Fast 两个版本的企业文档检索模型,Pro 版在 ViDoRe V3、nanoMTEB、BRIGHT 和 BEIR 等主要公开基准上领先,Fast 版以更低成本提供接近领先的性能。
NVIDIA BlogNVIDIA 在 GTC Berlin 上展示了其本地 AI 硬件全阵容,RTX Spark 已上线支持 Windows PC 上的个人智能体,DGX Spark 支持开发者构建和扩展 Linux 应用,DGX Station 则为 Linux 企业团队运行前沿工作负载,Windows 版将于 12 月推出。
Hugging Face Blog精选6262Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
 Modal Blog7575
NVIDIA 将首个 Vera CPU 服务器交付给 Modal,该 Arm 兼容 CPU 通过模拟能力测试使模拟能力沙盒吞吐量提升 2 倍,适用于资源使用峰值可达 10 倍基线的异构工作负载,有助于降低成本并加速强化学习部署。
 Google DeepMind
Gemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中纯推理得分 87%,超越所有前沿模型。Argon 可应用于机器人生命周期的各个环节,包括使用 MuJoCo 进行移动操作练习、零样本机器人控制和视频世界模型的闭环转向。
NVIDIA BlogNVIDIA RTX Spark 将游戏 PC、创意工作室和个人 AI 超级计算机的能力整合为单一超级芯片,配备高达 128GB 的统一内存和 1 petaflop 的 AI 计算能力。
Google Developers BlogGemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中得分 87%,超越所有前沿模型。
 Import AI4242
《人类第六感》评测显示GPT 6 Astra在直观视觉推理任务中pass@1得分53.6,远低于人类基线93.1,其中中国开源模型GLM-5.3-flash和Kimi K3分别得分26.8和25.5。
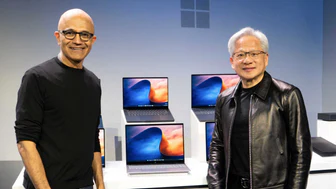
NVIDIA Blog英伟达与微软合作推出 RTX Spark 笔记本电脑和 Windows AI 代理基础设施,支持本地运行 125B 参数 Qwen 3.8 Flash Next 模型;微软发布 MXC 操作系统级容器保障代理安全运行,预购 RTX Spark 从今日起开放,搭配 Grace Blackwell 芯片,提供高达 20 PFLOPS 推理性能。
Google Developers BlogGoogle DeepMind 发布 EmbeddingGemma 2,一款参数量仅 740M 的开放权重多模态嵌入模型,能将文本、图像、视频帧和音频统一映射至单一向量空间。
 SGLang releases7070
SGLang v0.5.21 发布,新增 DeepSeek-V4.1、GigaChat 3.5、IQuest-Q1 等模型及 DiffusionGemma、Qwen-Image 2.1 等。
 Microsoft Research
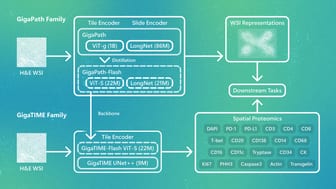
GigaPath-Flash 和 GigaTIME-Flash 通过精简的 ViT-S 编码器显著降低了计算需求,在保留性能的同时使大规模病理学研究更易实现。
 DeepSeek · Hugging Face 新模型
DeepSeek-V4-Flash-Vision-Exp 发布,DeepSeek-V4 家族首个实验性多模态模型,在 DeepSeek-V4-Flash 架构基础上集成视觉模块并持续训练以解锁视觉理解能力。
Prime Intellect BlogReleasing Lab 今日正式对外发布,是 Open Superintelligence Stack 的一部分。该平台支持自改进智能体的全流程训练,用户可指定任务、定义执行环境、评估模型、基于奖励信号训练、检查推理结果、部署适配器并运行推理。
 Cognition Blog
SWE-1.6 在 SWE-Bench Pro 上取得 11% 的更高分数,但存在过度思考和自我验证问题,模型以 950 tok/s 的速度运行。该模型通过改进 RL 算法和扩展基础设施训练,计算量提升两个数量级,目前向小部分用户开放早期访问以收集反馈。