NVIDIA Newsroom3838
NVIDIA 开源工具助力研究人员构建下一代 6G 网络
NVIDIA的开源Aerial和Sionna软件使全球开发者采用量增长10倍、下载量超100万次,被8000多个研究机构使用,支持目标语义通信使机器人任务完成时间缩短52.6%、AI接收器在干扰环境下提升60%上行吞吐量、需求预测系统降低45.6% RAN功耗、GPU加速模拟将仿真时间从3小时压缩至10-20分钟。
NVIDIA Newsroom3838NVIDIA的开源Aerial和Sionna软件使全球开发者采用量增长10倍、下载量超100万次,被8000多个研究机构使用,支持目标语义通信使机器人任务完成时间缩短52.6%、AI接收器在干扰环境下提升60%上行吞吐量、需求预测系统降低45.6% RAN功耗、GPU加速模拟将仿真时间从3小时压缩至10-20分钟。
 OpenRouter Blog6262
OpenRouter 发布新一代 Auto 和 Auto Code 路由器,性能提升 4 倍,路由步骤速度提升 3 倍(p90 0.65 秒 vs 1.96 秒),Auto Code 专为编码优化,与 Claude Opus 5.5 性能相当但成本降低 74%。新路由器通过评估 11 个请求因素并结合实时定价、提供商健康状态和缓存状态进行模型选择,支持任何模型集和治理策略。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 Modal Blog6565
Snorkel 利用 Modal 的 GPU 和 CPU 沙盒每月运行数百万次智能体模拟,支持多种任务评估。通过 Modal 的内存突发功能,Snorkel 将沙盒成本降低了 20%,并提升了运行可靠性。Modal 的无服务器 GPU 和共享/专用推理端点使 Snorkel 能快速部署和测试自定义模型。
 Hugging Face Daily Papers6565
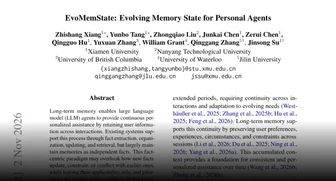
EvoMemState 框架通过关系状态和推理状态增强持久事实,提升长期对话和记忆使用基准测试的检索完整性和记忆响应准确率。该框架包含本体引导的记忆状态归纳、基于强化学习的状态演化和状态感知推理三个组件。
 IT之家 · AI5050
摩尔线程基于 MTT S5000 智算卡及 MUSA 软件栈完成 Kimi-K3.1 Pro 模型 Day-0 适配,支持 100 万上下文,在 Terminal-Bench 4.0 得分 65.7%。该模型是迄今能力最强的 3 万亿级参数模型,在代码与 Agent 基准测试中表现达顶尖闭源模型水平。
 Hugging Face Blog5858
Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
 O'Reilly Radar5858
Claude Code 通过 CLAUDE.md 指令、技能、子代理和钩子提供对代码实现过程的详细控制,钩子可解释拒绝操作或返回编译或策略失败,但外部生命周期控制仍需其他层。
 Artificial Analysis Articles6565
VIALS-AA 对 19 模型进行测试,发现 38.3% 的工具调用用于查看图像,47.3% 用于图像准备或测量,而 GPT-6 Astra 和 GPT-6.1 Sol 的图像测量调用率仅为 5-6%,Claude Opus 5.5 和 Claude Sonnet 5.5 则为 25-27%。
 36氪 · AI
美的全屋智能总经理尚喆博士指出,行业卡点在于异构设备数据孤岛、交互效果落差及部署门槛,传统API对接方案因成本指数级上涨难以普及。美的自研家庭智能体MevoX通过AI Agent直接对话实现跨品牌协作,已与奇瑞iCAR完成车家互联,支持模糊意图推理与长期记忆,并与华为、比亚迪等生态伙伴打通。美的作为首个实现家庭智能体A2A协同的家电企业,正推动行业从硬件规模转向Agent推理与跨生态协同效率竞争。
Hugging Face Daily Papers6565SLA 模型通过持续预训练和后训练,将预训练的 VLA 策略与冻结的 3D 感知模型进行空间对齐,使用特征依赖门控和概率状态 dropout 提升跨不同机器人数据的空间理解能力,同时保留推理架构。
 ByteDance Seed · Hugging Face 新模型
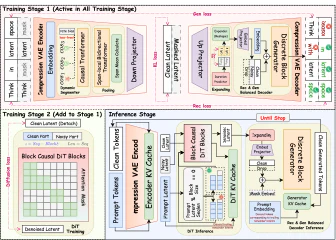
Cola2 是一个连续潜语言模型,结合动态压缩 VAE、块因果扩散 Transformer (DiT) 和跨段因果 token 解码器,动态将文本分组为语义片段,用紧凑的连续潜表示每个片段,生成潜块并实现为离散 token。
Hugging Face Daily Papers6565解耦预测决策架构(DPDM)通过结合冻结的语言模型表示与一个共享的预训练条件预测器,提升了智能体决策的准确性。
36氪 · AI6565英伟达向美国宽带运营商Brightspeed提交方案,计划将老旧电信机房改造成小型AI数据中心,组成覆盖美国20个州的推理网络,该网络预计拥有1吉瓦可用电力。
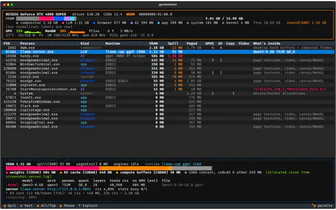
IT之家 · AI微软 GitHub 副总裁斯科特·汉塞尔曼开源 GPU 监控工具 gputaskman,按进程展示 GPU 使用率、显存占用、温度等数据,并识别 LLM 进程显示模型细节,支持 Windows、Linux、WSL 和 Apple Silicon Mac。
 MarkTechPost精选同一件事 · 2 家7171
Thinking Machines Lab 发布第二代 Inkling 的首个模型 Inkling 2 Small,为 594B 总参数、17B 激活参数的稀疏 MoE,支持文本与图像输入和可变推理强度,上下文 1M token。
Hugging Face Daily PapersVFlash 通过 Flash 基元解码实现快速、精确的视觉规划,其轻量级绘图器在单次前向传递中生成整个基元,在 3D 点运动预测任务中速度提升约 25 倍,并在 MolmoSpaces 四个任务套件上达到 70.2% 的平均成功率。
IT之家 · AI同一件事 · 2 家5555webAI 推出 TwIL-8B 推理模型,基于 IBM Granite-4.2-8B 优化数学与代码任务,MATH-500 和 AIME 2025 测试成绩优于 Gemma 4 31B,LiveCodeBench 同组最佳,IFBench 与 Gemma 4 12B 持平。模型推理能力达前沿模型的 88~93%,降低 AI 使用成本但知识储备有限。
IT之家 · AI淘宝 MNN 团队开源 0.3B 手机模型 MNN-Pocket-0.3B,在 iPhone 18 Pro 真机离线跑出 350 token/s。模型峰值内存低于 300MB,解码吞吐超 200 token/s,INT4 部署文件 173MB,英文 IFEval 得分 73.20,中文指令遵循 IFEval-zh 得分 74.59。
 Codex releases00
GitHub Copilot rust-v0.169.0-alpha.1 发布,该版本提供代码审查、协作等功能。
IT之家 · AI同一件事 · 4 家Ricursive Intelligence 发布 Ripple-65B Preview 模型,宣称在美国开放权重模型中拥有最佳智能体编程表现。
 OpenAI News
Cult.fit 正在运用 Codex 协助跨部门团队构建工具、加速工作流程并改变工作方式。
IT之家 · AIAMD 下一代移动 APU Medusa Point 在联想测试系统中跑出 Geekbench 7 单核 1560 分、多核 11575 分,配备 10 核 20 线程(4 Zen 6 性能核+6 Zen 6c 能效核),16MB 三级缓存,支持 AVX-512 等指令集。
Artificial Analysis Articles精选同一件事 · 2 家7272Thinking Machines 发布 Inkling 2 Small,在 Artificial Analysis Intelligence Index v5.0.1 上得分 31,比 Inkling Small 高 18 分,与 Gemini 3.8 Flash (high) 持平。
IT之家 · AI精选7878蚂蚁百灵官方团队发布原生多模态模型 Ling-3.2-flash,拥有 560B 总参数、25B 激活参数和 1M 上下文窗口,支持图像、文本与视频输入。
推荐理由: 原文给出三项基准对比与 API 定价,读者可据此判断这款多模态模型的能力位置与调用成本。
vLLM BlogVeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
IT之家 · AI英伟达提出“全栈协同设计”破解 AI 内存瓶颈,NVFP4 压缩模型权重和 KV 缓存,NVL72 系统分散权重至 72 颗 GPU,Vera CPU 提供缓冲,Dynamo 软件迁移上下文,RAG 索引保留在 CPU 与存储侧。
IT之家 · AI同一件事 · 2 家英伟达公布 Vera CPU 在智能体工作负载上的实测数据,每瓦可支持 1.6 倍数量的智能体,较最快 x86 CPU 每瓦多跑 60% 智能体;Perplexity 和 DeepInfra 等合作方测试显示,Vera 运行智能体编码任务比传统 CPU 快 1.5 倍,智能体编排任务快至多 2.2 倍。
 Ollama releases6565
Ollama 现在支持小米 MiMo V2.6(9B 参数代码与智能体工作流模型),以及 AutoTrust 决策模型(包括 9B、35B 和 27B-VL 版本,35B 和 27B-VL 可处理图像)
MarkTechPost同一件事 · 3 家6262百度发布 ERNIE 5.5 Flash Base,一个 280B 参数稀疏 MoE 基础模型,每 token 激活 14B 参数,支持 128K 训练上下文和 1M 推理上下文。
Codex releases00GitHub Copilot 0.168.0-alpha.7 发布,未公布具体更新内容。
 Browser Use
Claude Code v2.1.159 发布,支持 8k 上下文窗口,在 SWE-bench Verified 上表现优异; Anthropic 推出 Browser Use 开源库,让 AI 智能体通过 Chrome DevTools Protocol 控制浏览器,提供 Browser Use Cloud 和 Browser Use Agents 服务。
NVIDIA Newsroom同一件事 · 2 家5858NVIDIA Vera 处理器在 100 兆瓦数据中心对比中超越最快和最节能的 x86 CPU,实现行业领先智能体速度并提升 1.6 倍每瓦智能体密度。Perplexity 和 DeepInfra 等早期采用者在生产测试中验证了 1.5 倍和 2.2 倍的智能体任务加速。
Hugging Face Daily PapersHalley框架通过预测故障和控制资源提升AI数据中心光学网络的有效吞吐量,减少容量需求,并具备形式化保证。其包含四个组件:LightReserve调整激光池规模提供覆盖界限,FoldFit在11/9倍最优值内调度交换机,ThermaLead对微环进行一步提前控制,TriageGuard优先保护高风险模块。
 SemiAnalysis
Google TPUv7 Ironwood 在 Qwen 3.5 397B FP8 上单次推理性能每美元优于 B200 和 B300 50%,并在多模型 AgentX 基准中展现竞争力或最佳结果,支持 vLLM、SGLang 等生态,但 NVIDIA 对此反应激烈并加速研发。
 The Decoder同一件事 · 3 家
百度发布 ERNIE-5.5-Flash-Base 开源基础模型,含 2800 亿参数,采用混合专家架构,单次输入激活 140 亿参数,预训练覆盖 3350 万亿 tokens,支持高达 128 万 tokens 的训练上下文,推理时上下文最长可达 100 万 tokens。
 Apple Machine Learning Research
苹果在ICML 2026上提出的摊销最大内积搜索通过训练小神经网络学习支持函数,以固定成本理解典型查询匹配方式,实现推理时更快的精确检索。该方法利用ICNN学习支持函数,KeyNet直接输出最佳匹配键向量,均基于实际查询分布构建的监督数据集进行训练,显著提升RAG场景下的检索效率。
 Databricks Blog5858
Databricks 与 Linux Foundation 于 2026 年 6 月宣布 Delta Sharing 升级为 OpenSharing,将共享范围从 Delta Lake 表扩展至包含 Agent 技能。
 Mastra Blog
Mastra 平台和 Studio 现支持追踪每个智能体和模型调用的延迟指标,可通过 TTFC(首次数据块时间)和 TTFT(首次 token 时间)过滤排序追踪、跨度及线程,识别慢速环节。
Codex releases00GitHub Copilot rust-v0.168.0-alpha.5 发布,该版本提供代码审查、协作等功能。