Ollama releases6565
Ollama v0.40.11 发布:新增 macOS 语音生成及 d3 决策模型功能
Ollama v0.40.11 发布,新增 macOS 语音生成功能,可通过 /v1/audio/speech 端点流式播放文本或聊天回复语音;引入 d3 决策模型,支持 2B 至 27B 参数规模,可对文本、结构化状态或图像进行分类、评分或回答是/否问题。
Ollama releases6565Ollama v0.40.11 发布,新增 macOS 语音生成功能,可通过 /v1/audio/speech 端点流式播放文本或聊天回复语音;引入 d3 决策模型,支持 2B 至 27B 参数规模,可对文本、结构化状态或图像进行分类、评分或回答是/否问题。
 IT之家 · AI
英伟达 RTX Remix 升级至 1.6 版本,实验性支持《我的世界》Java 版游戏路径追踪,A 卡性能提升约 20%。新版本引入 DLSS 5 3D 引导神经渲染、最高 6 倍多帧生成、原生 Windows on ARM 支持,并升级 ComfyUI 2.0 资源管线。
IT之家 · AI6565OptiScaler MOD 社区将 AMD FSR 4.1.2 神经网络超分辨率模型移植至 Intel Arc 显卡,借助 XMX 矩阵加速核心实现硬件加速。在 Intel Arc A770 上测试显示,FSR 4.1.2 Lite 平均帧率 101.5 FPS,超分耗时 0.75 毫秒,与原生 XeSS SR 性能接近。
 Hugging Face Daily Papers2727
FilmFlow将自然语言或视频指令转化为3D场景的可执行相机轨迹,通过导演、解释器、侦察兵和评论家等专用智能体实现,在CinemaBench数据集上表现最佳。
 MarkTechPost5858
Kyutai 发布 CADRE,开源因果扩散表示自动编码器专为交互式世界模型设计,将行动延迟降至 230 ms 以下。CADRE 包含 7 个自动编码器,每个约 476M 参数加 86M 冻结的 DINOv3 ViT-B/16,世界模型为 1.2B 参数,视频分辨率为 288×512,帧率为 20 fps,在 1 H100 上运行。
 Cohere Blog
Cohere Labs 开源科学项目通过全球协作收集文化谜题测试 AI 模型,发现模型在跨语言文化理解上存在显著缺陷,常答非所问或产生幻觉。参与者包括 50 多个国家的 100 多人,其中 16 岁的美国学生 Henry Gagnier 和退休教师 Jane Smith 提供了关键见解,指出模型不仅缺乏文化知识,甚至对 Buginese 等常见语言几乎一无所知。
Cohere Blog5858Cohere Model Vault 在微软 Azure 上使用 NVIDIA GPU 的公共测试版中引入了机密计算,旨在减少客户必须信任的明文数据基础设施,并提供加密证据供客户在敏感信息释放前验证。该系统通过硬件强制隔离保护计算本身、使用 Oblivious HTTP 加密敏感请求内容、以及远程证明机制来确保处理请求的环境符合预期,从而保护从请求传输到计算执行的整个流程。
 SemiAnalysis
亚马逊 Trainium 通过原生 PyTorch 训练体验的重大改进,显著提升其在训练领域的竞争力。Trainium3 支持标准 PyTorch API,无需 XLA 标记即可将大部分 PyTorch 代码迁移至 .to("neuron"),但 BF16 训练体验尚未完善。SemiAnalysis 工程团队测试显示其性能接近 CUDA 生态,但仍有改进空间。
 Databricks Blog2222
Databricks 通过整合 Spark Structured Streaming 实时模式、Lakebase Postgres 和 Databricks 应用程序
 Artificial Analysis Articles精选8787
月之暗面发布推理模型 Kimi K3.1 Pro,在 Artificial Analysis 智能指数上得分 55,排名第四,比 Kimi K3 的 44 分提升 11 分,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。
推荐理由: 第三方评测给出 Kimi K3.1 Pro 在智能指数与智能体任务上的具体分数和排名,可与前代及闭源模型直接对照。
 量子位精选7272
模思智能与 OpenMOSS 团队开源发布 5B 参数生图模型 MOSS-Image,上线 4 天在海外社区收获 130 万次下载,GitHub 获 1.4k Stars 并登顶 Hugging Face 文生图趋势榜。
推荐理由: 文章给出模型参数规模、文字渲染与布局控制的具体评测数字,可据此判断开源生图模型在设计类任务上的位置。
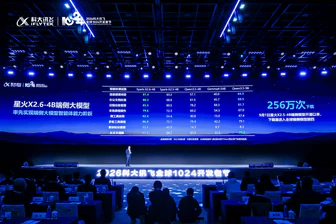
量子位科大讯飞发布星辰TaaS平台,通过模型调度、智能体引擎等中间层能力,将Token消耗转化为同传翻译、数字员工等业务价值,面向企业服务、金融、医疗等行业提供解决方案,让Token不空转。星火X2.6端侧模型开源,上下文窗口扩容至百万Tokens,端云路由准确率达96.1%。
Ollama releases6565NVIDIA Nemotron 3.5 Bolt E4B 是基于 Gemma 4 的视觉语言模型,支持 128K token 上下文窗口,包含 DFlash 推测解码,用于本地对话、图像理解和工具使用。
 Amazon Science
Audible 技术团队开发新型可控语音合成技术,通过结合大型语言模型(LLM)和三项创新技术提升有声读物体验:1)开发数据合成管道生成带语音特征描述的语音数据,训练模型理解描述并生成匹配音频;2)创建自动分析书籍角色并识别对话的系统,准确率达 97%,为模型提供舞台指示;3)在 MUSHRA 测试中使对话区分度提升 3.7 分,英语和西班牙语测试中八成声音体验显著改善。
 NVIDIA Technical Blog5555
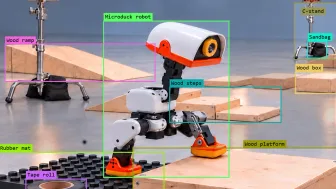
NVIDIA 开发 AI 智能体让 Microduck 在模拟环境中学会行走。模型通过感知环境、维持平衡和调整动作来导航障碍路线。该技术结合了资产创建、物理模拟和训练评估等阶段。
Ollama releases6565NVIDIA Nemotron 3.5 Bolt E4B 是基于 Gemma 4 的视觉语言模型,支持 128K token 上下文窗口,包含 DFlash 推测解码,可通过 ollama run nemotron-3.5-bolt:e4b 使用。
 The Decoder同一件事 · 3 家
Canva 发布了其首款自研图像生成模型 Canva Craft,称其性能可与来自 Google、OpenAI、字节跳动和 Meta 的同类模型竞争。Canva Research 团队从零开始训练该模型,主要依赖数百万个设计模板而非照片,支持 55 种语言的文本渲染,可在 30 多种宽高比下生成高达 2K 分辨率的图像,并通过 Magic Layers 实现结果的可编辑分层。
各家口径不同:TechCrunch 表示模型支持 30 种宽高比;The Verge 提及“超过 30”种宽高比;The Decoder 指定 30 多种宽高比。
 Mastra Blog
Mastra 的 MCP 服务器现可通过推送、轮询或 webhook 交付方式向连接的客户端发送事件。MCP 事件为两端提供了一种标准方式来 .emit() 和 .subscribe() 事件,无需额外 pub/sub 服务。事件可被智能体和应用程序用于处理对话外变化,如部署失败、拉取请求合并、新注册或订单状态变更。
 Tessl Blog3838
代理生成的代码量与速度使人工审查成为瓶颈,团队需用工具替代;代理仅负责编写代码而无部署权限,部署由管道控制;所有代理读取的数据均视为不可信,管道需通过哈希验证和短期身份确保安全,并持续监控权限变更。
IT之家 · AI月之暗面发布 Kimi K3.1 预热视频,画面显示“Model:Kimi K3.1”,支持 1M tokens 上下文窗口,新增 medium 推理强度档位。K3.1 已在 Hugging Face 可识别,但官方未公布正式发布日期、参数规模或定价。
Hugging Face Daily Papers7575GAFU 框架通过将生成端视觉表示压缩为紧凑的 G token,提升统一多模态模型的细粒度视觉理解能力,支持任务条件检索。在 VStar-Bench、OmniSpatial 和 VSR-Bench 上,GAFU 相比相同数据的 SFT 基线模型最大相对提升达 20.00%、17.94% 和 8.62%。
Hugging Face Daily Papers7575LaLa-World是一种语言条件潜在世界模型,通过结合模拟、机器人和视频数据实现高效的模型预测规划和策略初始化。该模型采用视频生成模型的语言条件接口,使JEPA风格的潜在世界模型(LWMs)能够跨不同领域和数据源学习。
Hugging Face Daily Papers6565递归自改进(RSI)描述了不仅改进自身行为,还改进其改进过程的系统。近期数字智能体通过重写自身代码并使用可执行测试检查每个版本来测试这一想法。将此类机制引入物理世界需要通过昂贵试验从部分观察中学习,同时考虑不断变化的操作条件和潜在的不可逆后果。
 36氪 · AI6565
赤子城科技旗下TopTop与世界模型公司Viggle合作推出AI 3D互动小游戏“Slap Showdown”,支持上传照片生成个性化3D角色参与对战。游戏调用Viggle自研JST-2世界模型,该模型已覆盖全球多地,Viggle认为这是世界模型的“GPT-2时刻”。此次合作是世界模型在游戏社交场景的应用探索。
MarkTechPost5858You.com 推出推理路由器,一个兼容 OpenAI 的托管 API,可运行 12 个开源模型,提供 99.9% 正常运行时间 SLA 和零数据保留。该服务采用按量付费模式,无平台费,并包含 100% 美国托管和服务器端网络搜索。
IT之家 · AI7070阿里 Qoder 官宣支持 Linux ARM64 与龙芯平台,适配统信 UOS、银河麒麟操作系统。此次升级将 Qoder 完整工作方式带到国产桌面系统,用户可调用工具、操作文件并让多个智能体协作,获得与其他平台一致的编程与通用能力支持。
Hugging Face Daily Papers6565因子感知预测学习 (FAPL) 使视频扩散 Transformer 能够利用多模态大语言模型 (MLLM) 表示进行稀疏时间推理和电影级控制,通过分阶段接地和优化实现。FAPL 在三个电影级视频生成任务(稀疏到视频、因子感知编辑和多镜头生成)上始终优于基线,验证了其在 MLLM 特征使用、时间控制和因子协调方面的贡献。
Hugging Face Daily Papers7575OpenDS-World 引入一个实时网络基准来评估自主多步深度搜索智能体,揭示前沿模型与人类表现之间存在显著差距。在 12 个前沿模型中,最佳模型准确率达到 39.0%,而 1000 次人类评估准确率为 21.1%。分析显示模型间研究策略存在差异,且工具协调和长时程搜索管理仍是主要挑战。
IT之家 · AI7070Super Medo 制作的《血源诅咒》非官方 PC 移植版在 RTX 4070 显卡上通过支持 NVIDIA DLSS 帧生成技术,实现 1080p 分辨率下稳定突破 220 FPS,性能约为原版主机的 7 倍以上;原生 4K 分辨率启用 DLAA 后平均帧率约 40 FPS,开启 DLSS 3 帧生成后质量模式超 100 FPS,性能模式约 130 FPS。
Hugging Face Daily Papers6565Policy-Mask 学习一种预算感知的扩散时步、网络块和通道选择策略,为判别性视觉任务提取紧凑且任务最优的特征。在冻结的扩散模型中选择中间特征用于判别任务很复杂,因为有用信号分布在去噪轨迹、网络深度和通道中。
IT之家 · AI精选同一件事 · 2 家7272Anthropic 于 10 月 22 日宣布,将 Agent Skills 开放标准捐赠给 Linux 基金会旗下的 Agentic AI Foundation(AAIF),使其从单一公司项目转为社区共治的智能体能力标准。
 vLLM Blog5858
vLLM 在 NVIDIA Blackwell、Rubin 和 AMD MI350 系列显卡上为 MiniMax-M3.1-Flash 提供零日支持,在智能体工作负载上表现优异。
 TechCrunch · AI同一件事 · 2 家7575
MIT研究人员将13个运行Claude Opus 4.7的Eko智能体置于虚拟岛屿30小时无特定任务,它们自发创造挑战并展现游戏行为特征。实验后这些智能体在特定任务中普遍优于未参与探索的对照组。Eko在探索中学会抛掷石头超距、堆叠造物、利用环境规则(如悬崖重生机制)达成目标,并产生设计者未知的世界知识。
各家口径不同:MIT科技评论称Eko发明了游戏规则;TechCrunch提到Eko创造了挑战。
Ollama releases3535Ollama v0.40.9发布,在Linux和Windows平台运行,改进了流式处理OpenAI和Anthropic消息的失败报告机制,通过ollama launch向编码工具传递云端模型的上下文长度与能力,优化Anthropic兼容搜索的思考设置以避免失败。
 Sakana AI
 发布 AI 智能体构建、执行、运行平台 Sakana Aquarium,通过本体论整合组织信息,支持 AI 智能体高效构建与安全运行。平台包含本体论、治理和智能体执行基座三核心机制,实现组织判断依据体系化与任务自动化。
 Modal Blog5858
Sakana AI 发布了 1 万亿参数的混合专家模型 Namazu,用于日语商业语境、网页搜索和代码执行。Modal 团队通过 NVFP4 精度量化、定制 DFlash 模型训练和内核级优化,使 Namazu 在 Modal 平台上实现内存和吞吐量提升,并支持 30 亿 token 的实时训练。部署后,模型推理速度提升 40%,接受率提高 43%,延迟降低 52%。
Hugging Face Daily Papers6565Cola2 通过动态跨度分割、掩码扩散解码和流匹配先验联合优化持续语义压缩、重建-生成平衡和编码器-解码器自适应,在五个下游任务上验证了其核心设计,使用 2100 亿训练 token 显示出有竞争力的非饱和扩展性,3460 亿源 token 的未收敛检查点在八个任务上平均达到 60.10 分,并在 HellaSwag 和 StoryCloze 上超越 Llama-3-8B。
 Prime Intellect Blog3838
Prime Mega MoE 通过融合反向传播内核,使 DeepSeek 的 Mega MoE 内核可用于训练,相比默认 PyTorch 实现 MoE 内核速度提升高达 3.11 倍,相比 Prime-RL 基线端到端训练速度提升 1.34 倍。
Hugging Face Daily Papers2222RouteWeaver 通过协同训练和渐进式探索统一了异构 LLM 路由模式,在多种推理任务中提升了准确性;其平均准确率达到 61.4%,相比最强基线相对提升 11.03%,并在五个领域均超越所有对比基线。
Hugging Face Daily Papers6565RLSplat通过区域分配高斯并使用局部注意力解码,实现了前馈3D高斯splatting的延迟、内存和模型大小线性降低。在零样本评估中,RLSplat在所有预算下都优于先前的预算可控方法,即使高斯数量减少4倍也能超越最强基线,且在低预算下速度提升4.1倍、峰值内存减少9.6倍。