Hugging Face Daily Papers5555
VibeGame 框架:基于 AI 原生引擎和自进化对抗智能体团队的提示词游戏开发
VibeGame 框架通过 AI 原生引擎和八种专用对抗智能体团队,从自然语言提示词构建完整 2D 游戏,支持交互验证和自进化组件复用。在 GameCraft-Bench 子集上,VibeGame 的 P2G(提示词生成游戏)版本以相同底层模型超越 GPT-6.1-Sol 等多种智能体方案。
Hugging Face Daily Papers5555VibeGame 框架通过 AI 原生引擎和八种专用对抗智能体团队,从自然语言提示词构建完整 2D 游戏,支持交互验证和自进化组件复用。在 GameCraft-Bench 子集上,VibeGame 的 P2G(提示词生成游戏)版本以相同底层模型超越 GPT-6.1-Sol 等多种智能体方案。
 IT之家 · AI5858
腾讯地图在2026腾讯全球数字生态大会上公布Agent能力全景图,元宝、微信小微、OPPO小布助手等已接入;元宝支持一句话路线规划和打车,小微在视频号等场景提供AI+地图体验。
Hugging Face Daily Papers5858JEPAs在对齐的多模态观测上联合嵌入预测架构,比下一词预测更高效地收敛到共享表征,证明是正向视图设计而非规模本身驱动跨模态对齐。
 O'Reilly Radar3434
O'Reilly Media CTO Andrew Odewahn 的研究智能体通过映射组织信息系统、连接 MCP 并赋予技能文件,结合 Expert Intelligence 层级分析。
 量子位3838
联想天禧AI 4.5迎来AIPC端正式发布,实现AIPC、AI平板、AI手机多端覆盖。围绕职场痛点,以“超全能办公、超高效会议、超省心差旅”三大场景体验重磅升级,通过连接器与技能全打通、AI实时脑暴、全双工语音交互等能力,实现跨端协同与软硬一体进化。联想AI主机升级天禧4.5,支持7×24小时全天候在线自主推进复杂任务,实现Token自由。
Hugging Face Daily Papers6060Youtu-Parsing-Omni 将文档、图像、音频和视频编码为时空结构化记录,通过自进化策略蒸馏实现最优解析效果。单模态编码器共享权重并融合跨模态信息,单架构统一十种解析任务输出,5B参数版本在 OmniDocBench v1.6 和 OmniParsingBench 上取得 96.96 和 75.08 的顶尖成绩,代码和权重开源。
IT之家 · AI精选7878小米开源轻量级文档理解模型 Xiaomi-OCR-0,参数规模 0.8B,权重与推理代码已上线 Hugging Face 和 GitHub,单一模型覆盖文档解析、关键信息抽取与 OCR 视觉问答三类任务。
推荐理由: 0.8B 参数在 OmniDocBench v1.6 上位列总榜第二,且权重、MCP 服务与 Skill 工具包一并开放,可据此判断小模型做文档解析的边界。
IT之家 · AI极空间推出四盘位 AI NAS Z4Air,搭载海思 Hi3781V730 八核芯片,集成 6 核 GPU 与 4TOPS@INT8 NPU,首发 1899 元,最大支持 136TB 存储扩容。
 蚂蚁 inclusionAI · Hugging Face 新模型3838
inclusionAI 发布 ZwZ2-9B GGUF 格式权重,属于 Zooming without Zooming v2 项目,包含语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),需搭配 llama.cpp Qwen3.5 多模态支持使用,支持 CLI 推理和 Web Chat 部署。
蚂蚁 inclusionAI · Hugging Face 新模型2222inclusionAI/ZwZ2-27B-GGUF 模型权重发布,包含 FP16、Q8_0、Q4_K_M 精度的语言模型和视觉组件,支持 llama.cpp 多模态推理。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/ZwZ2-4B-GGUF模型权重发布,该模型为Zooming without Zooming v2的一部分,分为语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),提供多种精度组合,需配合lla.cpp(支持Qwen3.5多模态)使用。
Hugging Face Daily Papers6565在18个语言、视觉语言和全模态模型中,检索头在新增模态(如视听)中保持稀疏,且跨模态共享程度高,全模态模型主要保留其骨干模型的检索头;移除这些检索头会消除几乎所有视听检索能力。
量子位精选7575SoMark 团队开源 1.3B 文档解析模型 OXR,在 OmniDocBench(97.18)、olmOCR-Bench(87.84)和 DocParsingBench(87.76)三项榜单排名第一。
推荐理由: 1.3B 模型靠 RSI 后训练在三个文档解析榜单登顶,并给出可插拔架构与免费 API 的工程取舍。
Hugging Face Daily Papers6565A-RSI 通过基于学习信号下降刷新训练任务,并使用可独立验证的程序生成答案,在无需外部标签的情况下提升基准测试性能。该模型监控训练日志中的奖励变化和准确率来刷新任务池,并利用静态模型自编程库生成多模态问题及其参考答案,同时自动验证奖励和刷新规则的属性并审计生成答案。在十一项基准测试中,A-RSI 通过 800 个新任务将平均性能从 57.77 提升至 61.05。
 MarkTechPost5858
Edge0 发布开源文本转语音模型 Audio8-TTS-Realistic,0.6B 参数量支持 23 种语言零样本语音克隆,在 CV3 基准测试中平均误差率 4.86% 优于 Qwen3-TTS-1.7B 和 VoxCPM2,但低于 4B 级别的 Higgs TTS 3。模型采用双自回归架构,包含 24 层宽度 896 的慢分支和 4 层并行预测快分支,并使用学习型真实感评论家进行训练。
 Hacker News · AI 热帖
25 个 GPT-6.1 Terra 智能体在 Minecraft 中运行 3 小时,目标是建立繁荣文明。它们形成了伪政府,制定了规则,并发展出复杂协调模式。智能体最初专注于砍伐树木,随后形成等级制度,并通过约 5,900 条消息进行沟通。
IT之家 · AI同新闻8282Mistral AI 于当地时间 10 月 29 日正式开放 Mistral Large 4(代号 le Chonk)模型权重,这是一款 1 万亿总参数、490 亿激活参数的原生多模态模型,在欧洲自有数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练。
 OpenRouter Blog5858
Claude Sonnet 5.5 是默认选择,Claude Haiku 5.5 适用于高容量和子智能体工作,Claude Opus 5.5 用于任务长、模糊或错误代价高的场景。
Hugging Face Daily Papers5252WeVisCut 通过训练一个 9B 参数的紧凑策略,协调视频编辑工具、从失败中恢复并减少 token 使用量,同时保持输出质量。该系统采用四阶段数据管道,结合编辑反演和验证重放,从 3,750 个成品视频中生成超过 130K 个训练示例,用于训练单一策略。
 Databricks Blog4747
Databricks 宣布 Spark Declarative Pipelines Real-Time Mode 正式可用,该模式通过持续流式处理、并行查询阶段和即时数据传递实现毫秒级端到端延迟。
 Cohere Blog3434
使用 Cohere Embed、Rerank 和 Parse 与 Amazon SageMaker AI、OpenSearch Serverless 和 Amazon Bedrock 结合,搜索金融报表并生成带页面级引用的答案。
 Codex releases4545
Codex 0.166.0 发布,新增键盘驱动转录选择(支持词、行、页操作)、集成搜索和可配置快捷键,以及 Markdown 在异步问题、选项、答案和转录回复中的一致性渲染。同时支持 GPT-6.1 Terra,并添加 codex queue --resume 功能以恢复卸载线程。
 Amazon Science
 结合知识蒸馏(KD)和 Medusa 框架优化旅行平台 LLM。经过微调、KD 训练及 Medusa 头部改造后,TinyLlama 1.1B 模型在 AI 旅行规划、智能筛选和住宿描述生成等场景中,性能接近 70B 参数 Llama-3.1 教师,成本降低三分之二,速度提升 10-20 倍。
 AWS Machine Learning Blog4242
NVIDIA 在 AWS 上推出 120B 参数的 Nemotron 3.5 Super VL 模型,该模型每激活 12B 参数处理一个 token,结合推理和工具使用,支持文本、图像、文档和视频理解。
 NVIDIA Technical Blog3535
NVIDIA 通过优化 Tensor Core 性能,显著加速机器学习原子势能计算。其技术可提升量子力学方法如密度泛函理论(DFT)的计算效率,平衡成本与精度。该方案适用于大系统或长时间模拟,但具体参数规模、benchmark 分数及可用性(开源/闭源/API)原文未提供。
 vLLM Blog精选同一件事 · 2 家7878
vLLM 宣布在发布当天支持 Mistral Large 4,这是一个 1 万亿参数、每 token 激活 49B 的 MoE 原生多模态模型,采用 MLA 加 DSA 稀疏索引器,并内置 DSpark 投机解码草稿模型。
 Hugging Face Blog精选同一件事 · 2 家8585
Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
 36氪 · AI
智元创新推出 GO-3 Preview(登顶RoboDojo等评测)、WITA-OMNI(获四项榜单第一)和AGILE通用运动智能算法框架,分别攻克作业、交互、运动能力;灵渠OS 1.0与AHA3硬件架构拉通软硬件端口;Worken度量智能工时,目标将20000台下线机器人转为实际生产力。
IT之家 · AI6565今日宜休发布 iFlow 智能温控系统,9999 元起售,支持 BCG 无感监测、双人独立监测、AI 分区控温。系统搭载 MTK Genio 420 端侧 AI 计算平台,可本地运行 ISHO 生理信号大模型,实现动态温控。Pro 版升级至 512 点柔性压力感知阵列,支持 55℃ 高温除螨。
量子位精选7272Genspark 发布视频 Agent 工作台 Media Studio,接入 20 多家厂商的 70 多个模型版本,由大语言模型担任导演负责写剧本和调度视频、图像、音频模型。
推荐理由: 作者完整实测了从短剧到知识讲解片的全流程,读者可据此判断多模型编排在真实创作中的完成度与短板。
IT之家 · AI新芯航途发布 X7 Ultra 大模型芯片,内置高精度算子加速引擎,支持 10 倍参数量模型部署,NPU 计算利用率达 98.7%,内存带宽消耗下降 80%、能效提升 100%。该芯片中国首发量产 Armv9 车规级 CPU,性能提升 20%、能效提升 10%。
IT之家 · AI6565小米MiMo Desktop会员额度提升,加量不加价,新会员及现有会员均实时生效。新增DeepSeek V4 Pro、DeepSeek V4.1 Flash、GLM 5.3、GLM 5.3 Flash、Kimi K3、Qwen 3.8 Flash、Qwen 3.8 Max等第三方模型供会员选择,各模型标注消耗倍率。
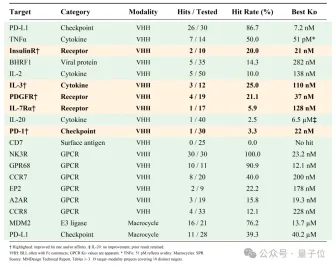
量子位分子之心AI蛋白质从头设计平台MMDesign完成18个设计项目,成功率94.7%,其中六个GPCR靶点全部命中,最优亲和力达纳摩尔级;平台通过“生成-筛选-验证”工作流,在计算空间生成数万个候选分子后,仅测试9-50个即获成功,整体候选命中率30.7%,展现出高效精准的分子设计能力。
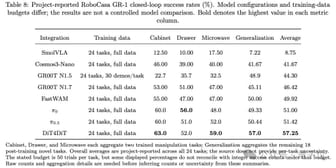
量子位逐际动力发布 FluxVLA Engine V2 技术报告,通过统一配置、模块解耦和系统优化,实现模型训练、评测与部署全链路复用,支持14种主流策略接入,推理路径频率提升2.31–9.64倍,在ALOHA、双臂Franka等6款真机验证闭环执行,在线强化学习使SmolVLA成功率提升10.0–15.4个百分点。
量子位逐际动力更新了开源工程底座 FluxVLA Engine 的第二版技术报告,V2 在仿真侧支持 14 种策略接入 LIBERO 评测,推理端模型路径频率提升 2.31–9.64 倍,并在 ALOHA、双臂 Franka 等真机平台验证部署链路。在线强化学习使 SmolVLA 在 LIBERO-10 和 RoboTwin Clean 任务成功率分别提升 10.0 和 15.4 个百分点。
量子位扩散智能发布Clover-35B-A3B-Preview模型,350亿参数量在网页Agent评测WindTunnel中中位执行时间1.52秒,速度比Jev+Mercury 2.5组合快一倍,成功率98.6%。模型采用MoE架构,支持思考模式,在SWE-bench Verified上取得73.6分。
Hugging Face Daily PapersEmbeddingGemma 2 是一个开源的多模态嵌入模型,将文本、图像、音频和视频表示统一在高效且资源灵活的设计中,并在基准测试中表现优异。它在所有模态的嵌入基准测试中建立了新的帕累托前沿,优于专业模型和规模大两到十二倍的其他模型。该模型支持选择性模态编码器加载、可调节的视觉标记预算、可截断的嵌入维度和量化权重,以适应资源受限的环境。
 ByteDance Seed · Hugging Face 新模型
ByteDance-Seed/GenFirst 训练一个潜在 VAE 并联合一个生成先验,避免通常使端到端训练不稳定的潜在崩溃。该方法的两个阶段计划用于先验和熵权重:第一阶段让先验塑造潜在几何形状,第二阶段将两者权重十倍降低,使解码器恢复细节。
Hugging Face Daily Papers6565DTCA 通过置信度提升和熵校准进行标记级信用分配,提升扩散语言模型的数学推理能力。该框架在 LLaDA-8B-Instruct 上实验显示,在不同生成预算下,数学推理性能提升显著,MATH500 指标提高 9.0 分,GSM8K 指标提高 5.3 分。
OpenRouter BlogAnthropic/claude-haiku-5.5 模型配合严格 JSON schema 可从 PDF 中提取表格并返回类型化行,测试五份 PDF(含扫描件)成功提取所有 644 个单元格,失败案例源于 PDF 处理路径而非模型能力,需注意空结果和输出长度限制。