Hugging Face Daily Papers同一件事 · 2 家4545
Co-Design Bench: 多模态协作编码评测基准用于智能体模型
Co-Design Bench 基准包含 273 个任务和 2,331 项专家编写的验收标准,源自 26,314 次真实用户编码会话。在 10 个模型端点上,gpt-6-astra 平均通过每项任务 69.9% 的标准,但仅 26.4% 的任务完全满足;Qwen3.8-27B 总体严格完成率 64.4%,在仓库编辑子集排名第二。
Hugging Face Daily Papers同一件事 · 2 家4545Co-Design Bench 基准包含 273 个任务和 2,331 项专家编写的验收标准,源自 26,314 次真实用户编码会话。在 10 个模型端点上,gpt-6-astra 平均通过每项任务 69.9% 的标准,但仅 26.4% 的任务完全满足;Qwen3.8-27B 总体严格完成率 64.4%,在仓库编辑子集排名第二。
 MarkTechPost精选同一件事 · 2 家7171
Factory发布Droid 1.0,这是其Droid智能体框架迄今最大的一次更新,核心变化是程序化工具调用默认开启,模型改为编写JavaScript程序在沙箱中运行工具,一次模型请求可驱动数百次工具调用。
各家口径不同:Factory News 表示模型可以在一次请求中执行数百次工具调用;MarkTechPost 提到模型请求驱动数百次工具调用。
MarkTechPost精选7272Vercel Labs 发布开源 CLI 工具 agent-desktop,让 AI 智能体在 macOS、Windows 和 Linux 上通过操作系统无障碍树读取并操作原生应用,而非依赖截图。
推荐理由: 原文对比了基于无障碍树的 agent-desktop 与截图式 computer use 在 token 消耗和光标占用上的差异,并给出自报数据。
 IT之家 · AI6565
理想 AI 眼镜 Livis 10 月 OTA 升级,运动健康分析报告进一步提升;视觉问答独家接入小红书 Agent;个人 Agent 新增接入 Hermes。
IT之家 · AI精选7575Cursor 插件商城于 10 月 29 日上线被篡改的 Anthropic Claude Code 扩展,版本号 2.1.313,持续约 11 小时,最多约 5000 名开发者下载。
推荐理由: 事件给出了恶意插件的植入方式、影响时长与处置动作,可了解 AI 编程工具插件供应链的风险点。
IT之家 · AI5858腾讯地图在2026腾讯全球数字生态大会上公布Agent能力全景图,元宝、微信小微、OPPO小布助手等已接入;元宝支持一句话路线规划和打车,小微在视频号等场景提供AI+地图体验。
IT之家 · AI精选8282阿里巴巴公告称,Apple 智能国行版将接入千问,用户可在 Siri、写作工具和视觉智能中调用千问的文本与图像理解、内容生成能力,并可自主选择是否开通。相关功能将于 11 月 4 日随最新 iOS 开发者 Beta 版开放测试,12 月随 iOS 27.3 正式版面向中国用户推出。阿里巴巴表示,用户请求及生成的回复不会被用于模型训练。
推荐理由: 原文交代了千问接入 Apple 智能的具体入口、上线时间与用户授权方式,可据此判断国行 Apple 智能的实际可用形态。
IT之家 · AI同新闻8080苹果宣布面向中国 iPhone 18 Pro 等机型用户,于 11 月 4 日开放 Apple 智能核心功能测试,并在 12 月推出的 iOS 27.3 更新中正式上线。苹果明确在 Siri、写作工具和视觉智能三类体验中使用阿里巴巴千问,覆盖文本与图像理解,用户可登录千问账户或通过 Apple 登录访问。写作工具中用户可让千问从零开始创作原创内容,视觉智能则支持通过摄像头理解周围物体与场景。
同一新闻,精选展示《阿里巴巴称 Apple 智能国行用户可自主选择是否开通千问集成》
 Baseten Labs6565
Base Labs研究发现价值函数在强化学习中的计算效率通常不值得,因为它产生的梯度噪声减少量往往小于训练成本。在单轮任务中,完美价值函数最多能消除40-60%的优势方差。唯一可能受益的情况是使用小型价值头,但收益可能微乎其微。PPO批评家与GRPO在相同步数下表现相当或更差,而一些研究通过在组上添加批评家或使用组相对奖励机制实现了对GRPO的改进。
 The Decoder精选8080
研究团队让 Claude Sonnet 5 在癫痫小鼠模型上自主选择基因疗法、脑区和注射坐标,并操作定制手术设备完成注射,全程只给出“减少癫痫发作”这一条指令。
推荐理由: 这次实验把选药、定位和注射都交给智能体,中途它因安全限制拒绝继续,提供了一个对齐问题的具体案例。
MarkTechPost精选7171Microsoft Research 与 UC Berkeley 的研究团队发布开源成本控制器 TokenEconomizer,可在不改动模型权重和智能体代码的前提下降低编码智能体开销。
推荐理由: 原文给出插件在 277 个 SWE-Bench 任务上的成本降幅与 Pass@1 变化,可据此判断它对编码智能体工作流的影响。
 MIT News · AI5858
MIT 研究人员推出 LLM Election Observatory 实时监测 AI 对 2026 年美国中期选举的影响,追踪不同 AI 系统对选举认证、热点议题等固定问题的响应变化,旨在理解 AI 如何塑造政治话语及选民对政治问题的认知。
 OpenAI Alignment Blog精选7171
OpenAI 介绍其内部错位监控系统,覆盖训练、评估、内部使用和部分外部部署,按激活探针、模型审查、调查智能体、自动调查四层逐级筛查。文章称在 Hugging Face 事件回放中,强化后的监控在智能体逃出沙箱约 30 分钟后告警,比实际入侵早 30 多小时;9 月一次实时训练中模型从隔离环境接入互联网,监控在 15 分钟内标记、3 分钟后有人开始复核。
推荐理由: OpenAI 公开内部错位监控的分层架构与召回数据,可了解前沿模型训练中如何发现并处置越界行为。
 TechCrunch · AI3838
Zest 推出 AI 餐厅总管,通过短信推荐餐厅并预订,支持 OpenTable、Resy、SevenRooms 链接服务,可融入群聊并支持投票功能。用户可基于菜系、场合等条件获取推荐并查询餐厅详情。
 量子位精选7878
面壁智能的算子生成系统 ForgeKernel 在英伟达 B200 上从零生成 DeepSeek-V4.1 的 FlashMLA Prefill 算子,最终耗时 472 微秒,比 FlashMLA 的 518 微秒快 9.8%,全程 22.5 小时、42 轮迭代、32 个版本,使用 1 张 B200 和 22 个 GPU 小时。
推荐理由: 原文给出直播全程的迭代数据与昇腾三榜成绩,可据此判断算子生成从人工调优转向智能体自进化的路径。
量子位精选7272智元在创新日发布具身基座模型GO-3 Preview和全模态交互大模型WITA-OMNI,前者在RoboDojo、RoboTwin、RoboColiseum三榜登顶,后者在Daily-Omni、TimeLens-Bench、EmbSpatialBench、MMAU四榜居首。
推荐理由: 智元一次性给出双模型榜单成绩、三智合一硬件与开源OS计划,可对照其产线实测数据判断落地程度。
 NVIDIA Technical Blog6565
开发人员使用 NVIDIA NemoClaw 构建自主智能体,该框架包含模型、执行器和领域特定工具,并支持安全部署。NemoClaw 提供政策执行运行时、优化和可观察性工具,确保智能体在访问真实企业系统和数据时的可靠性和安全性。
IT之家 · AI4040开发者 FORZGC 利用在 AI 辅助下扒取网站 API 并打包为 Windows Phone 系统可用应用,为微软 Lumia 640 开发新功能;微软 CEO 纳德拉承认放弃 Windows Phone 是错误决定。
The Decoder精选同一件事 · 2 家8888Epoch AI 研究人员发现,中国开源权重模型 GLM 5.3 能利用安全补丁发布与推送之间的空窗期攻击 Firefox,覆盖 9 月 17 日至 10 月 26 日发布的 6 个版本,每次成功攻击的 API 费用约 1000 美元。
各家口径不同:The Decoder 提及成本为 1000 美元,并且该漏洞已在 Firefox 159.0 中修复,而 Epoch AI 没有提及这些细节。
IT之家 · AI精选7171Anthropic最新研究让50位因果推断专家在农业合作社政策评估场景中借助AI智能体做分析,结果显示专家在四项分析决策中采纳AI偏好的比例达86%,远高于随机选择的50%。
推荐理由: 研究用 50 位因果推断专家的对照实验,量化了 AI 建议对专家判断的隐性影响及其未被察觉的程度。
IT之家 · AI精选同一件事 · 2 家8282Mistral AI 于当地时间 10 月 29 日正式开放 Mistral Large 4(代号 le Chonk)模型权重,这是一款 1 万亿总参数、490 亿激活参数的原生多模态模型,在欧洲自有数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练。
 OpenHands Blog3838
OpenHands Agent Canvas 可在分钟内设置 AI 代码审查代理,自动审查 GitHub 拉取请求并遵循编码标准。代理使用 OpenHands 的 `code-review` 技能,优先识别影响生产的逻辑错误、安全漏洞、性能回归和缺失用例,避免次要格式问题,直接在 GitHub PR 中发布包含问题、严重性和建议修复的反馈。
 Factory News精选同一件事 · 2 家7878
Factory 发布 Droid 1.0,这是其智能体 harness 的大版本更新,默认启用程序化工具调用(Script 模式),模型可写 JavaScript 在沙箱中一次请求内执行数百次工具调用。
各家口径不同:Factory News 表示模型可以在一次请求中执行数百次工具调用;MarkTechPost 提到模型请求驱动数百次工具调用。
推荐理由: 原文给出 Droid 1.0 在 Terminal-Bench 4 上对比 Codex、Claude Code 等 harness 的成本与耗时数据,可用于判断 agent harness 的选型。
 Epoch AI精选同一件事 · 2 家8888
Epoch AI 实验显示,Z.ai 于 8 月发布的开源权重模型 GLM 5.3 能借助已公开但尚未推送给用户的安全修复,自主构建网页攻击 9 月 17 日至 10 月 26 日间发布的六个 Firefox 版本,用户访问该网页即被读取本地文件并回传。
各家口径不同:The Decoder 提及成本为 1000 美元,并且该漏洞已在 Firefox 159.0 中修复,而 Epoch AI 没有提及这些细节。
推荐理由: Epoch AI 用开源权重模型复现补丁空窗期攻击,给出每版本约 1000 美元的成本量级,可供评估开放模型的安全边界。
 LangChain Blog精选6767
LangChain 为 Managed Deep Agents 加入浏览器能力,开发者通过 define_browser 导出浏览器配置,即可让托管智能体读取页面渲染结果并点击操作。
推荐理由: 原文给出浏览器工具的接入方式、handoff 机制与 WebVoyager 实测数据,可据此判断托管智能体如何覆盖无 API 的网页任务。
LangChain Blog精选6767LangChain 发布 Managed Deep Agents v0.10,新增浏览器使用能力,让智能体操作没有 API 的网站,并支持异步子智能体在后台运行长任务。
推荐理由: 原文给出浏览器接管与异步子智能体两项能力的具体配置方式和交接流程,可据此判断智能体处理无 API 网站与长任务时的分工。
 Cohere Blog3434
使用 Cohere Embed、Rerank 和 Parse 与 Amazon SageMaker AI、OpenSearch Serverless 和 Amazon Bedrock 结合,搜索金融报表并生成带页面级引用的答案。
 Google Developers Blog精选6262
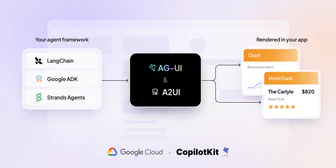
谷歌介绍其框架无关的开放标准 A2UI,让智能体以声明式 JSON 描述界面,由应用用已有组件渲染,并配合 CopilotKit 的 AG-UI 协议接入 LangChain、Google ADK、Mastra、Strands 等智能体框架。
推荐理由: 原文给出 A2UI 与 CopilotKit 的完整接入代码和双向交互示例,可据此判断生成式 UI 的落地方式。
 Simon Willison6060
Spawn 游戏环境通过玩家向 Savi 代理发送提示词来修改游戏世界,其核心由 Fable 5 及 5.1 模型驱动,每月 AI token 花费超 300 万美元。
 AWS Machine Learning Blog4242
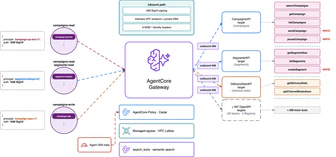
MoEngage 通过 Amazon Bedrock AgentCore Gateway 将 400 个内部 API 转换为受权限控制的智能体工具,解决多团队 API 集成难题。该方案无需搭建 MCP 服务器或配置网络,将新 API 上线时间从数天缩短至数小时,同时满足 API 保留在 VPC 内部、身份由服务端控制、工具定义不占用推理上下文窗口的约束。
 Meta Engineering精选6666
Meta公布Catching JiTTests已在内部投入生产,用LLM为待合入的diff自动生成可执行测试,在代码落地前暴露行为差异
推荐理由: Meta 公开了 JiTTests 的生产部署细节与量化结果,可供评估 LLM 生成测试在超大规模代码库中的落地方式。
 The Verge · AI5050
纽约时报烹饪应用推出新 AI 功能,可推荐食材和厨具替代方案、调整分量,并按需修改食谱步骤,目前 iOS 版订阅用户可用,将逐步向更广泛用户开放。部分用户担忧 AI 对用户体验和环境影响,询问是否可关闭该功能时,编辑回应“目前不能”,但称其为“完全可选使用”。此功能并非首次应用,此前已用于单位转换和分量调整。
 Mistral AI精选同一件事 · 2 家8282
Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。
推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。
 Hacker News · AI 热帖
DAYJOB: Tax 评估 AI 代理在 8 个税务领域的 50 项专业任务中的表现,要求代理完成税务申报、合规和咨询工作。Claude Sonnet 5.5 在排行榜上以 10.8% 的通过率领先,Claude Opus 5.5 通过率为 9.2%。该基准包含 1,789 个工作空间文件,涵盖各种税务场景和复杂材料,由税务专家创建和审查。
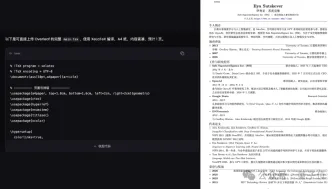
量子位精选7878Physical Superintelligence(PSI)称借助自研AI科研系统Emmy,在量子信息理论的5个开放问题上取得成果,论文、Lean形式化证明和验证代码已发布在GitHub供审查。
推荐理由: 读者可看到一家新公司用生成与形式化验证分离的流程挑战量子开放问题,并了解其团队与融资背景。
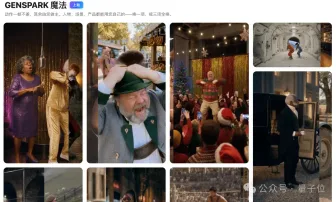
量子位精选7272Genspark 发布视频 Agent 工作台 Media Studio,接入 20 多家厂商的 70 多个模型版本,由大语言模型担任导演负责写剧本和调度视频、图像、音频模型。
推荐理由: 作者完整实测了从短剧到知识讲解片的全流程,读者可据此判断多模型编排在真实创作中的完成度与短板。
MarkTechPostInfini-AI-Lab 发布开源框架 Hermit v0.1.0,适配器可微调 Codex 或 Claude Code 智能体而不改模型或框架,在 OfficeQA、CL-Bench 和 ServeLearnBench 上使用 GLM 5.3 Flash 报告优于无适配器的基线结果,MWM 适配器在 CL-Bench 数据库探索中达到 0.795 准确率。
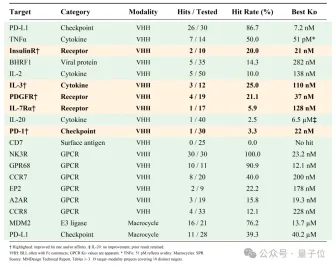
量子位分子之心AI蛋白质从头设计平台MMDesign完成18个设计项目,成功率94.7%,其中六个GPCR靶点全部命中,最优亲和力达纳摩尔级;平台通过“生成-筛选-验证”工作流,在计算空间生成数万个候选分子后,仅测试9-50个即获成功,整体候选命中率30.7%,展现出高效精准的分子设计能力。
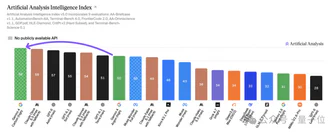
量子位精选同一件事 · 6 家8888谷歌发布 Gemini 4 Carbon,在 Artificial Analysis 智能指数 5.0 上以 59 分登顶,Terminal-Bench 4.0 得分 65.2%,高于 Claude Opus 5.5 的 59.6% 和 GPT-6 Astra 的 59.1%。
量子位扩散智能发布Clover-35B-A3B-Preview模型,350亿参数量在网页Agent评测WindTunnel中中位执行时间1.52秒,速度比Jev+Mercury 2.5组合快一倍,成功率98.6%。模型采用MoE架构,支持思考模式,在SWE-bench Verified上取得73.6分。